
流媒体与实时通信 / 系统课时
容灾演练如何验证故障恢复目标
容灾演练如何验证故障恢复目标
不要用“切换成功”作为容灾演练的结论。真正要验证的是故障从发生到用户恢复各用了多少时间,以及推流、播放和业务状态是否按预期恢复。本篇给出可直接执行的三类演练与 RTO 验收口径。
学习目标
- 能为源站停机、推流入口不可用、区域网络异常设计可重复的演练场景。
- 能记录发现、切换、首帧恢复和完全恢复时间,并计算 RTO。
- 能根据实测结果判断高可用方案是否达到目标,而不是只看节点是否自动接管。
先把恢复目标写成可测指标
RTO 是故障发生后,服务恢复到约定可用状态允许消耗的最长时间。对直播系统,不能只记录“服务恢复”,建议至少记录四个时间点:故障注入、监控发现、流量切换、观众首帧恢复。若还需要业务完全恢复,再记录控制面和历史状态恢复时间。
例如目标 RTO 为 60 秒,演练中 14:00:00 注入故障,14:00:12 被监控发现,14:00:24 完成入口切换,14:00:41 首帧恢复,则面向观众的实测恢复时间为 41 秒,满足 60 秒目标;若 14:01:08 才恢复,则超出目标 8 秒,即使节点切换本身只用了 24 秒也不能判定演练通过。
建议同时记录“观众中断时长”,因为 RTO 与用户体验不是同一个指标。一次切换可能在 30 秒内完成,但播放器还要等待关键帧,实际黑屏时间仍可能更长。
设计三类故障场景
每个场景都应先定义注入条件、保护动作、恢复判定和通过标准,并确保一次只改变一个主要故障变量。
| 场景 | 故障注入 | 重点观察 | 示例通过标准 |
|---|---|---|---|
| 源站停机 | 停止当前主源站服务 | 健康检查、摘除、主备切换、首帧恢复 | RTO ≤ 60 秒,恢复后无持续 5xx |
| 推流入口不可用 | 将 ingest-A 标记为不可用或阻断其新连接 | DNS/LB 摘除、客户端重连、推流恢复 | 新推流切到健康入口,95% 会话在 30 秒内恢复 |
| 区域网络异常 | 模拟 AZ/区域之间丢包或不可达 | 跨区接管、回源路径、播放连续性 | 关键流量在 60 秒内切离故障区域 |
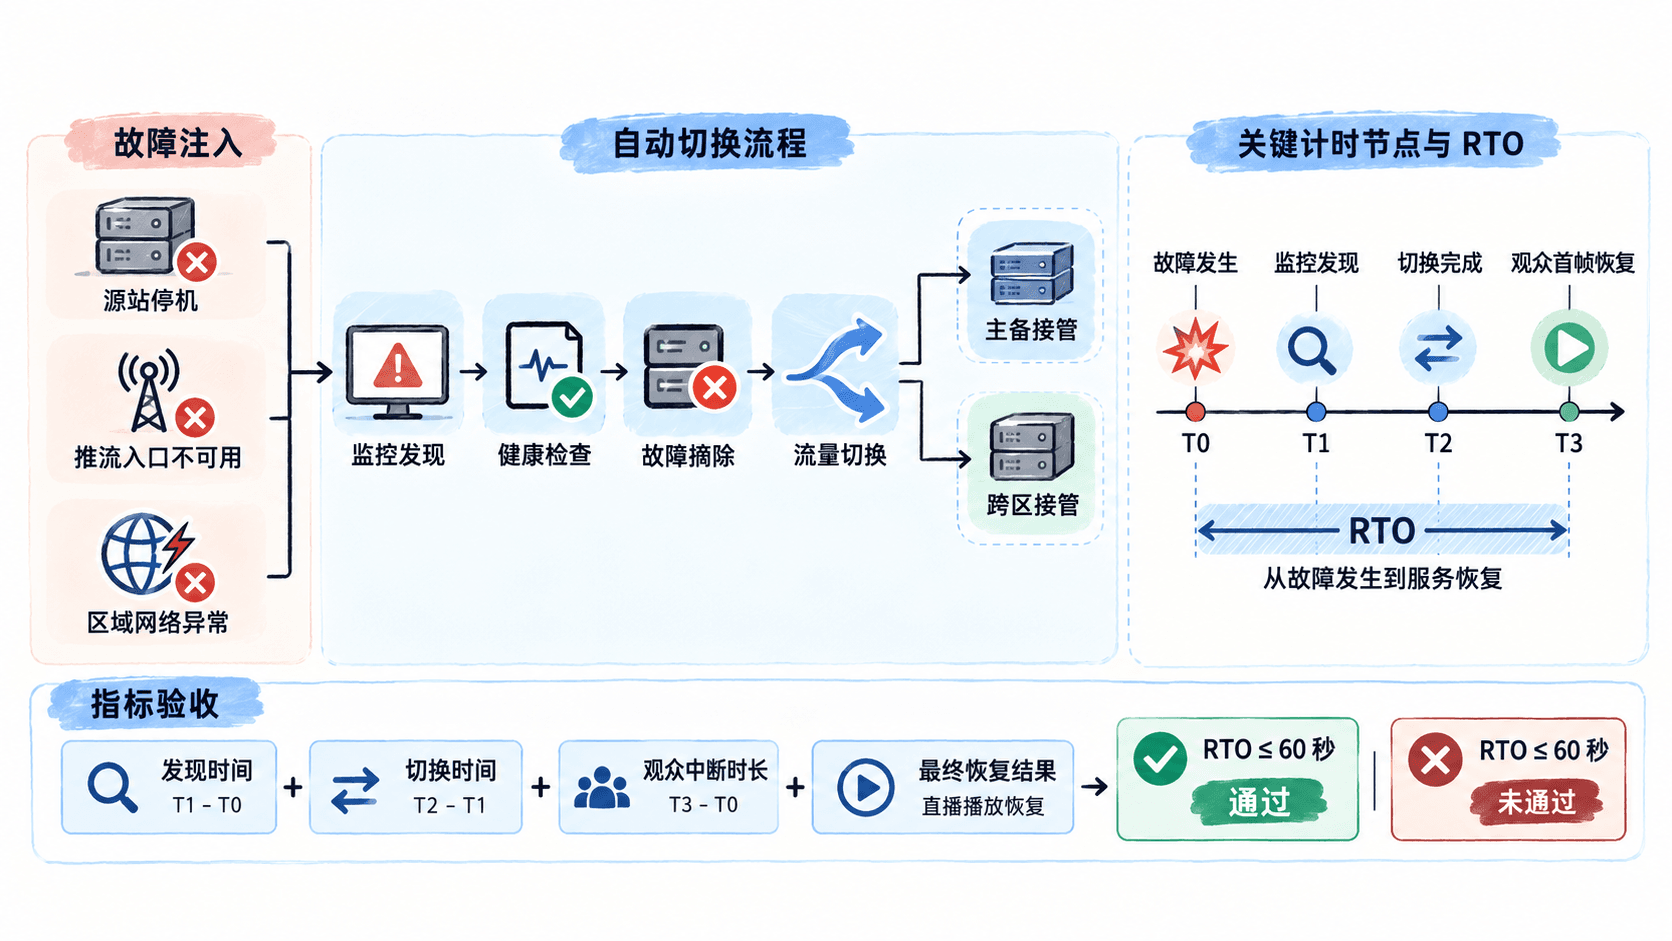
按统一时间线记录结果
演练开始前先建立同一时钟来源,并给监控、负载均衡、源站和播放器日志统一时间基准。记录时不要用“很快恢复”这类描述,而应保存具体时间戳。
- 在
$T_0$注入故障,并记录故障类型和影响范围。 - 在
$T_1$记录第一条有效告警,得到发现时间 。 - 在
$T_2$记录流量已经切到健康节点的时间,得到切换时间 。 - 在
$T_3$记录代表性观众恢复首帧的时间,得到观众中断时长 。 - 检查推流、播放、鉴权、录制等关联能力是否都恢复,再决定演练是否结束。
例如一次源站停机演练得到:发现 12 秒、切换 18 秒、播放器等待关键帧 9 秒,因此观众从故障到首帧恢复共 39 秒。此时不能把“切换 18 秒”直接当成系统 RTO。
用结果判断方案是否达标
建议把通过条件写成“时间目标 + 功能目标”两部分。时间目标例如 RTO ≤ 60 秒;功能目标则至少检查推流重新建立、播放列表可访问、媒体分片连续、鉴权仍有效、录制任务没有产生不可恢复的孤儿片段。
常见错误是只验证自动切换,例如看到主源站变红、备源站变绿就宣布通过。正确做法是在切换后继续观察真实业务路径:推流端是否重新发布、播放器是否获得新流、首帧是否回来,以及旧节点恢复后是否出现错误回切。
另一个常见错误是只做一次演练。至少重复同一场景两次,并比较发现时间和恢复时间的最大值;例如两次首帧恢复分别为 41 秒和 53 秒,那么虽然平均值是 47 秒,但按“单次必须 ≤ 60 秒”的目标仍然通过,同时应继续调查第二次变慢的原因。容灾设计最终应以最差实测结果和明确的用户恢复标准验收,而不是以架构图上的“有主有备”验收。