
流媒体与实时通信 / 系统课时
推流频繁断开如何定位故障节点
推流频繁断开如何定位故障节点
推流频繁断开时,不要先重启源站或提高超时阈值。先把断开时间、关闭原因、RTT、丢包、入口负载和源站连接状态对齐,就能判断问题是在主播网络、传输协议还是服务端主动关闭。
学习目标
- 能用时间线区分主播侧网络异常、协议超时和服务端主动断开。
- 能结合 RTT、丢包率、连接关闭原因和入口负载定位最可能的故障节点。
- 能完成一次从证据采集、根因判断到修复验证的排障闭环。
先把一次断开记录完整
同一个用户连续断开时,最有价值的不是“断了几次”,而是每次断开前后的同一时间窗口。建议以断开时刻前后 10 秒作为排查窗口,把客户端、入口网关和源站日志统一到毫秒级或至少秒级时间戳。
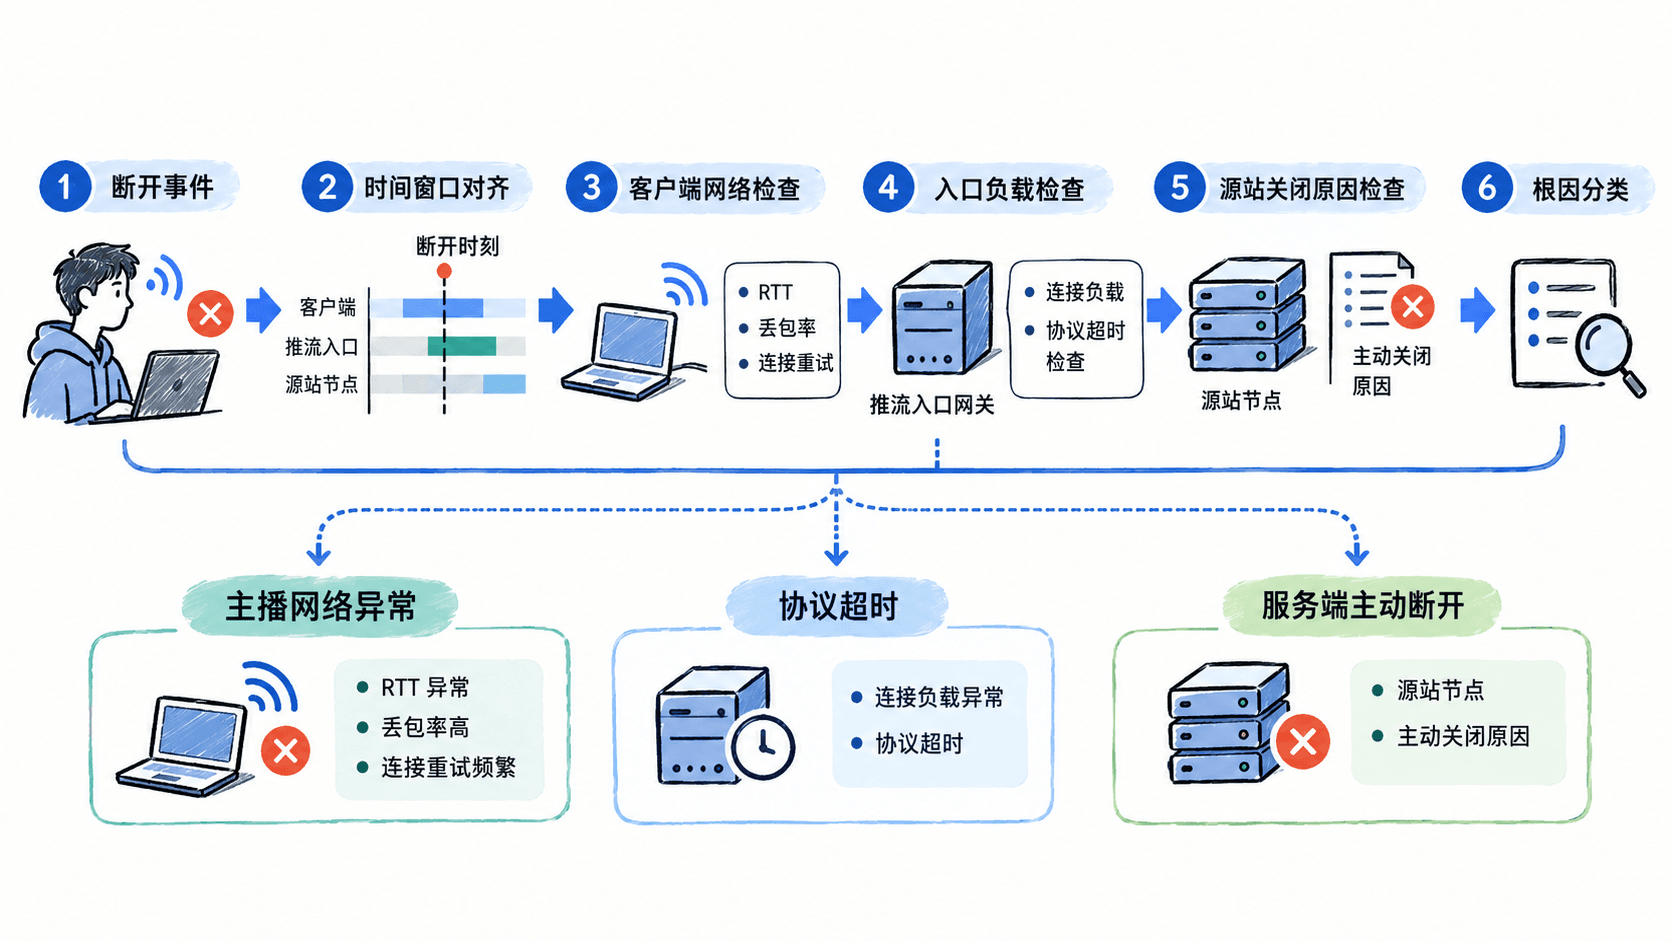
建议至少保留以下字段:disconnect_time、close_reason、remote_addr、rtt_ms、packet_loss_pct、ingest_node、active_connections、source_state。其中 close_reason 必须区分客户端主动关闭、网络断连、协议超时和服务端拒绝/关闭,不能全部归并成 disconnect。
例如 20:15:31 发生断流时,如果客户端在 20:15:25~20:15:31 的 RTT 从 35 ms 升到 280 ms、丢包从 0.1% 升到 6%,而入口节点连接数只占限额 55%,源站日志没有主动关闭,那么优先怀疑主播侧链路,而不是扩容源站。
用 RTT 和丢包先筛主播网络
RTT 主要反映往返时延,丢包则直接影响 TCP/RTMP 等基于可靠传输协议的吞吐和重传。排查时不要只看平均值,应该同时看峰值、连续异常持续时间以及断开前后的变化。
一个可操作的经验窗口是:先看断开前 10 秒;若 RTT 在正常区间之外持续升高,并伴随明显丢包,再与同时间入口节点上的其他主播对照。只有单个主播异常时,用户侧链路的嫌疑更高;同一入口上大量连接同时异常,则应转向入口或上游网络。
在 Linux 主机上可以直接查看到目标地址的连续时延与丢包统计。<HOST> 用实际入口域名或可达地址替换,<COUNT> 用本次采样次数替换。
ping -c <COUNT> <HOST>预期结果
64 bytes from <HOST>: icmp_seq=1 ttl=52 time=34.7 ms
64 bytes from <HOST>: icmp_seq=2 ttl=52 time=36.1 ms
...
--- <HOST> ping statistics ---
<COUNT> packets transmitted, <RECV> received, <LOSS>% packet loss
rtt min/avg/max/mdev = <MIN>/<AVG>/<MAX>/<MDEV> ms
如果丢包从 0% 上升到 5% 以上并且只发生在一个主播,先检查主播接入网络、Wi-Fi/移动网络切换、运营商链路和本地防火墙。不要因为 RTT 短暂升高就直接修改服务端超时,超时阈值无法修复真实丢包。
再看入口是否把连接主动踢掉
如果多个主播同时在相近时间断开,入口节点的连接数、CPU、网络带宽以及连接队列更值得关注。尤其要检查负载是否已经进入保护区,例如连接数接近配置上限、文件描述符耗尽、事件循环持续高负载,或入口健康检查开始摘除节点。
定位时把断开时间与入口日志放在同一个时间轴上。下面的最小命令示例用于按关键词快速筛选入口日志,适用于文本日志中包含固定字段的 Linux 环境。
grep -E 'disconnect|timeout|too many connections|overload' <PATH> | tail -n 50预期结果
2026-10-25T20:15:31Z ingest-A disconnect stream=<ID> reason=client_timeout
2026-10-25T20:15:32Z ingest-A reject stream=<ID> reason=too_many_connections
2026-10-25T20:15:33Z ingest-A disconnect stream=<ID> reason=overload
若日志同时出现 too_many_connections、overload,并且多个主播共享同一入口节点,可以把故障节点锁定到入口层;若只有某个连接出现 client_timeout,则还不能直接下结论,需要继续核对客户端网络与源站状态。
一个常见误判是看到连接数 90% 就认定“入口过载”。90% 本身不是根因,必须结合拒绝日志、CPU、带宽或事件循环延迟确认资源是否真的达到保护阈值。
最后确认是不是源站主动断开
当客户端网络基本正常、入口也没有明显过载时,应检查源站是否主动关闭连接。重点找 idle timeout、鉴权失败、流状态不合法、服务实例重启、进程资源耗尽以及上游依赖失败等原因。
判断服务端主动断开时,至少满足两个证据:一是源站在断开时刻附近存在明确关闭日志;二是同一连接的客户端时间线与服务端日志能通过 <ID> 或连接标识对应。只有客户端报告“连接被关闭”,不能单独证明是服务端主动关闭。
例如源站在 20:15:31 记录 close reason=auth_expired,客户端同一时刻记录 TCP 连接被关闭,且客户端 RTT 和丢包正常,那么根因应归入服务端业务/鉴权链路,而不是主播网络。
| 证据组合 | 优先结论 | 下一步 |
|---|---|---|
| 单主播 RTT 高、丢包高,入口正常,源站无主动关闭 | 主播网络异常 | 检查接入网络与链路 |
| 多主播同时断开,入口连接数/资源逼近上限 | 入口过载或保护 | 检查连接限制、CPU、带宽和摘除日志 |
| RTT/丢包正常,源站出现明确 close reason | 服务端主动断开 | 检查鉴权、超时、资源与实例状态 |
| RTT 波动、无明显丢包,等待固定时长后断开 | 协议超时可能性高 | 核对 keepalive、读写超时和心跳 |
用最小复现验证根因
定位完成后,不要只看监控恢复就结束。应在修复后主动建立一条测试推流,连续运行至少 10~15 分钟,并验证断开次数为 0;同时确认入口连接数、RTT 和源站关闭原因回到正常状态。
若怀疑协议超时,先确认服务端和客户端的心跳/保活设置确实生效,再做一次受控测试。不要直接把超时时间从 30 秒改成数小时,因为超时过大可能让失效连接长期占用连接槽位。
最终可以把一次完整故障压缩成三层证据:谁在什么时候断开、哪一层留下了关闭证据、修复后同类连接是否恢复稳定。只要这三项能对应起来,就不会把主播网络、协议超时和服务端主动断开混成同一种“推流不稳定”。