
计算机网络 / 系统课时
理解 HTTP/2 多路复用
理解 HTTP/2 多路复用
HTTP/2 解决的核心问题,是浏览器如何在一条连接上并行处理多个请求,而不必为每个资源反复创建连接。本课将从二进制分帧、流与帧的关系入手,说明多路复用为什么能提升页面加载效率,以及它仍然受 TCP 丢包影响的原因。
学习目标
- 理解 HTTP/2 中连接、流、消息和帧的层级关系
- 说明多个请求如何在同一条 TCP 连接中交错传输
- 区分 HTTP/2 多路复用与 TCP 队头阻塞
HTTP/1.1 为什么需要多条连接
浏览器打开一个网页时,通常要同时获取 HTML、CSS、JavaScript、图片和字体。HTTP/1.1 虽然支持持久连接,但一条连接上的请求与响应往往仍按顺序处理。前面的响应较慢,后面的资源就可能等待。
为了提高并发度,浏览器通常会对同一站点建立多条 TCP 连接。这样可以并行下载资源,却会增加握手、拥塞控制和连接管理成本。HTTP/2 的目标不是简单地“建立更多连接”,而是让一条连接能够承载多个独立请求。
二进制分帧是多路复用的基础
HTTP/2 会把请求和响应拆成更小的二进制帧。每个帧都带有流标识,接收方可根据流标识把帧重新组合成原来的消息。
一条 HTTP/2 连接中可以同时存在多个流。客户端发送流 1 的请求头后,不必等它完整返回,就可以继续发送流 3、流 5 的请求。服务器也能把不同流的响应帧交错写入同一条连接。
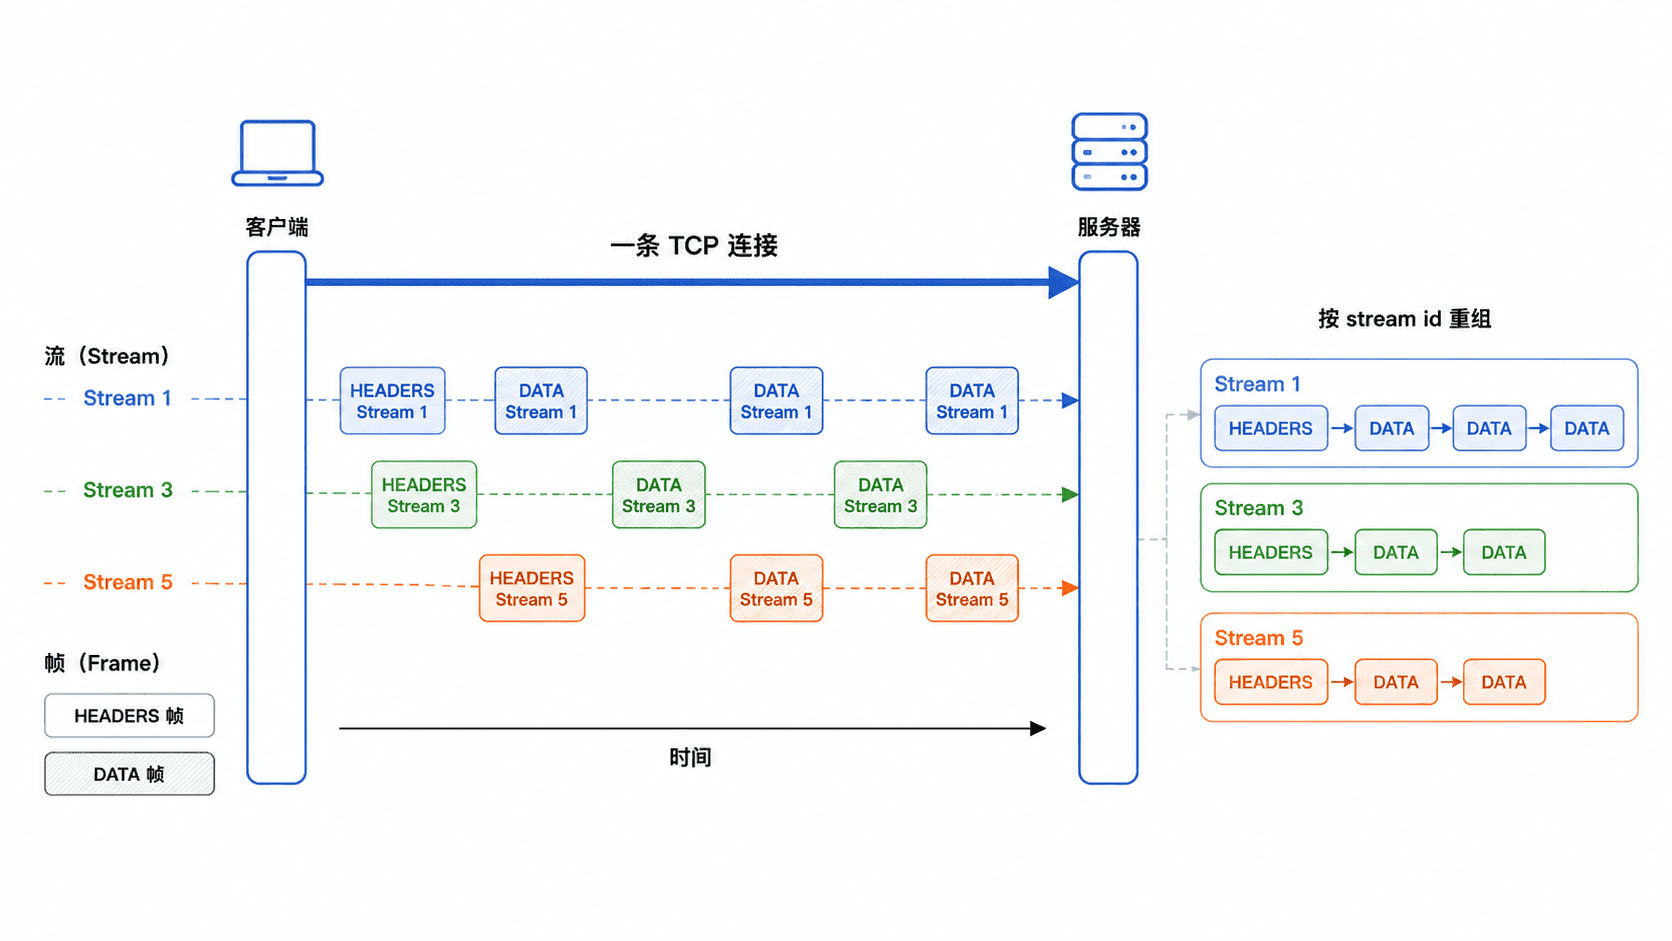
这里有四个容易混淆的概念:
- 连接:客户端与服务器之间的一条 TCP 连接。
- 流:一次双向的逻辑请求与响应通道,具有唯一流标识。
- 消息:完整的 HTTP 请求或响应。
- 帧:HTTP/2 传输的最小协议单位,例如
HEADERS帧和DATA帧。
多路复用真正并行的是逻辑流。底层字节最终仍要经过同一条 TCP 连接发送。
头部压缩减少重复数据
HTTP 请求头经常包含重复字段,例如 User-Agent、Cookie 和 Accept。如果每次请求都原样发送,会产生较多冗余。
HTTP/2 使用 HPACK 压缩请求头和响应头。通信双方维护动态表,对重复字段使用索引表示,从而减少传输字节。它与多路复用解决的问题不同:多路复用提高并发利用率,头部压缩减少协议开销。
多路复用仍受 TCP 队头阻塞影响
HTTP/2 消除了 HTTP/1.1 请求层面的排队问题,但没有改变 TCP 必须按序交付字节的规则。假设某个 TCP 数据包丢失,即使其中只包含流 1 的部分数据,后续已经到达的流 3、流 5 数据也要等待丢失数据重传完成。
因此,HTTP/2 的多路复用不是“任意一个流丢包都不影响其他流”。它解决的是 HTTP 层的并发问题,却仍可能遇到 TCP 层的队头阻塞。这正是 HTTP/3 改用 QUIC 的重要原因。
如何判断是否使用 HTTP/2
在浏览器开发者工具的网络面板中,可以查看请求的协议列。常见值 h2 表示 HTTP/2,http/1.1 表示 HTTP/1.1。即使页面使用 HTTP/2,也不代表每个资源都有独立物理连接;多个资源通常共享同一条连接。
提示:HTTP/2 仍然使用 HTTPS 场景最常见。协议协商通常由浏览器与服务器自动完成,应用代码一般不需要手动为每个请求创建流。