
计算机网络 / 系统课时
理解 URL 与网页资源
理解 URL 与网页资源
本课把一条常见 URL 拆成可识别的组成部分,帮助你判断浏览器要使用什么协议、连接哪台主机、请求哪个资源,以及查询参数和页面片段分别会影响什么。
学习目标
- 识别 URL 中协议、主机、端口、路径、查询参数和片段
- 理解各部分在资源定位和请求过程中的职责
- 区分绝对 URL、相对 URL 以及容易混淆的边界
URL 为什么需要分段
URL 是资源的定位描述。浏览器读取 URL 后,需要先确定通信协议和目标主机,再找到具体路径,并根据查询参数请求不同结果;片段则用于定位资源内部的位置。
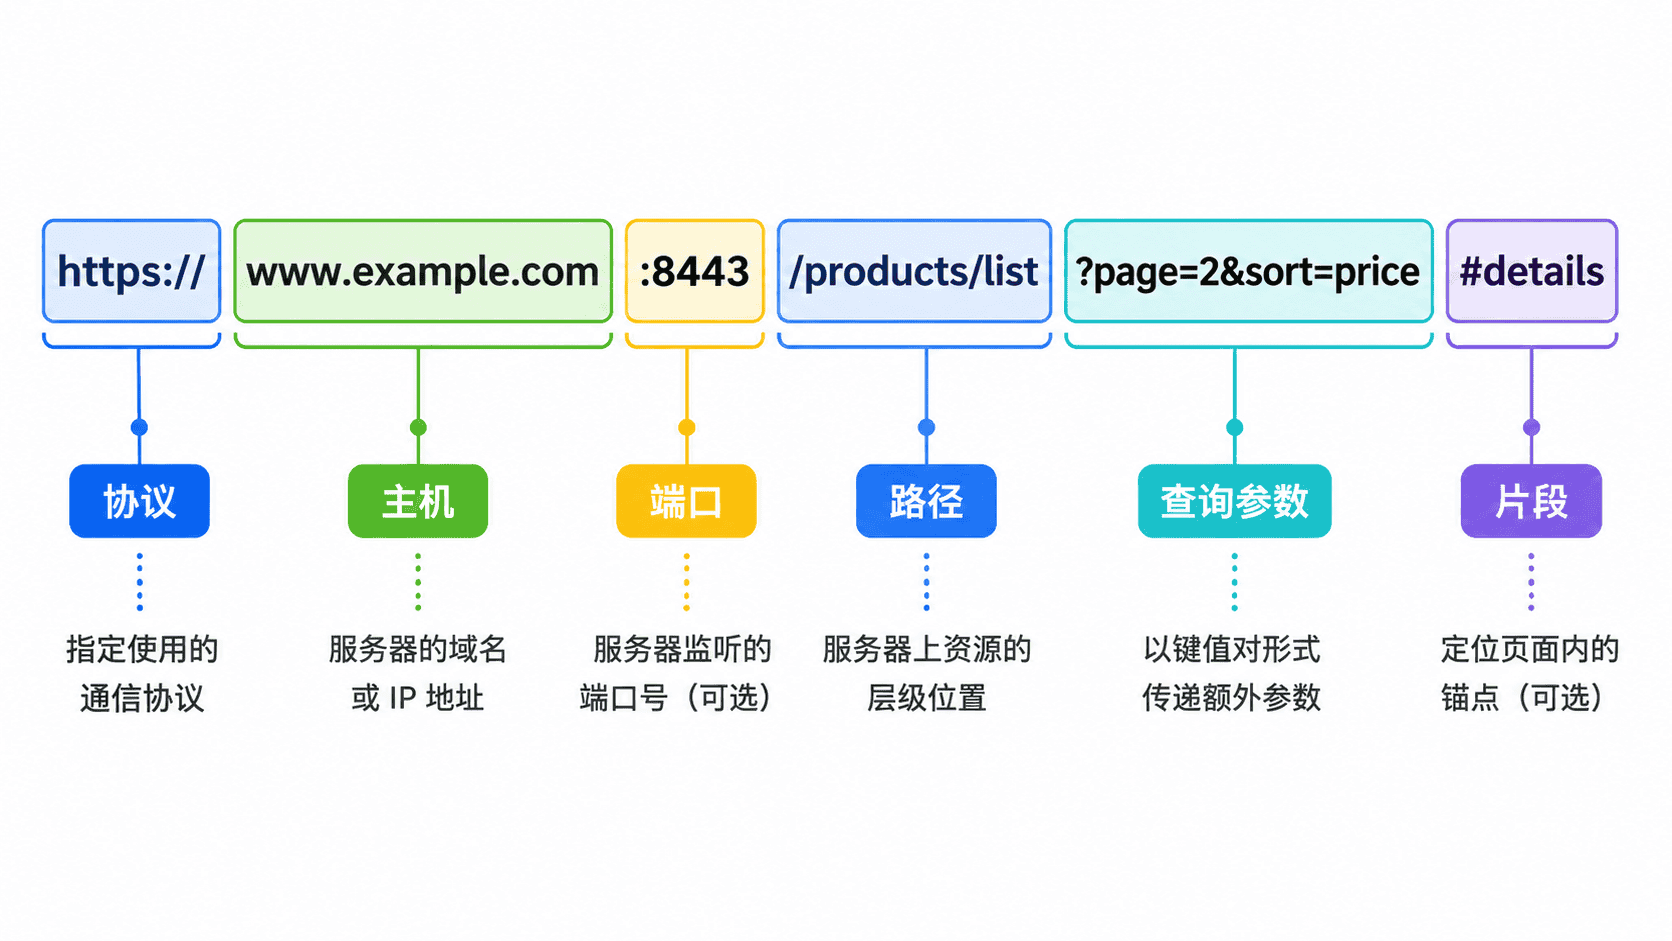
下面这条示例 URL 包含常见的六个部分:
https://www.example.com:8443/products/list?page=2&sort=price#details拆解 URL 的目的不是记符号,而是明确每部分由谁处理。协议和主机决定如何建立连接,路径与查询参数通常会发送给服务器,片段一般只由浏览器在本地使用。
六个核心组成部分
| 组成部分 | 示例 | 作用 |
|---|---|---|
| 协议 | https |
指定通信方式,常见为 HTTP 或 HTTPS |
| 主机 | www.example.com |
指定目标服务器的域名或 IP 地址 |
| 端口 | 8443 |
指定服务器上的具体网络服务 |
| 路径 | /products/list |
指定服务器中的资源或接口位置 |
| 查询参数 | page=2&sort=price |
向服务器补充筛选、分页等条件 |
| 片段 | details |
定位页面内部的某个位置 |
协议后使用 ://,端口位于主机后的冒号之后,查询参数从 ? 开始,多个参数通常用 & 分隔,片段从 # 开始。
HTTP 默认端口是 80,HTTPS 默认端口是 443。使用默认端口时通常可以省略;显式写出其他端口,则浏览器会连接该端口对应的服务。
浏览器如何使用 URL
浏览器读取示例 URL 时,会先根据 https 决定使用加密的 HTTP 通信,再解析 www.example.com 对应的服务器地址,并尝试连接 8443 端口。
连接建立后,浏览器会把路径和查询部分组合成请求目标,例如 /products/list?page=2&sort=price。服务器可据此返回第二页、按价格排序的商品列表。
#details 不属于请求目标,通常不会发送给服务器。浏览器收到页面后,会在本地寻找名为 details 的锚点并滚动到对应位置。因此,更改片段通常不需要重新请求整个页面。
绝对 URL 与相对 URL
绝对 URL 包含协议和主机,可以在任何上下文中独立定位资源,例如:
https://www.example.com/images/logo.png相对 URL 依赖当前页面的地址,例如当前页面位于 https://www.example.com/docs/start.html,其中的 ../images/logo.png 会解析为 https://www.example.com/images/logo.png。
相对 URL 适合站内资源,因为部署到不同域名时无需逐个修改主机名;跨站链接、接口回调地址或需要脱离当前页面独立使用的地址,则更适合绝对 URL。
常见混淆与边界
路径表示资源位置,查询参数表示对资源的附加条件。/users/42 常表示编号为 42 的用户资源,/users?page=2 常表示用户列表的第二页,但具体含义仍由服务器设计决定。
URL 中的空格、中文和部分特殊字符通常需要百分号编码。例如空格常编码为 %20。编码后的字符仍属于原来的路径或查询部分,不会产生新的 URL 结构。
不要把域名后的所有内容都称为“参数”。只有 ? 与 # 之间的部分属于查询参数;# 后面是片段;主机后的斜杠内容首先是路径。