
数据结构与算法 / 系统课时
定位算法性能瓶颈
定位算法性能瓶颈
性能优化不是看到循环就改代码,而是先找到真正消耗资源的路径。本课将用操作计数解释隐藏复杂度,再给出从整体耗时到热点方法、根因和复测的定位顺序。
学习目标
- 根据调用频率、输入规模和单次成本判断热点
- 识别容器 API、对象分配和递归中的隐藏开销
- 使用剖析结果验证优化方向并完成复测
从现象到热点
一个方法是否值得优化,取决于它被调用多少次、每次处理多大输入,以及单次操作的成本。低频的嵌套循环可能无关紧要,而高频路径中的一次线性查找可能占据大部分 CPU。
定位时应先确认整体慢在哪里,再用采样剖析查看时间集中在哪条调用路径。火焰图中横向越宽通常表示采样占比越高,但它只能说明“时间花在哪里”,不能自动证明根因。
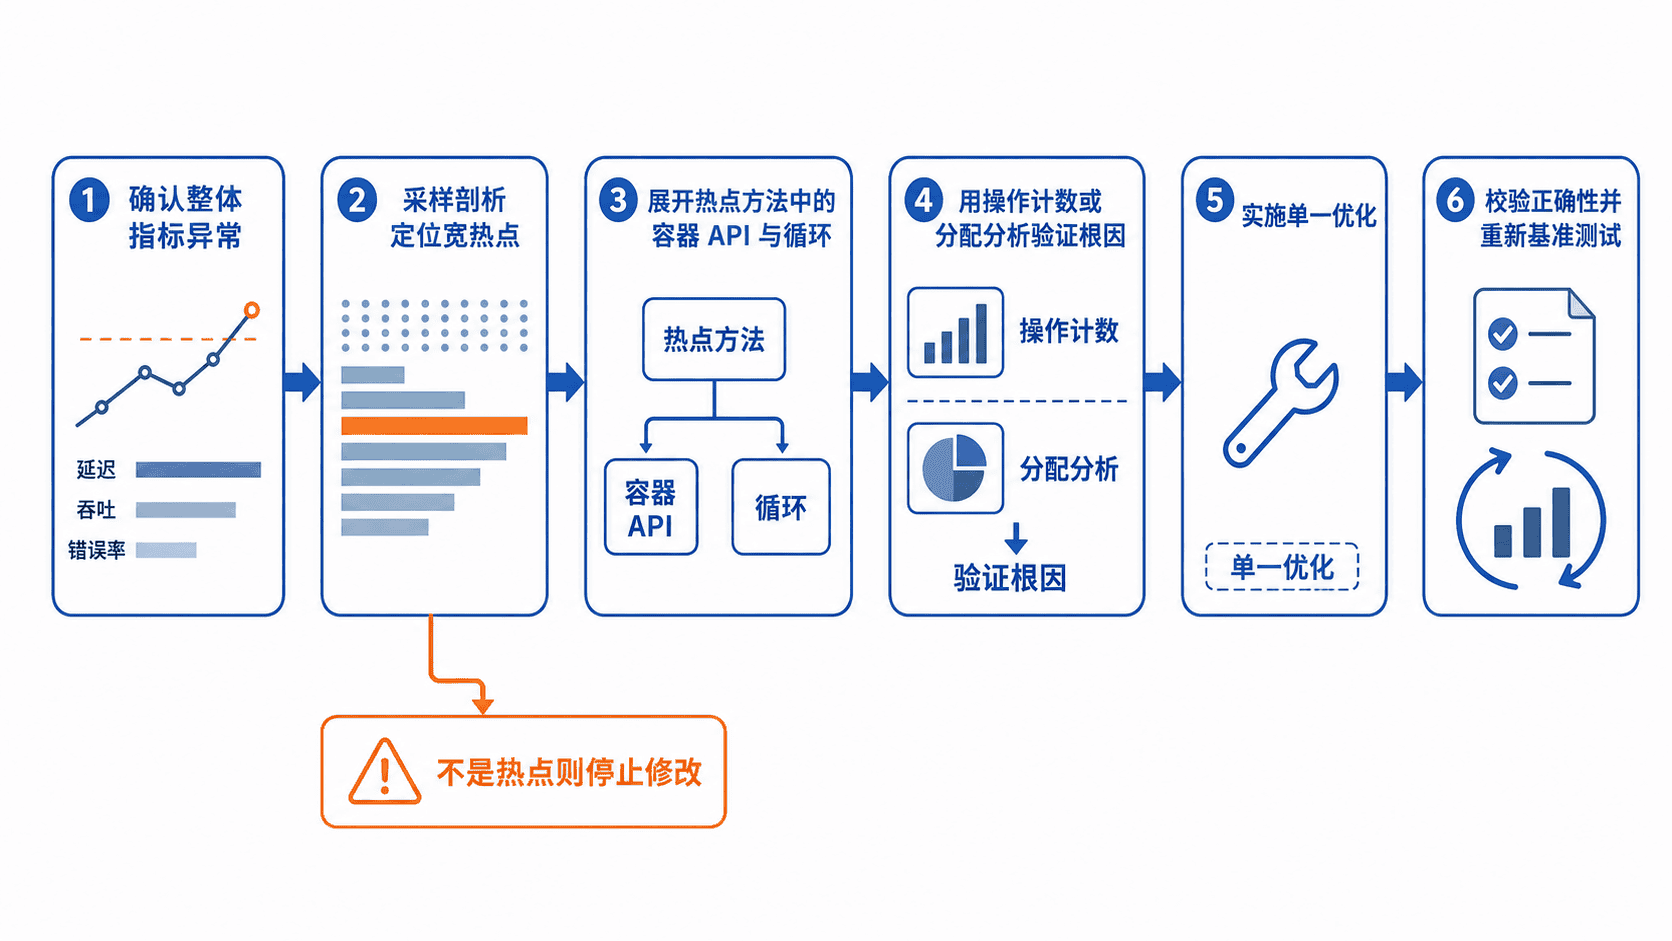
展开隐藏复杂度
表面上只有一层查询循环,并不代表总复杂度是线性的。若循环执行 q 次,每次调用 List.contains 扫描最多 n 个元素,总成本可能达到 。
改用 HashSet 后,构建索引需要 时间和额外内存,查询平均为 。因此应比较“构建索引加全部查询”的总成本;若只查询一次,建索引未必划算。
对象创建、装箱、字符串拼接和重复递归也可能成为热点。CPU 剖析关注执行时间,分配剖析用于确认临时对象和 GC 压力,两者不能互相替代。
主示例
下面的 Java 17 示例不测不稳定的墙钟时间,而是统计两种查询方案的逻辑操作数。线性扫描记录逐元素比较次数;哈希方案记录查询调用次数。后者不是哈希表内部比较次数,只用于展示数量级差异。
import java.util.ArrayList;
import java.util.HashSet;
import java.util.List;
import java.util.Set;

public class PerformanceBottleneckDemo {
    private record Stats(int matches, long operations) {
    }

    public static void main(String[] args) {
        List<Integer> values = new ArrayList<>();
        for (int i = 0; i < 1_000; i++) {
            values.add(i);
        }

        // 索引构建有一次性成本,真实优化必须把这部分计入总成本。
        Set<Integer> index = new HashSet<>(values);
        int[] queries = {0, 500, 999, -1};

        Stats linear = linear(values, queries, 100);
        Stats hashed = hashed(index, queries, 100);

        System.out.println("查询次数: 400");
        System.out.println("线性扫描比较次数: " + linear.operations());
        System.out.println("哈希集合查询调用次数: " + hashed.operations());
        System.out.println("匹配结果一致: " + (linear.matches() == hashed.matches()));
    }

    // 逐元素比较,统计能够解释 O(qn) 趋势的操作次数。
    private static Stats linear(List<Integer> values, int[] queries, int rounds) {
        int matches = 0;
        long operations = 0;

        for (int r = 0; r < rounds; r++) {
            for (int query : queries) {
                boolean found = false;
                for (int value : values) {
                    operations++;
                    if (value == query) {
                        found = true;
                        break;
                    }
                }
                if (found) {
                    matches++;
                }
            }
        }
        return new Stats(matches, operations);
    }

    // 此处只统计 contains 调用次数,不代表哈希表内部比较次数。
    private static Stats hashed(Set<Integer> values, int[] queries, int rounds) {
        int matches = 0;
        long operations = 0;

        for (int r = 0; r < rounds; r++) {
            for (int query : queries) {
                operations++;
                if (values.contains(query)) {
                    matches++;
                }
            }
        }
        return new Stats(matches, operations);
    }
}
将代码保存为 PerformanceBottleneckDemo.java,再编译运行:
javac PerformanceBottleneckDemo.java
java PerformanceBottleneckDemo
预期输出:
查询次数: 400
线性扫描比较次数: 250200
哈希集合查询调用次数: 400
匹配结果一致: true
定位与优化原则
操作计数能解释复杂度趋势,但真实系统还要结合 JFR、async-profiler 或其他采样工具确认 CPU、锁等待和分配热点。不要根据方法名猜测,也不要只优化火焰图中很窄的路径。
每次只实施一个有证据支持的改动,并同时记录索引构建成本、内存增长和端到端耗时。优化后应使用相同输入重新校验结果,再执行与修改前相同的基准测试,避免局部变快而整体变慢。