
数据结构与算法 / 系统课时
哈希表扩容与负载因子
哈希表扩容与负载因子
哈希表逐渐变满后,冲突链或探测距离都会增长。本课使用负载因子判断扩容时机,并实现一次完整的重新哈希,验证容量变化后旧桶位置不能直接沿用。
学习目标
- 计算负载因子并解释阈值的时间与空间权衡。
- 说明扩容后必须重新哈希全部条目的原因。
- 实现倍增扩容并理解插入的均摊复杂度。
负载因子控制拥挤程度
负载因子等于元素数量除以桶数量。链地址法允许该值超过 1,但桶内扫描会变长;开放寻址法必须保留空槽,通常会在更低阈值处扩容。
阈值较低时冲突较少,但会更早占用内存;阈值较高时空间利用率更好,却可能增加查找成本。具体数值应结合冲突策略、键分布和内存预算选择。
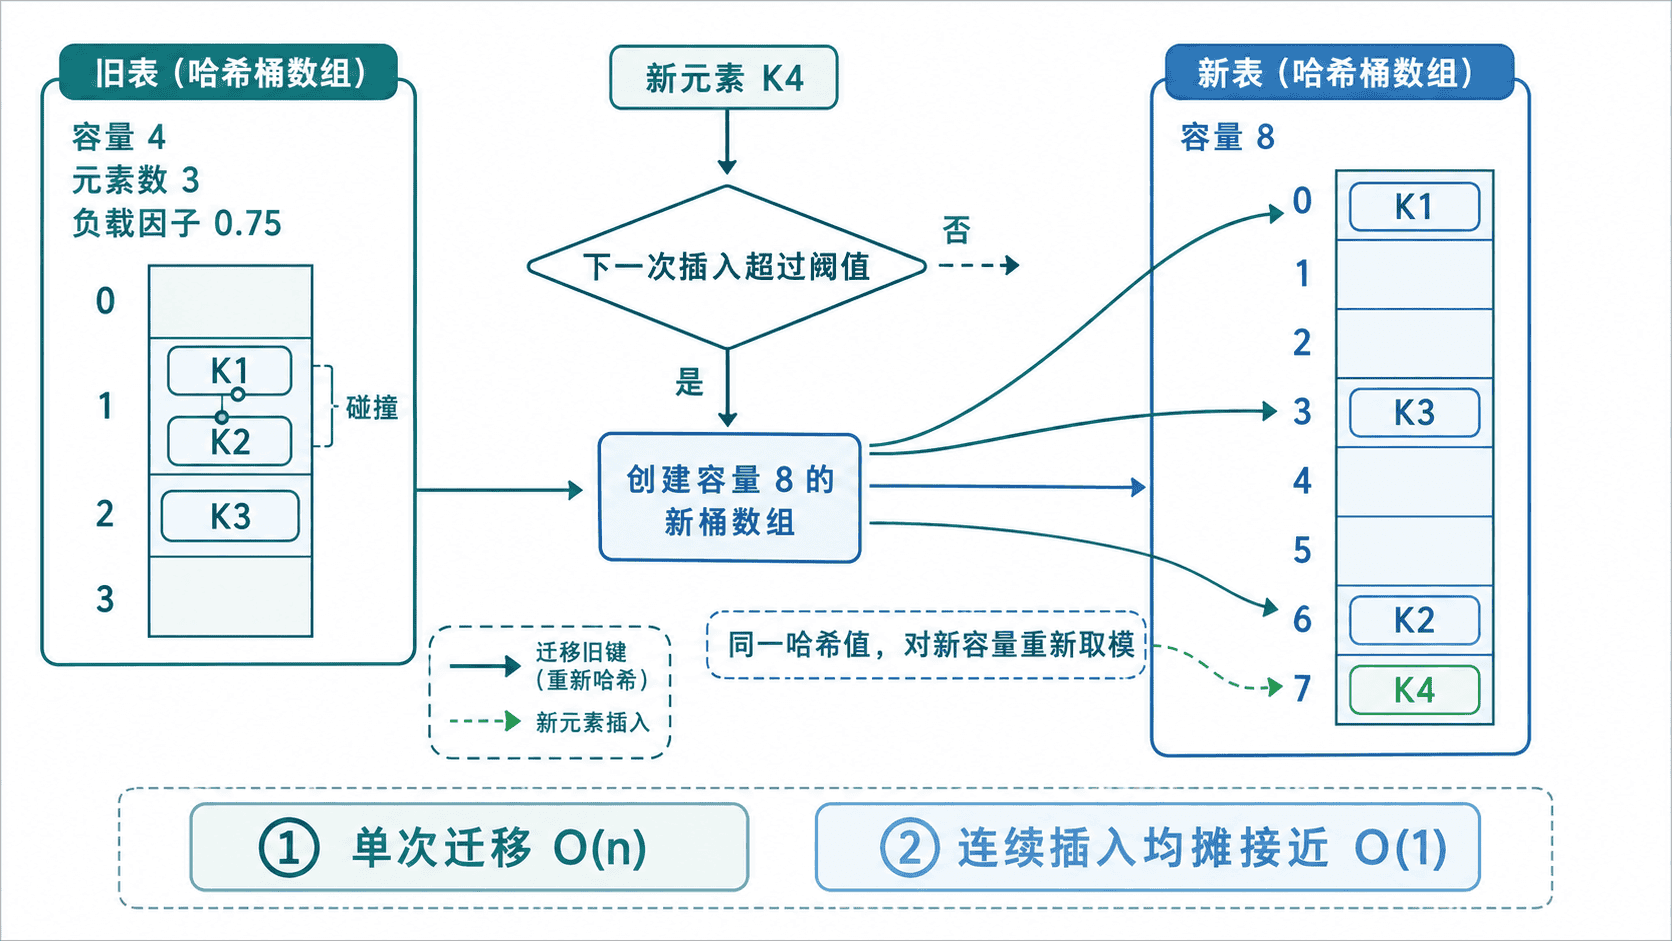
扩容为什么不能直接复制桶
桶下标通常由“哈希值对容量取模”得到。容量从 4 变为 8 后,同一个哈希值的余数可能改变,因此旧桶整体复制到相同下标会破坏查找规则。
正确流程是创建新桶数组,遍历旧表中的每个键值对,再按新容量计算位置并插入。迁移过程应调用不再触发扩容的内部方法,避免重复检查阈值。
主示例:可扩容链地址哈希表
示例采用确定性的字符串哈希,初始容量为 4,阈值为 0.75。更新已有键不会增加元素数量,也不会因“下一次插入”而错误触发扩容。
python
from typing import Optional

class ResizableHashMap:
    def __init__(self, capacity: int = 4, threshold: float = 0.75) -> None:
        if capacity <= 0:
            raise ValueError("capacity 必须大于 0")
        if not 0 < threshold < 1:
            raise ValueError("threshold 必须位于 0 和 1 之间")

        self._buckets: list[list[tuple[str, int]]] = [
            [] for _ in range(capacity)
        ]
        self._threshold = threshold
        self._size = 0

    @staticmethod
    def _hash(key: str) -> int:
        result = 0
        # 固定算法保证示例输出不受 Python 字符串哈希随机化影响
        for byte in key.encode("utf-8"):
            result = (result * 31 + byte) & 0xFFFFFFFF
        return result

    def _index(self, key: str) -> int:
        return self._hash(key) % len(self._buckets)

    def _find(self, key: str) -> tuple[list[tuple[str, int]], int]:
        bucket = self._buckets[self._index(key)]
        for index, (stored_key, _) in enumerate(bucket):
            if stored_key == key:
                return bucket, index
        return bucket, -1

    def _insert_new(self, key: str, value: int) -> None:
        self._buckets[self._index(key)].append((key, value))
        self._size += 1

    def put(self, key: str, value: int) -> None:
        bucket, index = self._find(key)
        if index >= 0:
            bucket[index] = (key, value)
            return

        if (self._size + 1) / len(self._buckets) > self._threshold:
            self._resize(len(self._buckets) * 2)
        self._insert_new(key, value)

    def get(self, key: str) -> Optional[int]:
        bucket, index = self._find(key)
        return None if index < 0 else bucket[index][1]

    def _resize(self, new_capacity: int) -> None:
        old_entries = [
            entry
            for bucket in self._buckets
            for entry in bucket
        ]

        self._buckets = [[] for _ in range(new_capacity)]
        self._size = 0
        # 迁移时直接插入新桶,避免再次触发扩容判断
        for key, value in old_entries:
            self._insert_new(key, value)

    @property
    def capacity(self) -> int:
        return len(self._buckets)

    @property
    def load_factor(self) -> float:
        return self._size / len(self._buckets)

    def bucket_index(self, key: str) -> int:
        return self._index(key)

def main() -> None:
    table = ResizableHashMap()

    for index, key in enumerate(["A", "B", "alpha", "D"], start=1):
        table.put(key, index * 10)
        print(
            f"写入 {key}: capacity={table.capacity}, "
            f"load_factor={table.load_factor:.2f}"
        )

    print("读取 alpha:", table.get("alpha"))
    print("alpha 当前桶:", table.bucket_index("alpha"))

if __name__ == "__main__":
    main()
预期输出
text
写入 A: capacity=4, load_factor=0.25
写入 B: capacity=4, load_factor=0.50
写入 alpha: capacity=4, load_factor=0.75
写入 D: capacity=8, load_factor=0.50
读取 alpha: 30
alpha 当前桶: 6
复杂度与实现边界
一次扩容需要遍历当前全部元素,时间复杂度为 O(n)。若容量按倍数增长,同一元素只会在少数扩容时被搬迁,因此一长串插入的均摊成本仍可接近 O(1)。
本例用 None 表示键不存在,所以值类型限制为整数。若映射允许保存 None,查询接口应返回“是否存在”和“值”两个信息,或单独提供 contains_key。
按自己的节奏,确认真正理解。