
数据结构与算法 / 系统课时
哈希映射解决计数问题
哈希映射解决计数问题
许多问题不仅要知道元素是否出现,还要记录出现次数、下标或所属分组。本课用一个主示例展示频次统计和两数之和,归纳哈希映射中“键和值分别保存什么”的设计方法。
学习目标
- 使用哈希映射统计元素出现频次。
- 选择次数、下标或列表作为映射值。
- 掌握两数之和中的补数查找与先查后存顺序。
先设计键和值
频次统计使用“元素到次数”的映射,每读到一次就把计数加一。索引问题可使用“元素到下标”的映射;若要保留全部位置,值应改为下标列表。
两数之和扫描当前值时,需要寻找 target - value。映射只保存此前见过的值与下标,先查询补数,再保存当前元素,才能避免把同一位置使用两次。
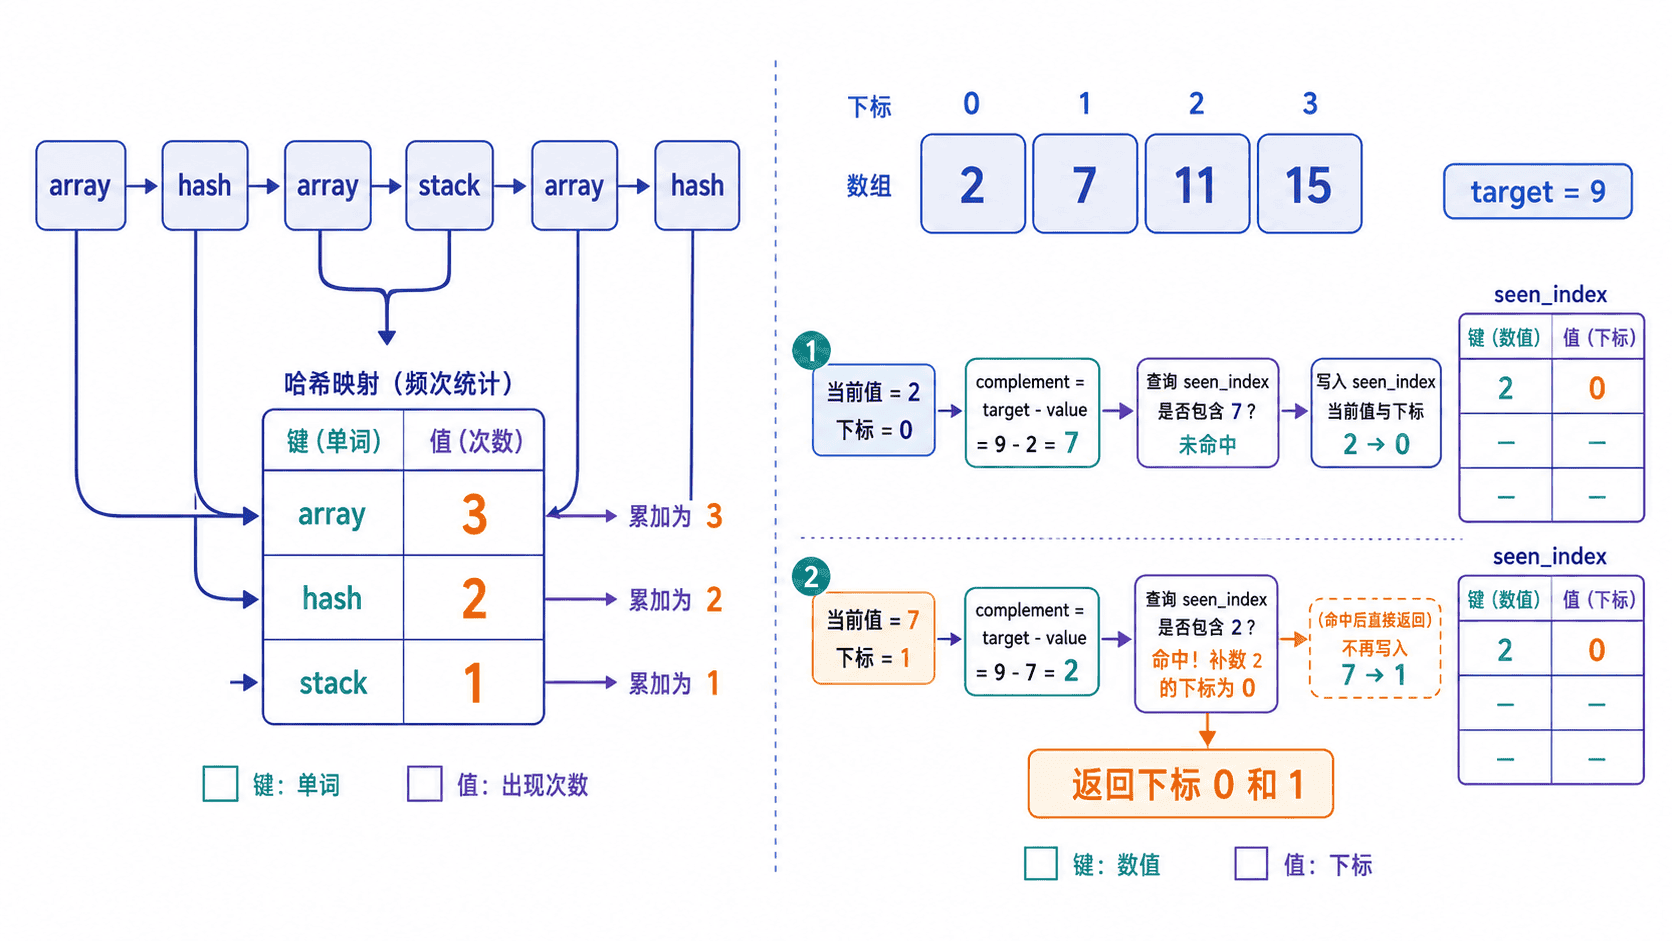
主示例:计数与两数之和
示例先用字典完成频次统计,再从统计结果中找最高频元素;随后使用“已见值到下标”的映射在线性扫描中完成两数之和。
python
from typing import Optional

def frequency_map(values: list[str]) -> dict[str, int]:
    counts: dict[str, int] = {}

    for value in values:
        # get 的默认值 0 表示该元素此前尚未出现
        counts[value] = counts.get(value, 0) + 1

    return counts

def most_common(counts: dict[str, int]) -> tuple[str, int]:
    if not counts:
        raise ValueError("counts 不能为空")
    return max(counts.items(), key=lambda item: item[1])

def two_sum(nums: list[int], target: int) -> Optional[tuple[int, int]]:
    seen_index: dict[int, int] = {}

    for index, value in enumerate(nums):
        complement = target - value

        # 先查后存,保证不会复用当前元素
        if complement in seen_index:
            return seen_index[complement], index
        seen_index[value] = index

    return None

def main() -> None:
    words = ["array", "hash", "array", "stack", "hash", "array"]
    counts = frequency_map(words)
    print("频次:", counts)
    print("最高频:", most_common(counts))

    nums = [2, 7, 11, 15]
    print("两数之和下标:", two_sum(nums, 9))

if __name__ == "__main__":
    main()
预期输出
text
频次: {'array': 3, 'hash': 2, 'stack': 1}
最高频: ('array', 3)
两数之和下标: (0, 1)
复杂度与关键边界
频次统计和两数之和都只扫描一次输入,哈希查询与写入平均为 O(1),所以平均时间复杂度为 O(n),额外空间为 O(n)。若使用双重循环寻找两数,时间复杂度会升为 O(n²)。
映射值应服从问题目标:需要首次下标时不要持续覆盖,需要最近下标时可以更新,需要全部下标时应保存列表。两数之和存在多个答案时,还要事先明确返回任意一组、第一组还是全部组合。
most_common 在最高次数并列时返回字典迭代中先出现的元素。本例没有并列;若业务要求固定的并列规则,应显式增加第二排序条件。
按自己的节奏,确认真正理解。