
数据结构与算法 / 系统课时
哈希函数的设计原则
哈希函数的设计原则
哈希函数决定键进入哪个桶。本课从确定性、分布效果和计算成本出发,实现一个稳定的 32 位字符串哈希,并说明普通容器哈希为什么不能替代密码学哈希。
学习目标
- 说明确定性、均匀分布和计算效率的作用。
- 实现按 UTF-8 字节逐步组合的稳定字符串哈希。
- 区分容器哈希、持久化摘要与口令哈希的目标。
设计哈希函数时关注什么
同一个键在相同算法下必须得到同一结果,否则插入后将无法按相同路径查找。不同键可以发生冲突,但结果应尽量分散,避免大量元素集中到少数桶。
哈希计算还应足够快,并覆盖所有参与相等判断的字段。若两个对象相等,它们的哈希值必须相同;反过来,哈希值相同并不代表对象一定相等,桶内仍需比较原始键。
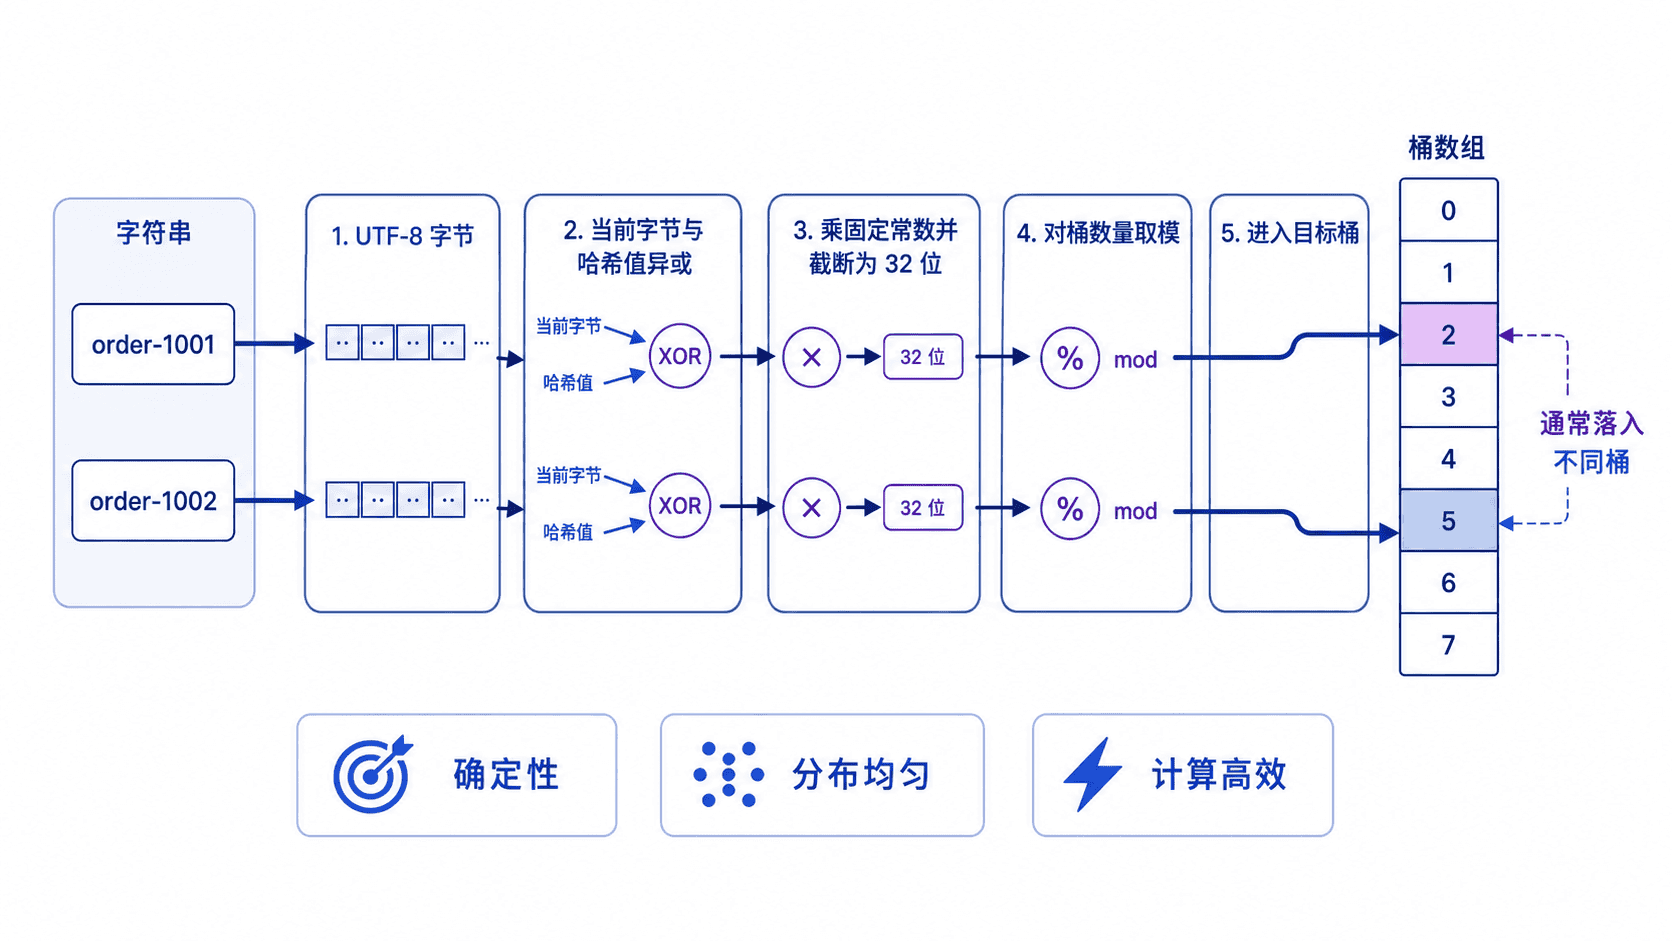
主示例:稳定字符串哈希
下面采用 FNV-1a 的组合方式处理 UTF-8 字节。& 0xFFFFFFFF 模拟无符号 32 位溢出,使结果范围固定;该示例适合教学和普通分桶,不用于密码、签名或抗攻击场景。
python
def stable_string_hash(text: str) -> int:
    result = 2166136261

    # 按 UTF-8 字节处理,避免不同语言对字符编码方式理解不一致
    for byte in text.encode("utf-8"):
        result ^= byte
        result = (result * 16777619) & 0xFFFFFFFF

    return result

def bucket_distribution(keys: list[str], bucket_count: int) -> list[int]:
    if bucket_count <= 0:
        raise ValueError("bucket_count 必须大于 0")

    counts = [0] * bucket_count
    for key in keys:
        # 分桶发生在完整哈希计算之后
        counts[stable_string_hash(key) % bucket_count] += 1
    return counts

def main() -> None:
    keys = [
        "alice", "bob", "carol", "dave",
        "order-1001", "order-1002", "order-1003", "order-1004",
    ]

    for key in keys[:4]:
        print(key, stable_string_hash(key))

    print("8 个桶的分布:", bucket_distribution(keys, 8))
    print(
        "abc 与 cba 是否相同:",
        stable_string_hash("abc") == stable_string_hash("cba"),
    )

if __name__ == "__main__":
    main()
预期输出
text
alice 2267157479
bob 2261164244
carol 1728614162
dave 3496789471
8 个桶的分布: [0, 0, 2, 1, 2, 1, 0, 2]
abc 与 cba 是否相同: False
关键边界
Python 的内置 hash() 适合当前进程中的容器操作,但字符串哈希通常带随机化种子,不应直接写入文件或作为跨进程协议值。需要长期稳定结果时,应明确算法、字符编码和整数宽度。
普通容器哈希强调速度和分布;文件完整性校验通常使用密码学摘要;口令存储还需要专门的慢哈希和随机盐。三者名称相近,但安全目标不同。
按自己的节奏,确认真正理解。