
数据结构与算法 / 系统课时
堆排序与非比较排序
堆排序与非比较排序
堆排序提供确定的 时间上界,计数排序则在整数键范围较小时突破比较排序的下界。本课通过同一组数据比较两种方法的过程、空间成本和适用条件。
学习目标
- 说明最大堆建堆、交换与下沉过程
- 实现堆排序和支持负整数的计数排序
- 根据数据规模与键范围选择排序方法
两类排序思路
升序堆排序先自底向上构建最大堆,使堆顶保存当前最大值;随后把堆顶与未排序区末尾交换,缩小堆范围,再对新堆顶执行下沉。建堆为 ,整个排序为 ,且数组内原地完成,但远距离交换使它不稳定。
计数排序不比较元素大小,而是统计每个整数键出现的次数,再按键值顺序展开。其复杂度为 ,其中 是键值范围长度。只有当 与 同量级或足够小时,它才具有明显优势。
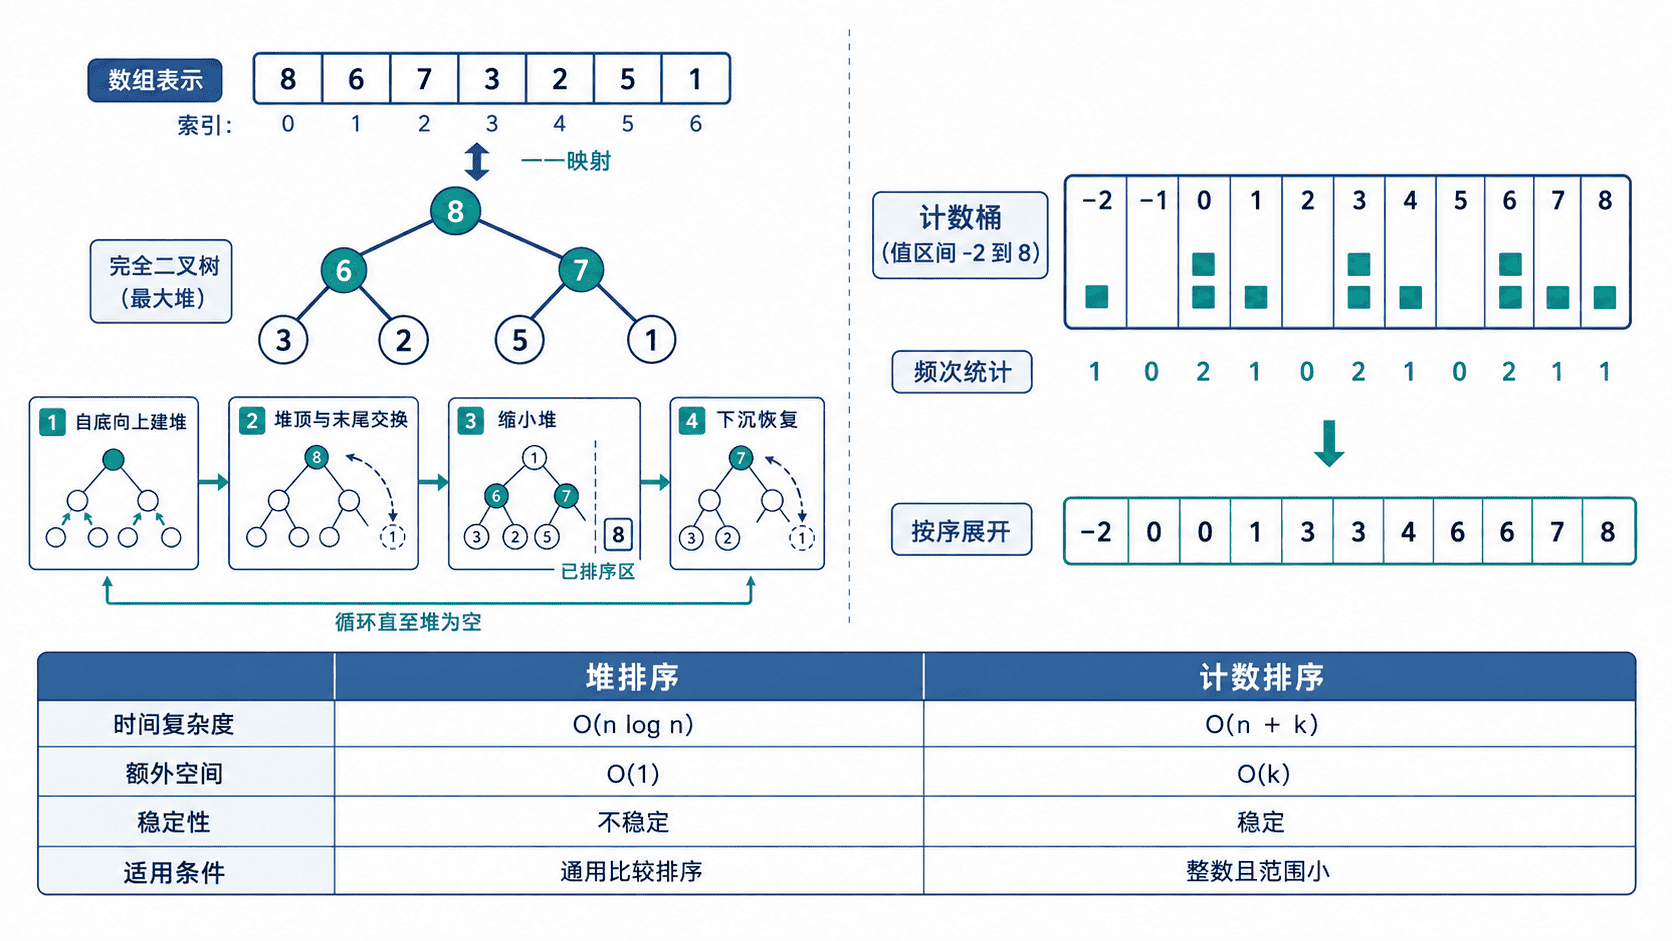
主示例
python
def heap_sort(values):
    items = values.copy()
    size = len(items)

    def sift_down(index, heap_size):
        while True:
            left = 2 * index + 1
            right = left + 1
            largest = index

            if left < heap_size and items[left] > items[largest]:
                largest = left
            if right < heap_size and items[right] > items[largest]:
                largest = right
            if largest == index:
                return

            items[index], items[largest] = items[largest], items[index]
            index = largest

    # 最后一个非叶子节点是 size // 2 - 1。
    for index in range(size // 2 - 1, -1, -1):
        sift_down(index, size)

    for end in range(size - 1, 0, -1):
        items[0], items[end] = items[end], items[0]
        sift_down(0, end)

    return items

def counting_sort(values):
    if not values:
        return []

    minimum = min(values)
    maximum = max(values)
    counts = [0] * (maximum - minimum + 1)

    # 使用偏移量同时支持负整数和非负整数。
    for value in values:
        counts[value - minimum] += 1

    result = []
    for offset, count in enumerate(counts):
        result.extend([offset + minimum] * count)
    return result

data = [4, -2, 2, 8, 3, 3, 1]
print("堆排序:", heap_sort(data))
print("计数排序:", counting_sort(data))
预期输出:
text
堆排序: [-2, 1, 2, 3, 3, 4, 8]
计数排序: [-2, 1, 2, 3, 3, 4, 8]
选择与边界
堆排序适合需要原地排序、必须保证最坏 ,且不要求稳定性的场景。交换到数组末尾的元素已经有序,后续下沉必须使用缩小后的 heap_size,否则会破坏排序结果。
示例中的计数排序只展开数值,因此不用于保持业务记录的相对顺序。若要稳定排序带附属数据的记录,需要累计计数并从右向左写入输出数组。键范围极大而数据稀疏时,计数数组可能耗尽内存,此时应改用比较排序或字典计数。
按自己的节奏,确认真正理解。