
数据结构与算法 / 系统课时
数组的存储结构
数组的存储结构
数组能够按下标快速访问元素,关键不在方括号语法,而在连续存储和固定元素大小。本课从地址计算出发,解释随机访问、缓存局部性以及扩容和中间操作的代价。
学习目标
- 理解数组连续存储与地址计算的关系。
- 能解释按下标访问为何通常是 。
- 能识别数组在扩容、插入和删除时的主要成本。
连续存储与地址计算
同一数组中的元素类型一致,因此单个元素占用的空间相同。若首元素地址为 base,每个元素占用 size 字节,则下标 i 对应的地址为:
程序只需一次乘法和一次加法就能定位目标元素,无须从头遍历。数组长度为 n 时,有效下标范围是 0 到 n - 1;访问 n 已经越界。
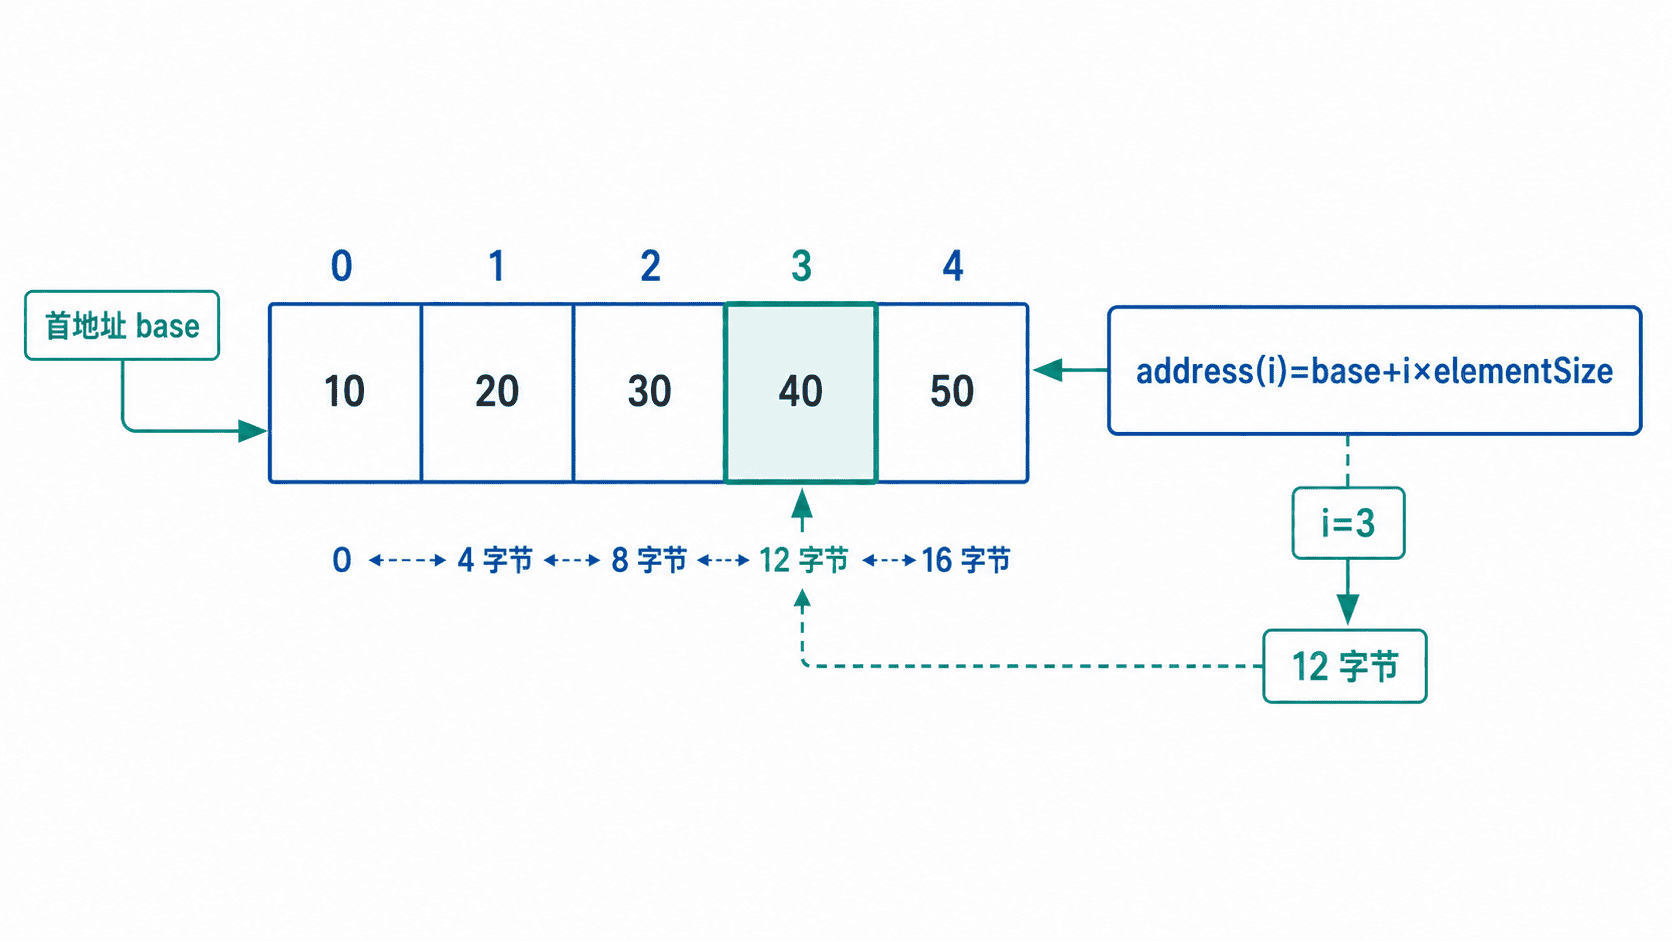
为什么随机访问是 O(1)
无论数组含有 10 个还是 100 万个元素,已知下标后都执行固定数量的地址计算和内存读写,因此渐进时间复杂度通常为 。这表示操作次数不随数组长度线性增长,并不代表每次物理访问耗时完全相同。
连续布局还具有较好的空间局部性。CPU 读取一个元素时,往往会把附近数据一起装入缓存,因此顺序遍历通常比大跨度跳跃访问更容易命中缓存。
连续布局带来的限制
固定数组创建后长度不能原地改变。容量不足时,动态数组必须申请更大的连续空间并复制已有元素,单次扩容成本为 。
在中间插入元素时,插入位置后的数据通常要整体右移;删除中间元素时,后续数据要整体左移。数组的优势是按下标访问快,而不是所有操作都快。
主示例:验证元素偏移
下面的 C 程序不打印随机化后的真实地址,而是计算元素相对首元素的字节偏移,并验证相邻偏移等于单个元素大小。
#include <stddef.h>
#include <stdio.h>

int main(void) {
    int numbers[5] = {10, 20, 30, 40, 50};
    size_t length = sizeof(numbers) / sizeof(numbers[0]);

    ptrdiff_t first_gap =
        (const char *)&numbers[1] - (const char *)&numbers[0];

    printf("元素个数: %zu\n", length);
    printf(
        "相邻偏移等于元素大小: %s\n",
        first_gap == (ptrdiff_t)sizeof(numbers[0]) ? "是" : "否"
    );
    printf("下标 3 的值: %d\n", *(numbers + 3));

    return 0;
}
编译并运行:
gcc array_memory.c -std=c11 -Wall -Wextra -O2 -o array_memory
./array_memory
预期输出:
元素个数: 5
相邻偏移等于元素大小: 是
下标 3 的值: 40
表达式 numbers + 3 会按 int 元素大小移动三个位置,而不是简单增加三个字节。数组传入函数后通常会退化为指针,因此函数无法再用 sizeof(array) / sizeof(array[0]) 获得原始长度,应额外传入长度参数。
边界与常见错误
数组越界在 C 中属于未定义行为,可能读取错误数据、覆盖其他内存或直接崩溃。业务中的“第 1 个元素”通常对应下标 0,不要把自然编号直接当作下标。
无序数组按值查找仍需逐个比较,时间复杂度为 。只有在已知下标时,读取和修改才通常是 。