
数据结构与算法 / 系统课时
集合去重与成员判断
集合去重与成员判断
当问题只关心元素是否出现,而不需要为每个元素保存独立业务值时,集合通常比列表扫描更直接。本课用一个主示例完成保序去重、重复检测和权限成员判断。
学习目标
- 说明集合的唯一性与成员判断语义。
- 使用集合完成保序去重和首个重复项检测。
- 分析集合方案的平均时间复杂度与使用边界。
集合适合解决什么问题
集合通常建立在哈希表上,可以把它理解为“只保存键”的映射。加入已存在元素不会产生第二份副本,成员判断则先定位哈希位置,再比较元素是否相等。
直接把列表转换为集合可以去重,但集合的迭代顺序不应被当作稳定业务顺序。若要保留首次出现顺序,应让集合负责快速判断,让列表负责输出顺序。
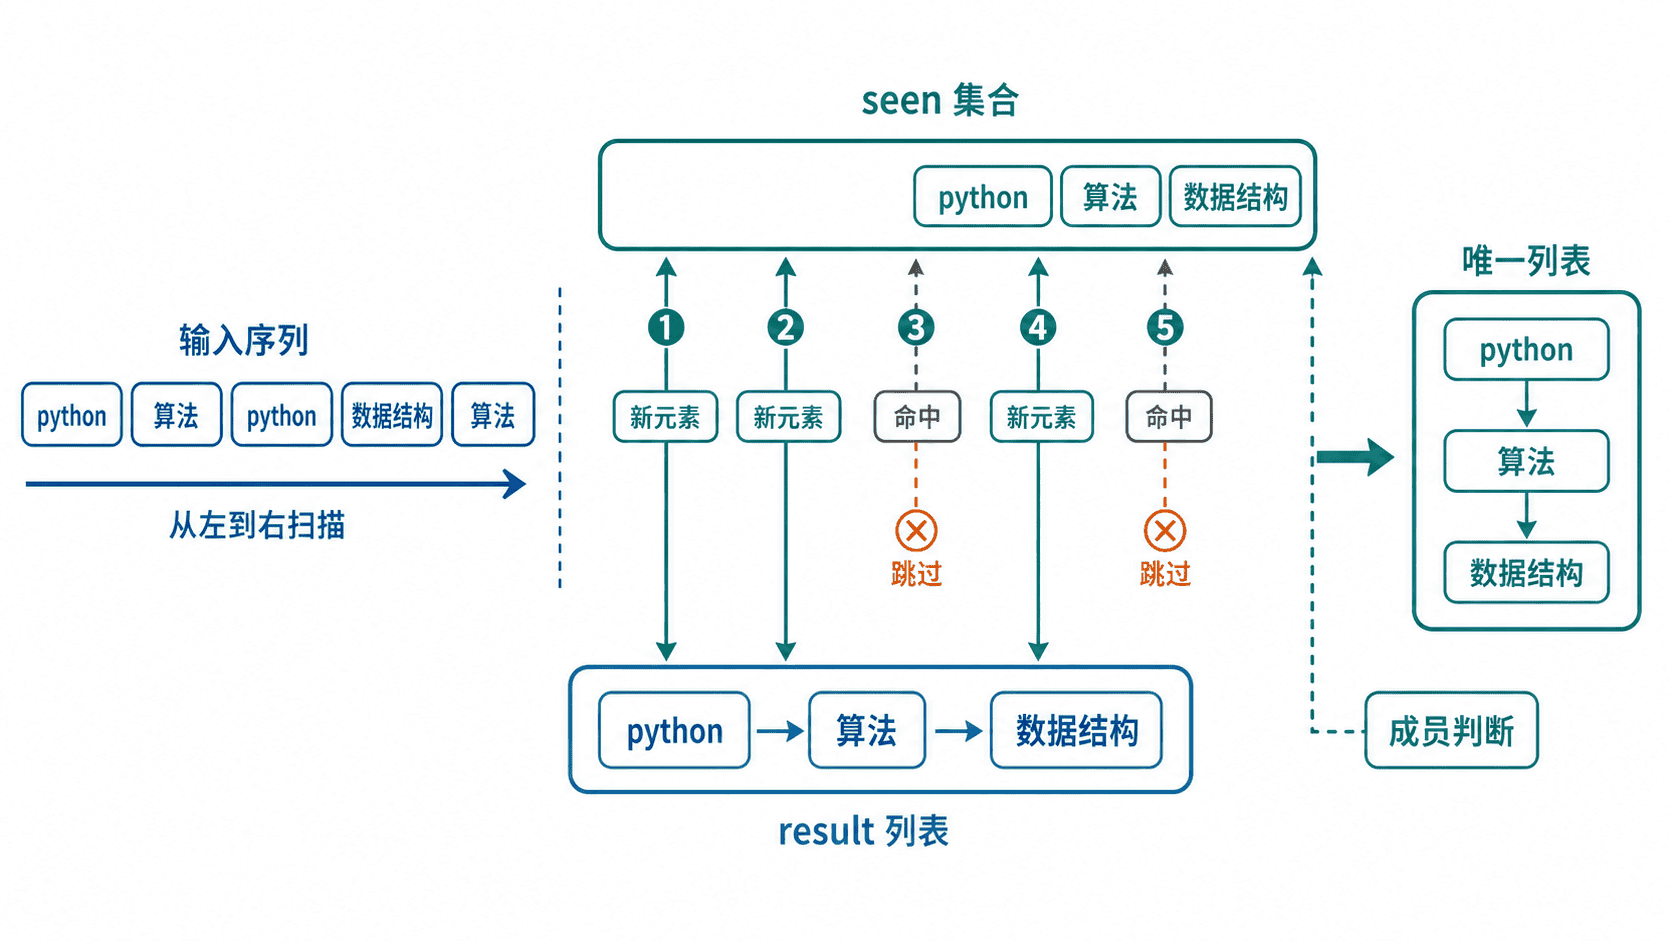
主示例:保序去重与重复检测
两个函数共享同一模式:从左到右扫描,每次先查询 seen。保序去重遇到新元素才追加结果;重复检测遇到已存在元素立即返回。
python
from collections.abc import Iterable
from typing import Optional, TypeVar

T = TypeVar("T")

def unique_preserving_order(values: Iterable[T]) -> list[T]:
    seen: set[T] = set()
    result: list[T] = []

    for value in values:
        # 集合负责快速判断,列表负责保存首次出现顺序
        if value not in seen:
            seen.add(value)
            result.append(value)

    return result

def first_duplicate(values: Iterable[T]) -> Optional[T]:
    seen: set[T] = set()

    for value in values:
        if value in seen:
            return value
        seen.add(value)

    return None

def main() -> None:
    tags = ["python", "算法", "python", "数据结构", "算法"]
    print("保序去重:", unique_preserving_order(tags))
    print("第一个重复项:", first_duplicate(tags))

    permissions = {"course:read", "lesson:edit"}
    print("可编辑课时:", "lesson:edit" in permissions)
    print("可删除课程:", "course:delete" in permissions)

if __name__ == "__main__":
    main()
预期输出
text
保序去重: ['python', '算法', '数据结构']
第一个重复项: python
可编辑课时: True
可删除课程: False
复杂度与边界
对 n 个元素扫描一次,集合插入和查询平均为 O(1),因此整体平均时间复杂度为 O(n),额外空间为 O(n)。极端冲突下性能可能下降,但常规使用中通常优于反复线性扫描列表。
集合元素必须可哈希,并且其哈希相关状态在存入后不应变化。列表等可变对象不能直接作为集合元素;自定义对象还应保证相等对象具有相同哈希值。
集合只保留唯一元素,不能表达出现次数。需要频次、下标或分组信息时,应改用哈希映射。
按自己的节奏,确认真正理解。