
数据结构与算法 / 系统课时
排序算法的评价指标
排序算法的评价指标
选择排序算法不能只看一个大 O 记号。本课从时间复杂度、额外空间、稳定性、原地性和输入条件五个维度建立评价框架,并用带身份的记录验证稳定排序的实际效果。
学习目标
- 区分最好、平均、最坏时间复杂度以及额外空间复杂度
- 理解稳定性、原地性与比较排序的准确含义
- 根据数据规模、分布和业务约束选择排序方案
为什么需要多维评价
两个算法即使平均时间复杂度相同,实际表现也可能不同。输入是否接近有序、元素比较是否昂贵、内存是否受限、是否必须保证最坏性能,都会影响最终选择。
排序评价不能脱离前提。比较排序只通过元素之间的比较确定顺序,在决策树模型下,其最坏情况比较次数存在 下界。计数排序、基数排序等非比较算法能突破该下界,但需要整数范围、位数或可分解键等额外条件。
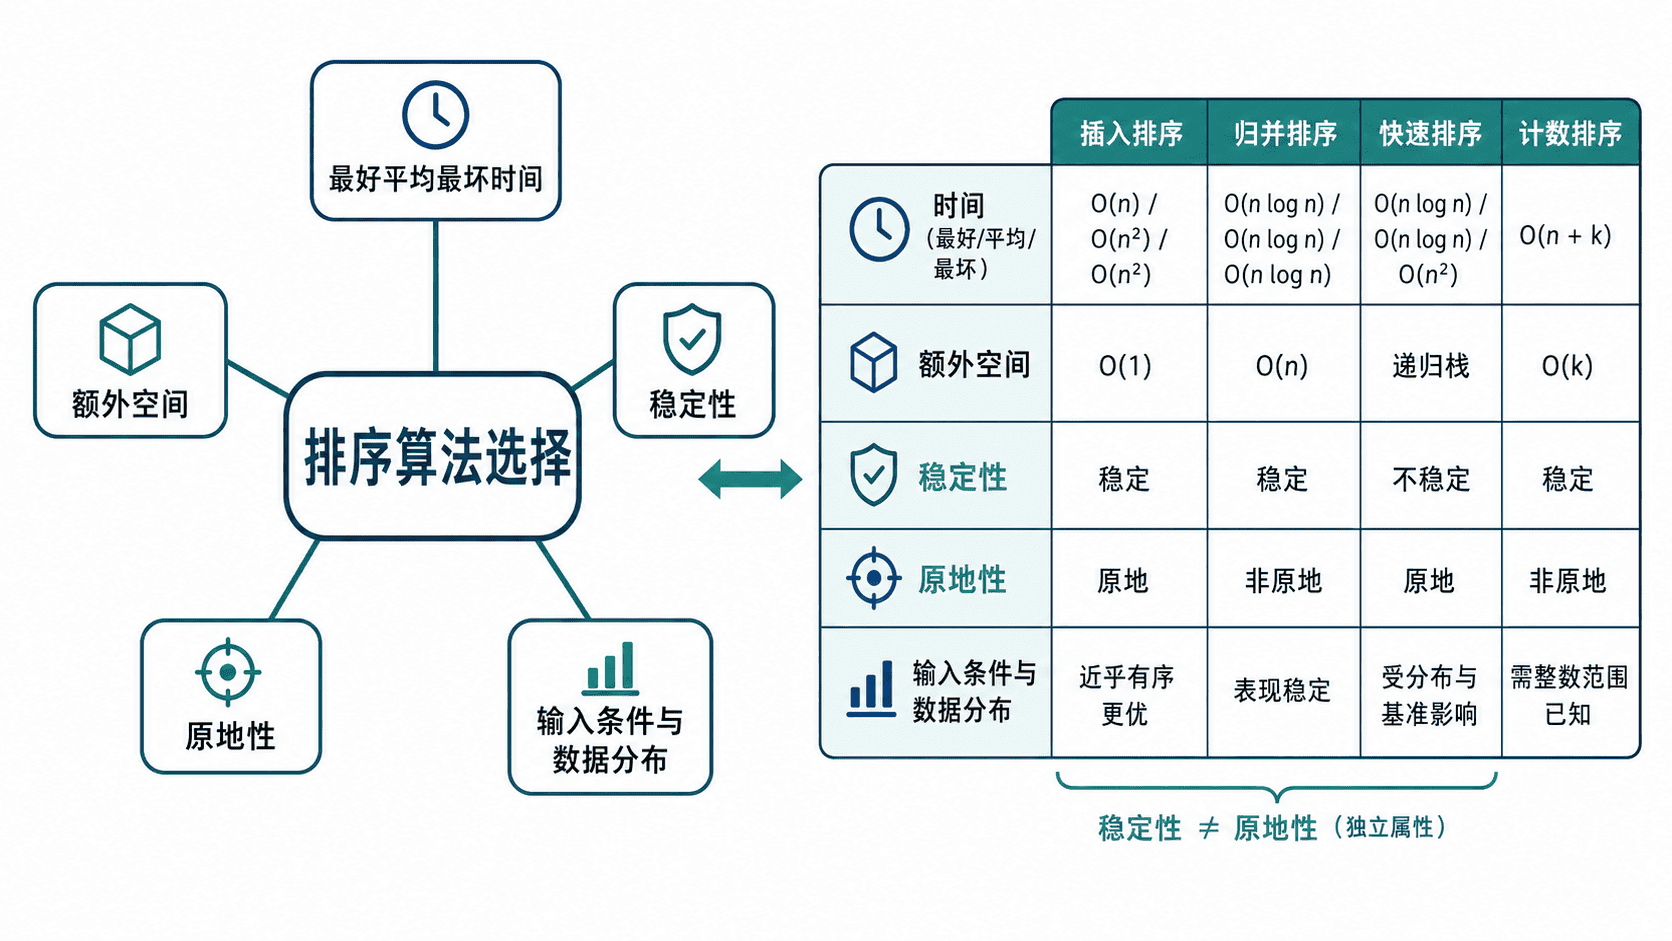
核心指标
时间复杂度应分别关注最好、平均和最坏情况。近乎有序的小数组中,插入排序可能接近 ;而在一般逆序输入上,它仍会退化到 。
空间复杂度关注排序过程额外占用的内存。原地排序通常只使用常数级或少量辅助空间,但“修改原容器”不等于算法一定是严格的 额外空间。
稳定排序会保持相等关键字元素的原相对顺序。它对只有一个数值的数组看不出区别,却会影响“先按时间排序,再按部门排序”这类多关键字业务结果。稳定性与原地性互不推出,必须分别判断。
主示例:验证稳定性
Python 的 sorted() 是稳定排序。下面先按分数排序,相同分数的记录仍保持输入时的先后顺序。
python
records = [
    {"name": "张三", "score": 90},
    {"name": "李四", "score": 80},
    {"name": "王五", "score": 90},
    {"name": "赵六", "score": 80},
]

sorted_records = sorted(
    records,
    key=lambda item: item["score"],
)

print("按分数排序:")
for record in sorted_records:
    print(record["score"], record["name"])

same_score_names = [
    record["name"]
    for record in sorted_records
    if record["score"] == 90
]
print("90 分记录顺序:", same_score_names)
预期输出:
text
按分数排序:
80 李四
80 赵六
90 张三
90 王五
90 分记录顺序: ['张三', '王五']
李四仍在赵六之前,张三仍在王五之前,这说明相同关键字记录的相对顺序被保留。验证稳定性时必须为元素保留不同身份,不能只比较排序后的数值序列。
选择算法时的判断顺序
先确认正确性约束,例如是否需要稳定排序、键是否存在有限范围。再评估数据规模、分布和最坏情况要求,最后考虑额外内存、缓存局部性和实现维护成本。
业务代码通常优先使用语言标准库排序,因为标准库经过充分测试并针对常见数据分布优化。手写排序更适合教学、特殊约束或明确的性能实验,而不应仅凭理论复杂度替换成熟实现。
按自己的节奏,确认真正理解。