
数据结构与算法 / 系统课时
邻接矩阵与邻接表
邻接矩阵与邻接表
同一张图可以用不同结构存储,选择会直接影响空间占用和操作成本。本课用同一组无向边同时构建邻接矩阵与邻接表,比较查边、遍历邻居和增删顶点时的差异,并说明加权图中的无边表示。
学习目标
- 掌握邻接矩阵与邻接表的存储规则
- 比较两种结构的空间复杂度和常见操作成本
- 根据稠密程度与访问模式选择合适表示
两种表示与选择
邻接矩阵使用 的二维数组。位置 [i][j] 表示顶点 i 到顶点 j 是否有边,或保存对应权重。查任意一条边只需一次下标访问,时间为 ,但无论实际边数多少,空间都是 。
邻接表为每个顶点保存邻居集合或邻居列表,空间为 。遍历顶点 u 的全部邻居只需 ;若邻居使用普通列表,判断 u 与 v 是否相连也需 ,使用集合则平均可降到 ,但空间常数更高。
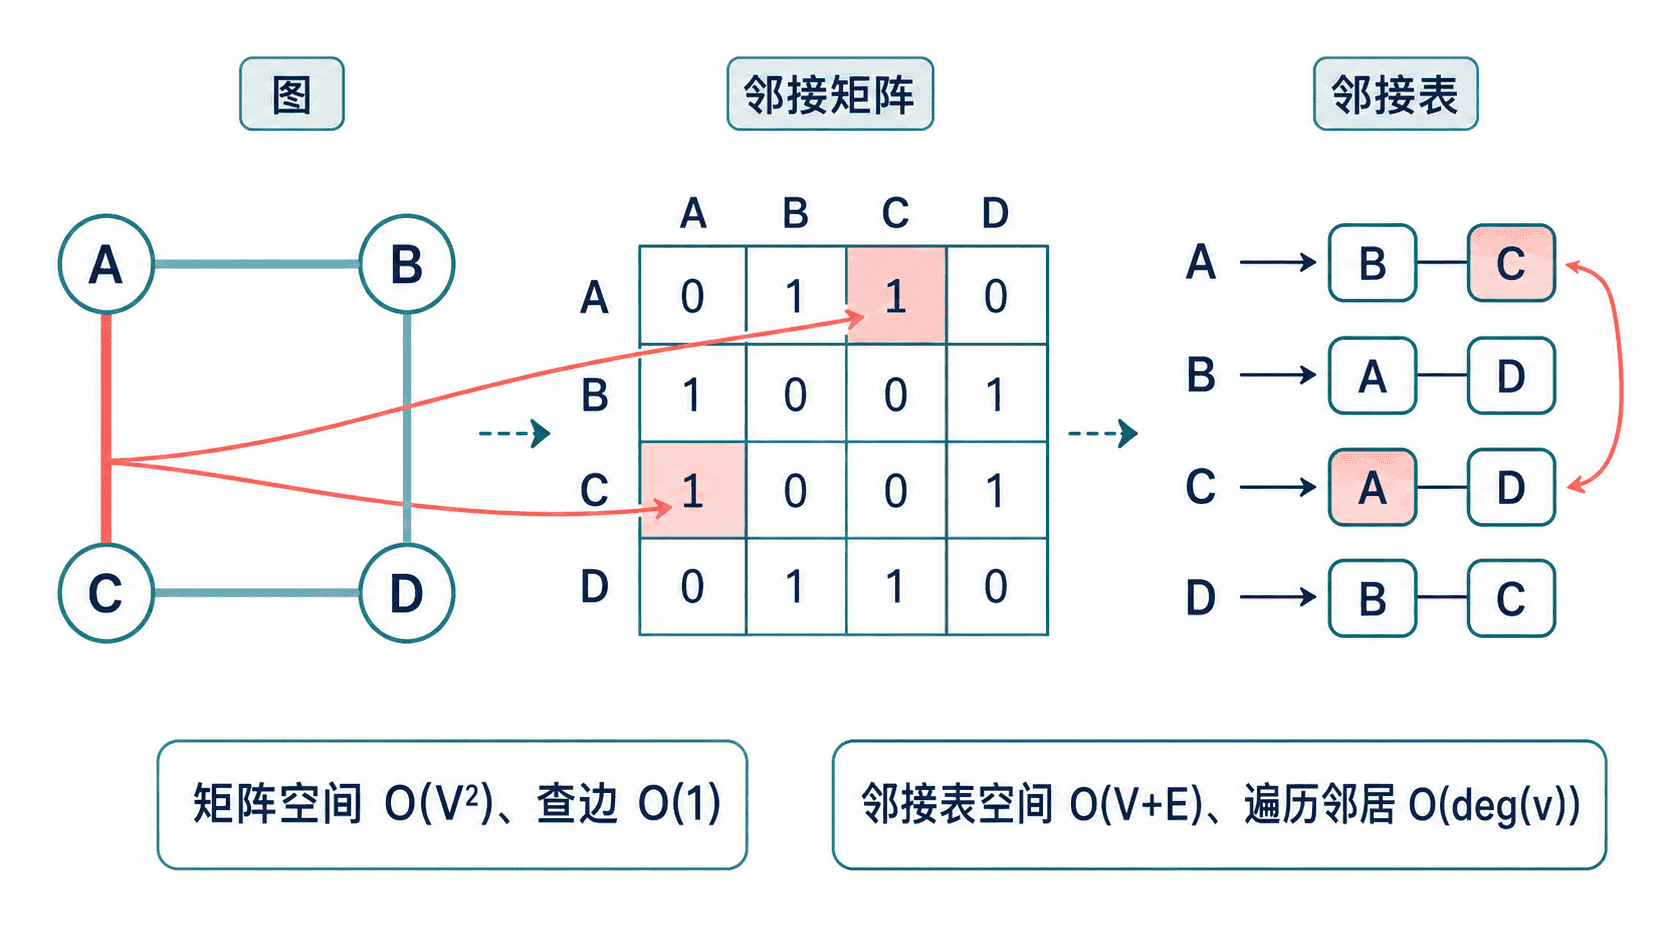
邻接矩阵适合顶点数不大、边较稠密,或算法需要频繁判断任意两点是否直接相连的场景。它的结构规则,缓存局部性也较好,但新增顶点通常需要扩展整张矩阵。
邻接表适合大多数稀疏图,例如道路、社交关系和依赖网络。它只保存实际存在的边,遍历邻居高效,也是 DFS、BFS 和最短路径算法的常见输入形式。
对于无向图,矩阵关于主对角线对称,邻接表则需要把一条边写入两个端点。对于有向图,只记录起点到终点的方向。
主示例:构建并查询
示例为同一张无向图构建两种结构。顶点名称不是连续整数,因此先建立名称到矩阵下标的映射;邻接表使用集合,使查边平均为 。
python
vertices = ["A", "B", "C", "D"]
edges = [("A", "B"), ("A", "C"), ("B", "D")]
index = {vertex: position for position, vertex in enumerate(vertices)}

matrix = [[0] * len(vertices) for _ in vertices]
adjacency = {vertex: set() for vertex in vertices}

for first, second in edges:
    if first not in index or second not in index:
        raise ValueError("edge contains an unknown vertex")

    row = index[first]
    column = index[second]

    # 无向边需要在矩阵和邻接表中同时记录两个方向。
    matrix[row][column] = 1
    matrix[column][row] = 1
    adjacency[first].add(second)
    adjacency[second].add(first)

def has_edge_in_matrix(first, second):
    return matrix[index[first]][index[second]] == 1

def has_edge_in_list(first, second):
    return second in adjacency[first]

print("邻接矩阵:")
for row in matrix:
    print(row)

print(
    "邻接表:",
    {vertex: sorted(adjacency[vertex]) for vertex in vertices},
)
print("A 与 D 直接相连:", has_edge_in_matrix("A", "D"))
print("B 与 D 直接相连:", has_edge_in_list("B", "D"))
预期输出:
text
邻接矩阵:
[0, 1, 1, 0]
[1, 0, 0, 1]
[1, 0, 0, 0]
[0, 1, 0, 0]
邻接表: {'A': ['B', 'C'], 'B': ['A', 'D'], 'C': ['A'], 'D': ['B']}
A 与 D 直接相连: False
B 与 D 直接相连: True
权重与边界
加权矩阵不能在所有场景中都用 0 表示无边,因为合法边权也可能为 0。可改用 None、正无穷或额外布尔矩阵,具体选择取决于算法。
邻接表保存加权边时,可以记录 (neighbor, weight)。若允许重边,同一对顶点之间可能有多条边,此时集合会错误去重,应改用列表或为每条边分配独立标识。
复杂度中的 对无向图通常指逻辑边数。实现邻接表时一条无向边会存两次,因此实际条目数约为 ,但渐进空间仍为 。
按自己的节奏,确认真正理解。