
数据结构与算法 / 系统课时
冒泡、选择与插入排序
冒泡、选择与插入排序
冒泡、选择和插入排序都能在原数组范围内完成排序,但它们移动元素的方式不同。本课用同一组数据实现三种算法,并比较交换次数、稳定性和近乎有序输入下的表现。
学习目标
- 解释相邻交换、选择最小值和插入有序区三种机制
- 编写可运行的三种基础排序并验证结果
- 比较它们的时间复杂度、稳定性与适用场景
三种算法如何移动元素
冒泡排序反复比较相邻元素,把较大值逐步推向右侧。若某一轮没有发生交换,说明数组已经有序,可以提前结束。只在严格大于时交换的常见实现是稳定的。
选择排序每轮在未排序区寻找最小值,再与边界位置交换。它的交换次数最多为 ,但一次跨位置交换可能改变相等元素的原相对顺序,因此普通实现不稳定。
插入排序维护左侧有序区,暂存当前元素,再把更大的元素整体右移,最后插入空位。输入接近有序时,移动次数很少,最好时间复杂度可达到 。
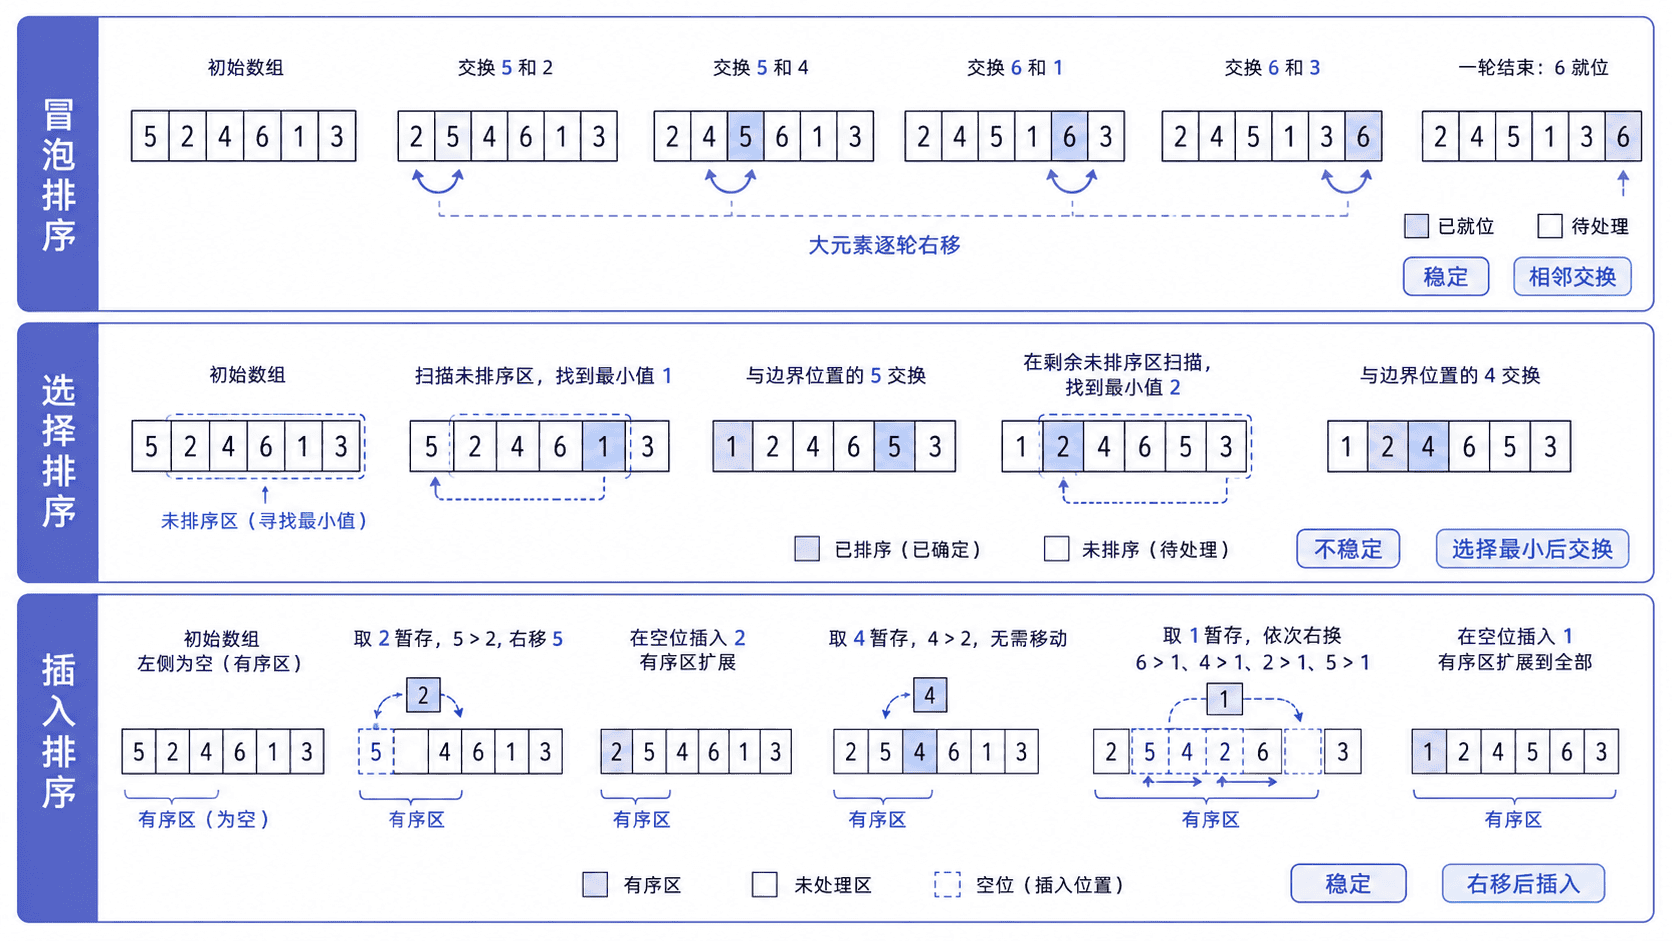
主示例:统一实现与验证
三个函数都先复制输入,便于同时比较结果并确认原数组未被修改。插入排序采用“移动后插入”,避免通过连续交换增加赋值次数。
python
def bubble_sort(values: list[int]) -> list[int]:
    items = values.copy()

    for end in range(len(items) - 1, 0, -1):
        swapped = False
        for index in range(end):
            if items[index] > items[index + 1]:
                items[index], items[index + 1] = (
                    items[index + 1],
                    items[index],
                )
                swapped = True

        # 本轮没有交换,说明前面的区间也已经有序
        if not swapped:
            break

    return items

def selection_sort(values: list[int]) -> list[int]:
    items = values.copy()

    for start in range(len(items) - 1):
        min_index = start
        for index in range(start + 1, len(items)):
            if items[index] < items[min_index]:
                min_index = index

        if min_index != start:
            items[start], items[min_index] = (
                items[min_index],
                items[start],
            )

    return items

def insertion_sort(values: list[int]) -> list[int]:
    items = values.copy()

    for index in range(1, len(items)):
        current = items[index]
        position = index - 1

        # 右移较大元素,为 current 留出插入位置
        while position >= 0 and items[position] > current:
            items[position + 1] = items[position]
            position -= 1

        items[position + 1] = current

    return items

data = [5, 2, 4, 6, 1, 3]

print("冒泡排序:", bubble_sort(data))
print("选择排序:", selection_sort(data))
print("插入排序:", insertion_sort(data))
print("原数组:", data)
预期输出:
text
冒泡排序: [1, 2, 3, 4, 5, 6]
选择排序: [1, 2, 3, 4, 5, 6]
插入排序: [1, 2, 3, 4, 5, 6]
原数组: [5, 2, 4, 6, 1, 3]
对比与适用范围
| 算法 | 最好时间 | 平均、最坏时间 | 额外空间 | 常见稳定性 | 典型特点 |
|---|---|---|---|---|---|
| 冒泡排序 | 稳定 | 可通过无交换提前结束 | |||
| 选择排序 | 不稳定 | 交换次数少,比较次数不减少 | |||
| 插入排序 | 稳定 | 近乎有序或小数组表现较好 |
三者都不适合直接处理大规模随机数据。插入排序常被用作高级排序算法处理小分区的补充;选择排序适合写入或交换成本很高、而比较成本较低的特殊场景;冒泡排序更多用于理解相邻交换和提前终止。
常见错误与边界
冒泡排序访问 index + 1 时必须限制循环上界。插入排序必须先暂存当前元素,否则右移过程会覆盖它。判断稳定性时要使用“关键字相同但身份不同”的记录,单纯观察整数排序结果无法得出结论。
空数组、单元素数组和重复元素都应得到正确结果。这里返回新数组;若业务要求原地修改,可以移除复制操作,但需要明确函数的副作用。
按自己的节奏,确认真正理解。