
数据结构与算法 / 系统课时
归并排序
归并排序
归并排序通过“先拆分、后合并”稳定地完成排序。本课将用一个可运行示例说明递归如何缩小问题、合并如何保持有序,以及为什么它始终具有 的时间复杂度但需要额外空间。
学习目标
- 说明归并排序的拆分、递归与合并过程
- 编写稳定的归并排序并验证结果
- 分析时间复杂度、空间开销与适用场景
核心思路
归并排序把数组持续二分,直到每个子数组至多包含一个元素。单个元素天然有序,随后再逐层合并两个有序子数组。合并时只比较两侧当前元素,因此每一层都只需线性扫描全部数据。
相等元素出现时,若优先取左侧元素,它们在排序前后的相对顺序不会改变,因此归并排序可以保持稳定。数组版本通常需要一个长度为 的辅助空间;链表则可通过调整指针完成合并,更适合使用归并思想。
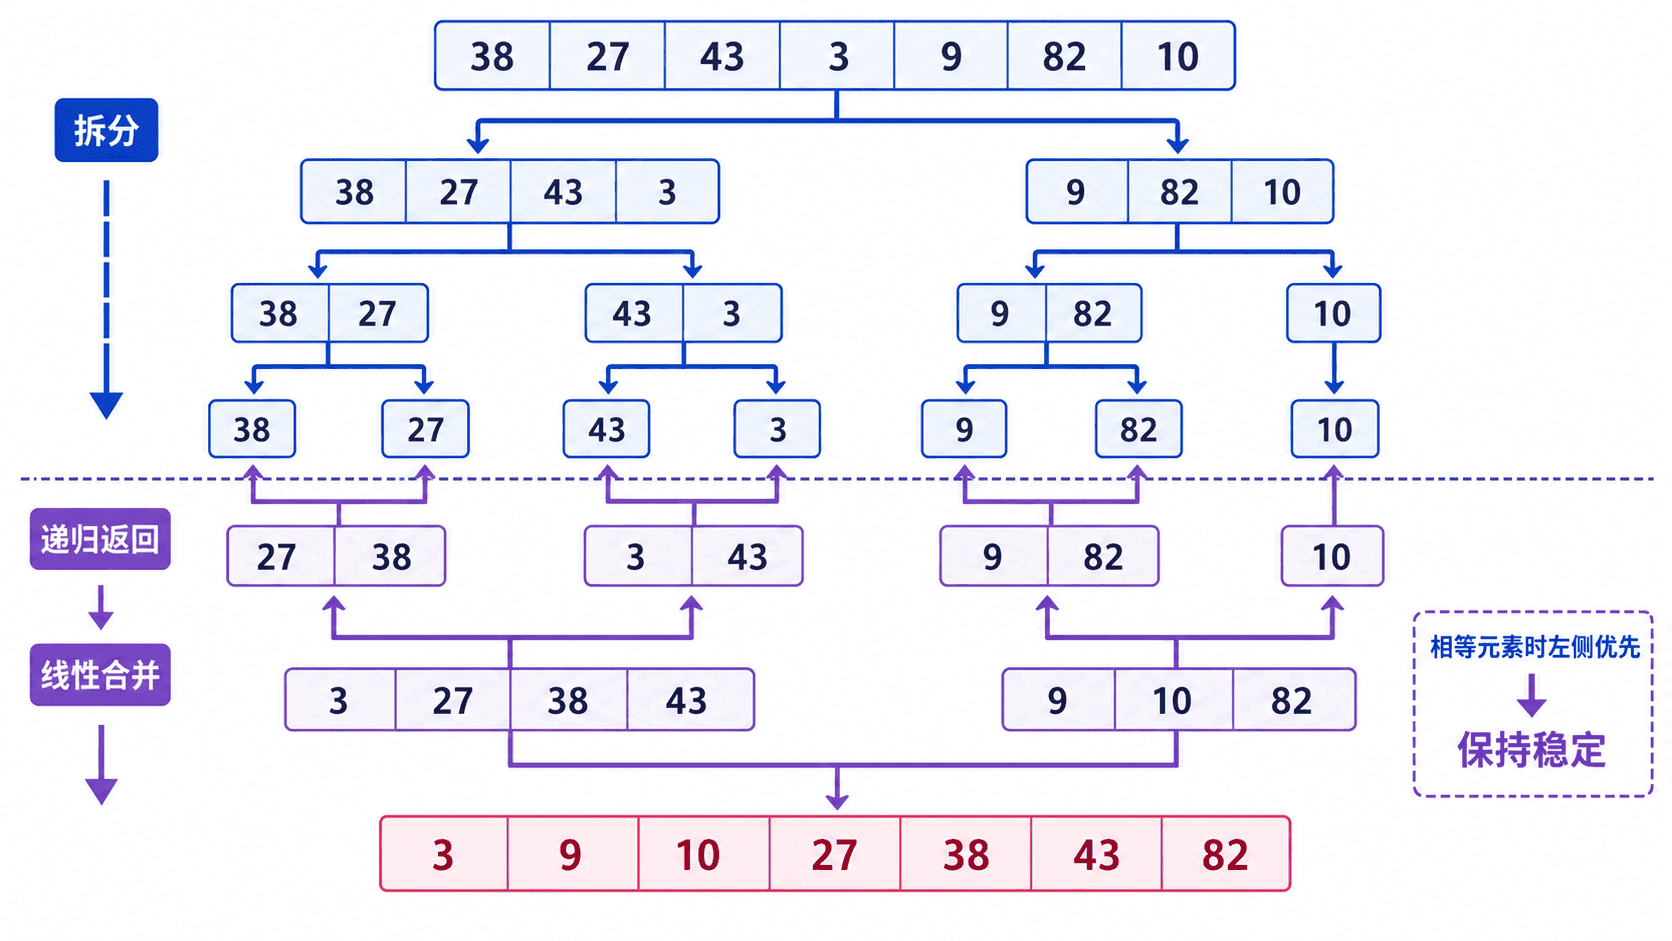
主示例
下面的实现返回一个新数组,不修改原输入。merge 负责合并两个已有序列表,merge_sort 负责递归拆分。
python
def merge(left, right):
    result = []
    i = 0
    j = 0

    # 相等时优先取左侧,保留稳定性。
    while i < len(left) and j < len(right):
        if left[i] <= right[j]:
            result.append(left[i])
            i += 1
        else:
            result.append(right[j])
            j += 1

    # 其中一侧耗尽后,另一侧剩余部分已经有序。
    result.extend(left[i:])
    result.extend(right[j:])
    return result

def merge_sort(values):
    if len(values) <= 1:
        return values.copy()

    middle = len(values) // 2
    left = merge_sort(values[:middle])
    right = merge_sort(values[middle:])
    return merge(left, right)

data = [38, 27, 43, 3, 9, 82, 10]
sorted_data = merge_sort(data)

print("原数组:", data)
print("排序结果:", sorted_data)
预期输出:
text
原数组: [38, 27, 43, 3, 9, 82, 10]
排序结果: [3, 9, 10, 27, 38, 43, 82]
复杂度与边界
数组在每一层合并时共处理 个元素,递归树高度约为 ,因此最好、平均和最坏时间复杂度都是 。示例中的切片和合并结果需要 额外空间,递归栈还需要 空间。
空数组和单元素数组会直接返回。工程实现可复用一个辅助数组,并用下标区间代替切片,从而减少临时对象和复制开销。遗漏剩余元素、缺少递归终止条件,或在相等时先取右侧,都是常见错误。
按自己的节奏,确认真正理解。