
数据结构与算法 / 系统课时
前缀函数与模式匹配
前缀函数与模式匹配
KMP 的核心不是记住代码,而是理解失配后还能保留多少已匹配信息。本课先构建前缀函数,再用它让文本指针始终向前扫描,并支持查找重叠结果。
学习目标
- 理解最长相等真前后缀及前缀函数
- 掌握前缀表的扩展与回退过程
- 使用 KMP 在线性时间内查找全部匹配位置
前缀函数的含义
对模式串 pattern,定义 prefix[i] 为子串 pattern[0..i] 的最长相等真前缀与真后缀长度。“真”表示不能取整个字符串本身。
例如 ABABA 的最长相等真前后缀是 ABA,长度为 3。这个长度表示:当前已匹配部分失配后,不必完全清零,仍可保留一个更短但已经验证过的模式前缀。
构建与匹配机制
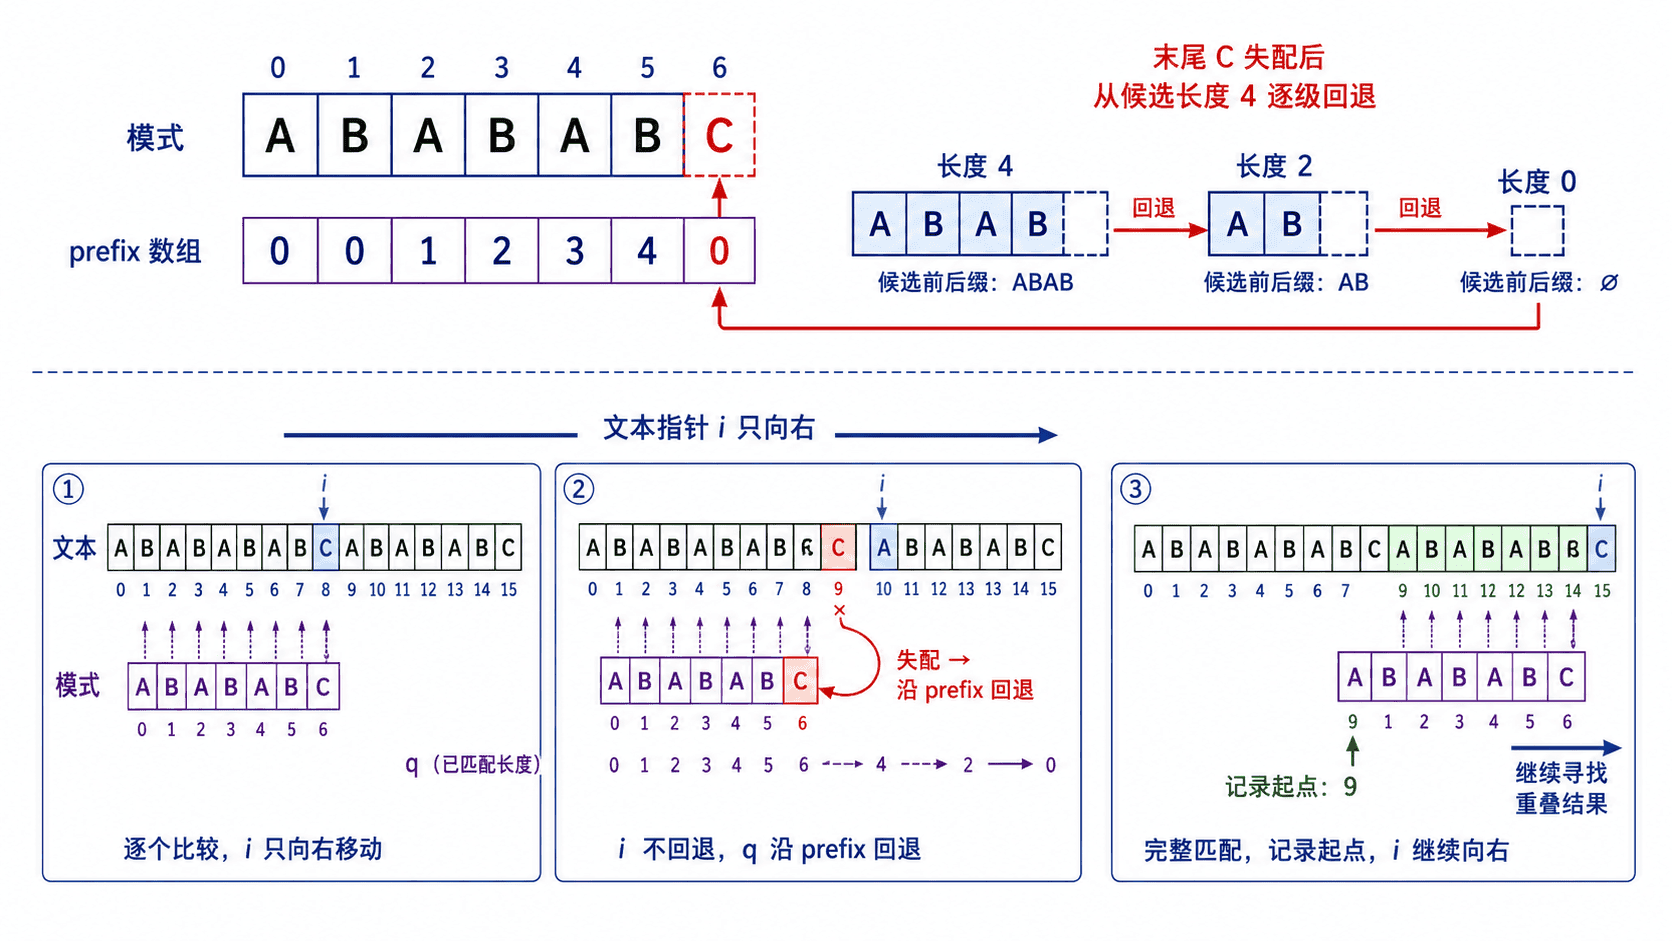
计算 prefix[i] 时,先令候选长度为 prefix[i - 1]。若当前字符与候选前缀的下一个字符不相等,就反复回退到 prefix[matchedLength - 1];若相等,再把长度加一。
扫描文本时使用同样的回退规则。文本下标不后退,只调整“当前已匹配的模式长度”。当长度等于模式串长度时,匹配起点是 i - pattern.length() + 1。记录结果后继续按前缀表回退,便可发现重叠匹配。
完整示例
下面的 Java 17 程序构建前缀表,并返回文本中的全部匹配位置。
import java.util.ArrayList;
import java.util.Arrays;
import java.util.List;

public class PrefixFunctionMatchDemo {

    public static void main(String[] args) {
        String text = "ABABABABCABABABC";
        String pattern = "ABABABC";

        System.out.println("前缀表: "
            + Arrays.toString(buildPrefix(pattern)));
        System.out.println("匹配位置: " + findAll(text, pattern));
    }

    private static int[] buildPrefix(String pattern) {
        int[] prefix = new int[pattern.length()];

        for (int i = 1; i < pattern.length(); i++) {
            int matchedLength = prefix[i - 1];

            // 失配时回到仍可能成立的更短前缀
            while (matchedLength > 0
                && pattern.charAt(i) != pattern.charAt(matchedLength)) {
                matchedLength = prefix[matchedLength - 1];
            }
            if (pattern.charAt(i) == pattern.charAt(matchedLength)) {
                matchedLength++;
            }
            prefix[i] = matchedLength;
        }
        return prefix;
    }

    private static List<Integer> findAll(String text, String pattern) {
        List<Integer> positions = new ArrayList<>();
        if (pattern.isEmpty()) {
            positions.add(0);
            return positions;
        }

        int[] prefix = buildPrefix(pattern);
        int matchedLength = 0;

        for (int i = 0; i < text.length(); i++) {
            while (matchedLength > 0
                && text.charAt(i) != pattern.charAt(matchedLength)) {
                matchedLength = prefix[matchedLength - 1];
            }
            if (text.charAt(i) == pattern.charAt(matchedLength)) {
                matchedLength++;
            }

            if (matchedLength == pattern.length()) {
                positions.add(i - pattern.length() + 1);
                // 不清零,保留可能形成重叠匹配的前缀
                matchedLength = prefix[matchedLength - 1];
            }
        }
        return positions;
    }
}
预期输出:
前缀表: [0, 0, 1, 2, 3, 4, 0]
匹配位置: [2, 9]
复杂度与边界
构建前缀表需要 O(m) 时间,扫描文本需要 O(n) 时间,总时间复杂度为 O(n + m),前缀数组占用 O(m) 空间。虽然代码中存在 while,但匹配长度在整个过程中增加和回退的总次数都是线性的。
前缀函数保存的是长度,不是字符下标,因此回退位置必须写成 prefix[matchedLength - 1]。本课约定空模式串返回位置 [0];业务系统也可以选择返回全部边界位置,但必须提前统一接口语义。
常见错误
失配时简单执行 matchedLength-- 会丢失前缀表提供的跳转信息。完整匹配后直接清零会遗漏重叠结果。KMP 的文本下标始终向前,不应退回已经扫描的位置;否则会破坏线性复杂度。
练习
使用文本 aaaaa 和模式 aaa 验证重叠匹配。完整匹配后按前缀函数回退,结果应为 [0, 1, 2]。