
数据结构与算法 / 系统课时
算法性能基准测试
算法性能基准测试
一次计时不能证明算法更快。本课将建立可重复的 Java 基准流程:固定输入,先预热,再进行多轮测量,校验结果一致,并用中位数而不是偶然的最快值比较实现。
学习目标
- 设计可重复的性能测试流程
- 正确处理预热、结果消费与多轮统计
- 先验证结果一致,再解释性能差异
为什么单次计时不可信
System.nanoTime() 只能提供高精度时间戳,不能自动消除类加载、JIT 编译、垃圾回收和系统调度造成的波动。若两个实现使用不同输入,或计时区域包含日志与数据构造,比较结果也没有意义。
可靠测试应让所有实现处理同一批数据,并把准备阶段、预热阶段、测量阶段和统计阶段分开。
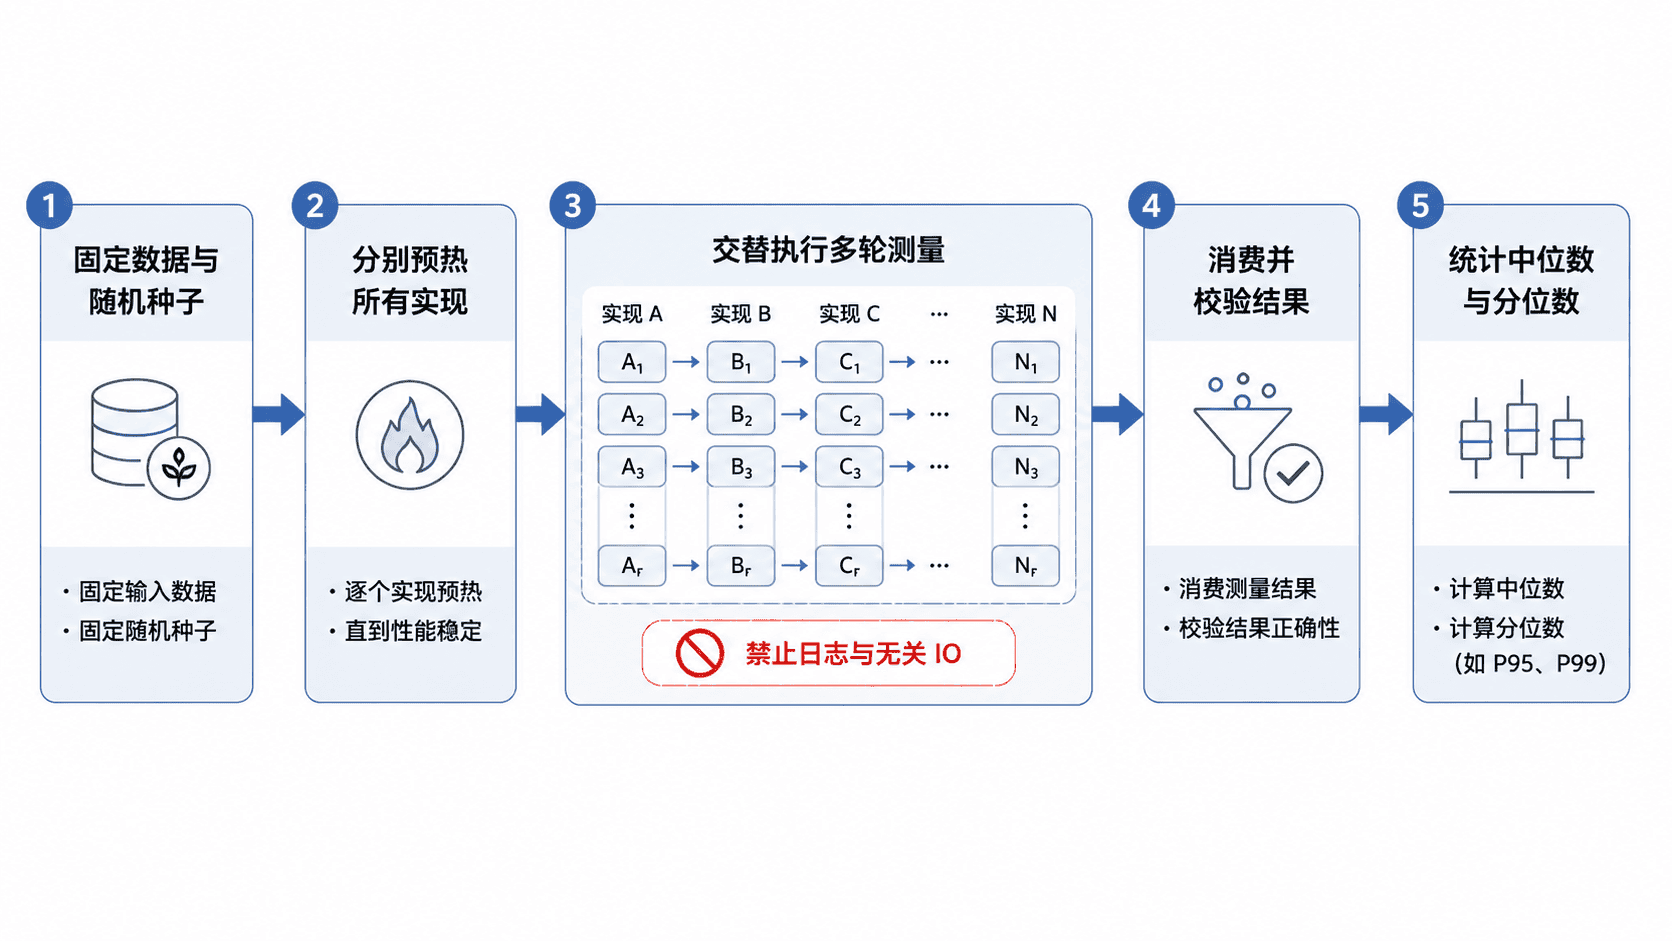
可重复测试流程
先明确指标。单次请求通常关注延迟,批量任务可关注吞吐量;内存占用和对象分配应单独测量,不要与耗时混成一个结论。
测试数据要覆盖规模、命中位置和未命中情况。涉及随机输入时固定种子,确保每次运行得到同一数据。正式计时前执行预热,测量时重复多轮,并保存全部样本后计算中位数。Java 微基准需要更高精度时,应使用 JMH。
主示例
下面的 Java 17 示例比较 ArrayList.contains 与 HashSet.contains。它使用固定随机种子生成查询,先预热,再交替测量 7 轮,并通过 blackhole 消费结果,降低无用计算被优化掉的风险。
java
import java.util.ArrayList;
import java.util.Arrays;
import java.util.HashSet;
import java.util.List;
import java.util.Random;
import java.util.Set;

public class AlgorithmBenchmarkDemo {
    private static volatile int blackhole;

    public static void main(String[] args) {
        int size = 5_000;
        int rounds = 10;
        int[] queries = createQueries(size, 200, 20260802L);

        // 两种实现共享同一数据与查询,避免输入差异污染结果。
        List<Integer> list = new ArrayList<>(size);
        for (int i = 0; i < size; i++) {
            list.add(i);
        }
        Set<Integer> set = new HashSet<>(list);

        // 预热与正式测量分离,让类加载和 JIT 尽量提前发生。
        for (int i = 0; i < 5; i++) {
            blackhole ^= runList(list, queries, rounds);
            blackhole ^= runSet(set, queries, rounds);
        }

        long[] listSamples = new long[7];
        long[] setSamples = new long[7];
        int listMatches = 0;
        int setMatches = 0;

        // 交替测量顺序,降低固定先后顺序带来的系统性偏差。
        for (int i = 0; i < listSamples.length; i++) {
            if (i % 2 == 0) {
                listMatches = measureList(list, queries, rounds, listSamples, i);
                setMatches = measureSet(set, queries, rounds, setSamples, i);
            } else {
                setMatches = measureSet(set, queries, rounds, setSamples, i);
                listMatches = measureList(list, queries, rounds, listSamples, i);
            }
        }

        Arrays.sort(listSamples);
        Arrays.sort(setSamples);
        System.out.println("样本数: " + listSamples.length);
        System.out.println("结果一致: " + (listMatches == setMatches));
        System.out.println("List 中位耗时(ns): " + listSamples[listSamples.length / 2]);
        System.out.println("Set 中位耗时(ns): " + setSamples[setSamples.length / 2]);
    }

    private static int[] createQueries(int size, int count, long seed) {
        Random random = new Random(seed);
        int[] queries = new int[count];
        for (int i = 0; i < count; i++) {
            queries[i] = random.nextBoolean() ? random.nextInt(size) : -random.nextInt(size) - 1;
        }
        return queries;
    }

    private static int measureList(
            List<Integer> list, int[] queries, int rounds, long[] samples, int index) {
        long start = System.nanoTime();
        int matches = runList(list, queries, rounds);
        samples[index] = System.nanoTime() - start;
        // 将结果写入 volatile 字段,避免计算结果完全无人使用。
        blackhole ^= matches;
        return matches;
    }

    private static int measureSet(
            Set<Integer> set, int[] queries, int rounds, long[] samples, int index) {
        long start = System.nanoTime();
        int matches = runSet(set, queries, rounds);
        samples[index] = System.nanoTime() - start;
        blackhole ^= matches;
        return matches;
    }

    private static int runList(List<Integer> list, int[] queries, int rounds) {
        int matches = 0;
        for (int r = 0; r < rounds; r++) {
            for (int query : queries) {
                if (list.contains(query)) {
                    matches++;
                }
            }
        }
        return matches;
    }

    private static int runSet(Set<Integer> set, int[] queries, int rounds) {
        int matches = 0;
        for (int r = 0; r < rounds; r++) {
            for (int query : queries) {
                if (set.contains(query)) {
                    matches++;
                }
            }
        }
        return matches;
    }
}
将代码保存为 AlgorithmBenchmarkDemo.java,再编译运行:
bash
javac AlgorithmBenchmarkDemo.java
java AlgorithmBenchmarkDemo预期输出结构如下,<NANOS> 是随机器和运行状态变化的实际纳秒数:
text
样本数: 7
结果一致: true
List 中位耗时(ns): <NANOS>
Set 中位耗时(ns): <NANOS>
结果解读与边界
示例可以说明固定数据、预热、多轮采样和结果校验,但它仍不是严格微基准框架。不要仅凭一次运行断言固定倍数,也不要把不同机器的绝对耗时直接比较。
若要发布可信结论,应使用 JMH 控制预热、分叉进程和统计方式,同时报告 JDK、硬件、数据规模、输入分布与样本数量。对短任务还要关注对象分配和 GC,避免只看 CPU 时间。
按自己的节奏,确认真正理解。