
数据结构与算法 / 系统课时
图的深度优先遍历
图的深度优先遍历
深度优先遍历会沿一条分支尽可能深入,无法继续时再回退探索其他分支。图可能含环、重复到达路径和多个连通分量,因此正确实现必须管理访问标记,并在需要遍历整张图时从未访问顶点重新启动。
学习目标
- 理解 DFS 的深入、回退和访问标记机制
- 使用递归 DFS 遍历不连通无向图
- 分析遍历顺序、复杂度与递归栈风险
DFS 的执行过程
从起点开始,DFS 先标记当前顶点,再依次访问尚未访问的邻居。每进入一个邻居,就重复相同过程;当当前顶点没有未访问邻居时,函数返回到上一层,继续处理剩余分支。
访问标记必须在递归调用前完成。若等递归返回后才标记,带环图中的相邻顶点会反复进入彼此,最终造成无限递归。
一次 DFS 只能覆盖起点所在的连通分量。要遍历整张不连通图,需要在外层扫描全部顶点,对每个尚未访问的顶点启动一次新的 DFS。
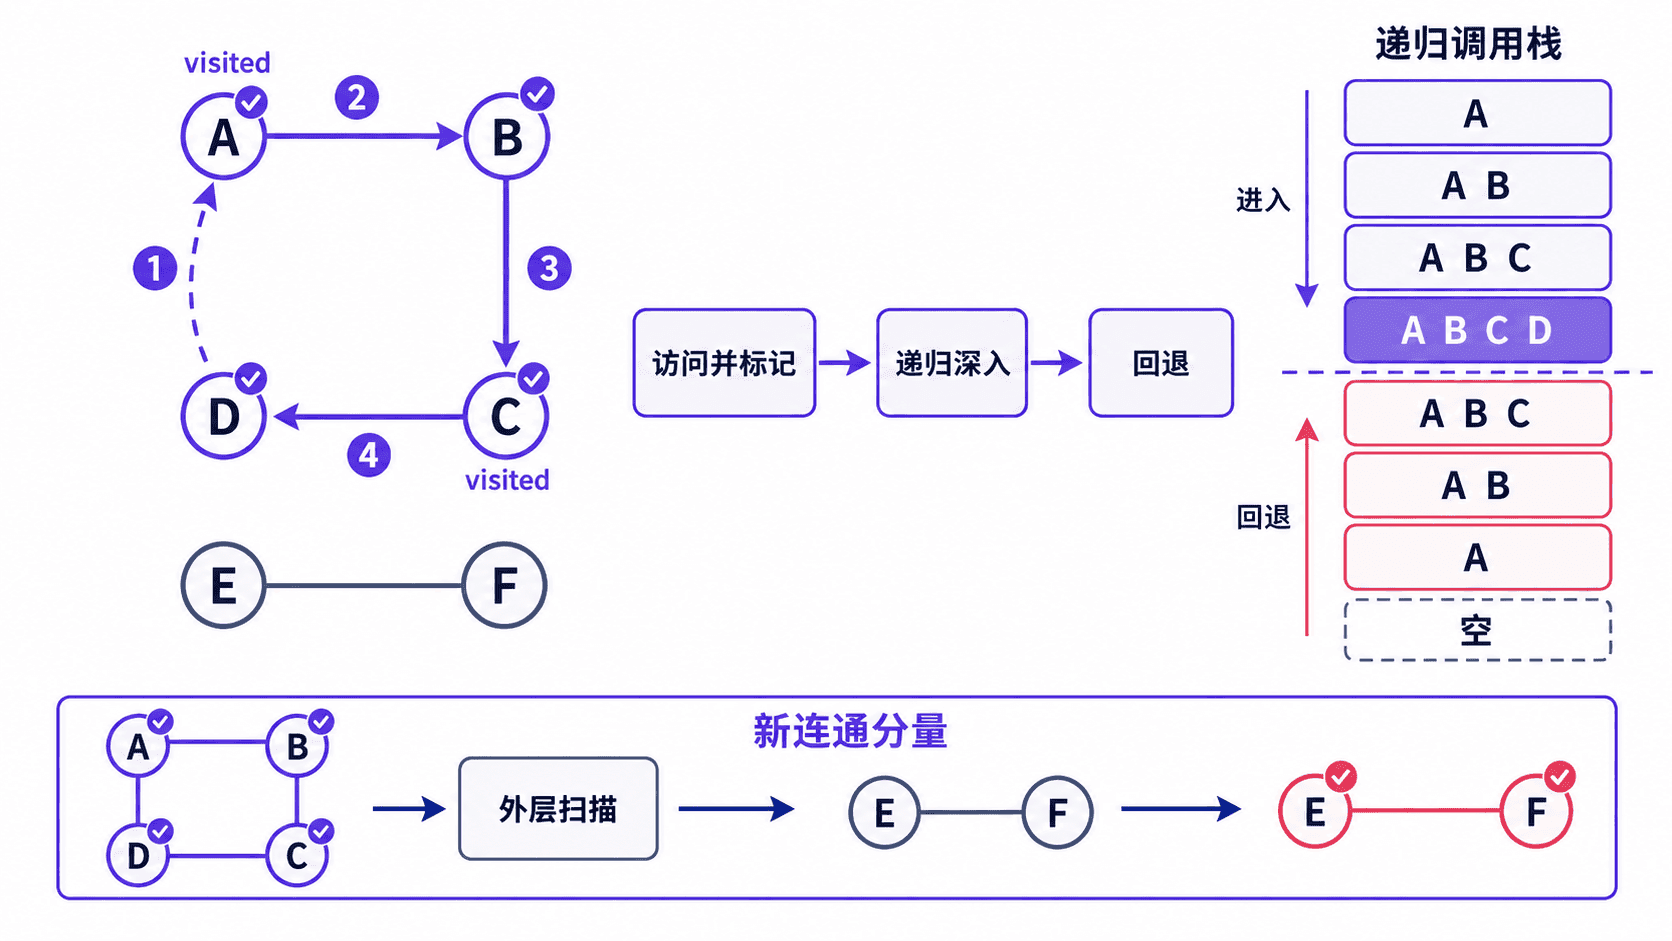
主示例:遍历全部连通分量
为使结果可重复,示例按字母顺序扫描顶点和邻居。component 保存一次 DFS 覆盖的顶点,外层循环负责发现新的连通分量。
python
graph = {
    "A": ["B", "C"],
    "B": ["A", "D"],
    "C": ["A", "D"],
    "D": ["B", "C"],
    "E": ["F"],
    "F": ["E"],
}

def dfs(vertex, visited, component):
    # 进入顶点时立即标记,阻止环和重复路径再次进入。
    visited.add(vertex)
    component.append(vertex)

    for neighbor in sorted(graph[vertex]):
        if neighbor not in visited:
            dfs(neighbor, visited, component)

visited = set()
components = []

for vertex in sorted(graph):
    if vertex in visited:
        continue

    component = []
    dfs(vertex, visited, component)
    components.append(component)

print("DFS 连通分量:", components)
print("连通分量数量:", len(components))
print("访问顶点数量:", len(visited))
预期输出:
text
DFS 连通分量: [['A', 'B', 'D', 'C'], ['E', 'F']]
连通分量数量: 2
访问顶点数量: 6
邻居顺序会影响 DFS 的访问序列,例如先访问 C 可能得到另一种顺序,但只要每个顶点恰好访问一次,连通分量结果仍然正确。
复杂度、用途与边界
使用邻接表时,每个顶点最多被访问一次,每条无向边会从两个端点各检查一次,所以时间复杂度为 。visited、结果和递归调用栈的总额外空间最坏为 。
递归写法直观,但一条很深的链可能超过语言的递归深度限制。此时可以改用显式栈。为了模拟递归版的访问顺序,通常要按相反顺序把邻居压栈,并在压栈时或出栈时采用一致的标记策略。
DFS 常用于连通分量、环检测、拓扑排序、强连通分量和回溯搜索。不同问题需要额外状态:例如无向图检测环时要记录父节点,有向图检测环时要区分“当前递归路径中”和“已经完成”的顶点。
图的 DFS 与树的 DFS 最大区别是图可能回到已访问顶点,因此 visited 不是可选优化,而是保证终止和正确性的必要条件。
按自己的节奏,确认真正理解。