
数据结构与算法 / 系统课时
图的广度优先遍历
图的广度优先遍历
图的广度优先遍历适合按“离起点有多远”逐层搜索。本课将用队列完成遍历,并在无权图中记录距离与前驱,最终得到从起点到目标节点的最少边数和一条对应路径。
学习目标
- 理解 BFS 的分层扩展机制与入队标记原则
- 使用距离表和前驱表求解无权图最短路径
- 分析邻接表实现的时间、空间复杂度与不可达边界
问题定义与适用条件
给定一个无权图、起点和目标点,需要找到经过边数最少的路径。BFS 每次先处理距离起点更近的节点,因此某个节点第一次被发现时,已经获得最少边数。
这里的“无权”也包括所有边权相同的情况。若不同边的代价不同,BFS 不能保证总代价最小,应改用 Dijkstra 等算法。
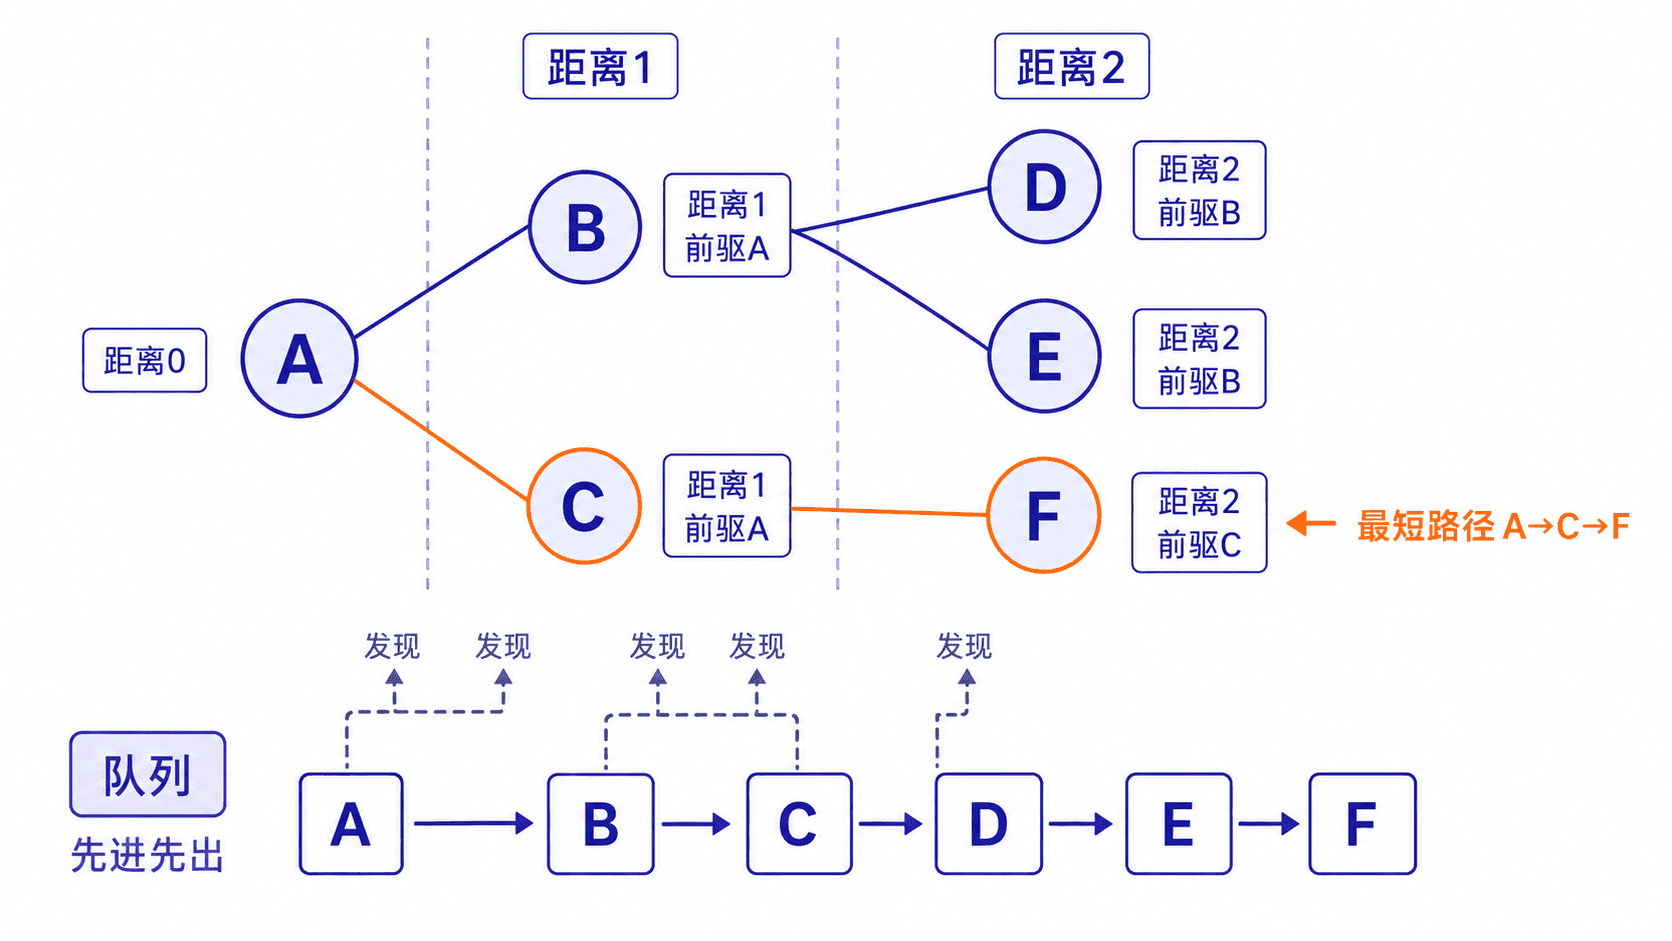
分层遍历机制
队列保证先入队的节点先处理。起点先以距离 0 入队;处理当前节点时,只把尚未发现的邻居加入队列,并把邻居距离设置为当前距离加 1。
访问标记必须在入队时完成,而不是等到出队。否则同一节点可能被多个前驱重复加入队列,既浪费空间,也会让前驱记录变得混乱。
前驱表保存“这个节点第一次从哪里到达”。找到目标后,从目标沿前驱反向回溯到起点,再反转序列即可还原路径。存在多条最短路径时,结果取决于邻接表中的邻居顺序。
主示例:求最少边数与路径
python
from collections import deque
from typing import Optional

def shortest_path(
    graph: dict[str, list[str]],
    start: str,
    target: str,
) -> tuple[Optional[int], Optional[list[str]]]:
    if start not in graph or target not in graph:
        raise ValueError("起点和目标点必须存在于图中")

    queue = deque([start])
    distance = {start: 0}
    previous: dict[str, Optional[str]] = {start: None}

    while queue:
        current = queue.popleft()
        if current == target:
            break

        for neighbor in graph[current]:
            # 入队时立即标记,避免同一节点重复进入队列
            if neighbor not in distance:
                distance[neighbor] = distance[current] + 1
                previous[neighbor] = current
                queue.append(neighbor)

    if target not in distance:
        return None, None

    path = []
    current: Optional[str] = target
    while current is not None:
        path.append(current)
        current = previous[current]

    path.reverse()
    return distance[target], path

graph = {
    "A": ["B", "C"],
    "B": ["A", "D", "E"],
    "C": ["A", "F"],
    "D": ["B"],
    "E": ["B", "F"],
    "F": ["C", "E"],
}

distance, path = shortest_path(graph, "A", "F")
print("最短距离:", distance)
print("最短路径:", path)
预期输出:
text
最短距离: 2
最短路径: ['A', 'C', 'F']
复杂度与关键边界
使用邻接表时,每个可达节点至多入队一次,每条边至多被扫描一次,时间复杂度为 ,距离表、前驱表和队列的空间复杂度为 。
目标不可达时应返回空结果,而不是强行回溯。对于非连通图,从一个起点执行 BFS 只会访问该连通分量;若要遍历整张图,需要从每个尚未访问的节点重新启动一次 BFS。
按自己的节奏,确认真正理解。