
数据结构与算法 / 系统课时
字符串的存储与比较
字符串的存储与比较
字符串算法首先要明确“下标访问的到底是什么”。本课从 Java String 的不可变性出发,说明 UTF-16 代码单元与 Unicode 代码点的区别,并实现一个基础字典序比较器。
学习目标
- 理解
String、char与 Unicode 代码点之间的关系 - 正确区分内容相等、引用相等和字典序比较
- 实现边界完整的逐位置字符串比较
Java 字符串的存储视角
String 是不可变字符序列。执行拼接、替换等操作时,原对象内容不会被原地修改,变量通常会改为指向一个新结果。频繁修改文本应使用 StringBuilder,需要按位置改写字符时可复制为 char[]。
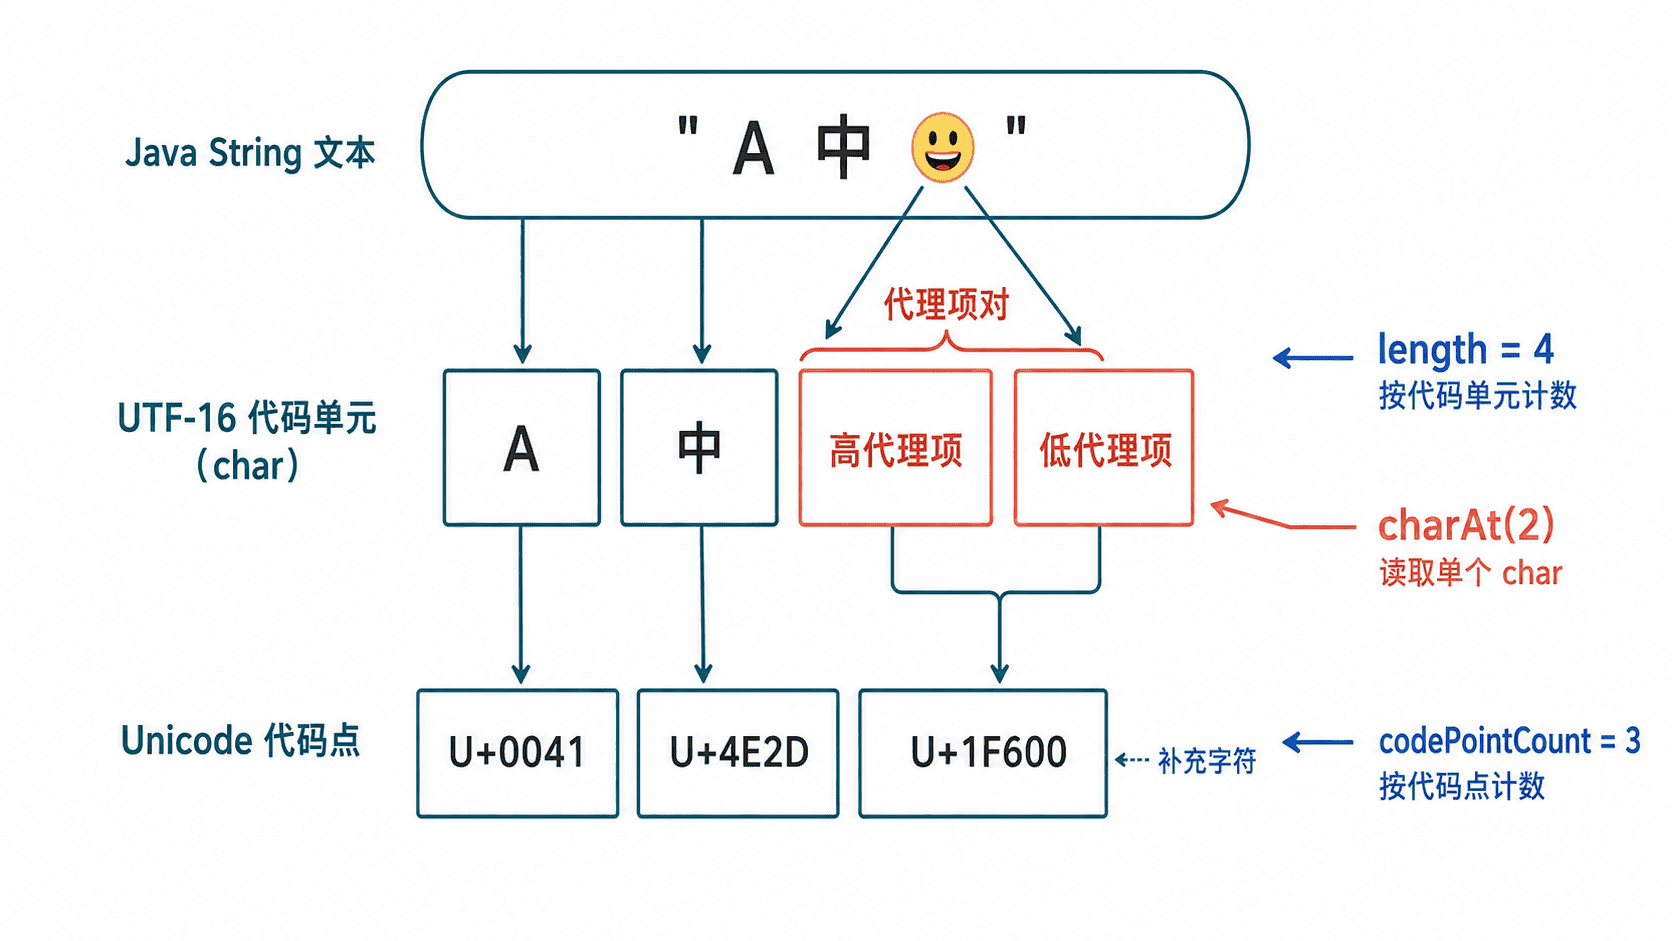
Java 的 char 表示一个 16 位 UTF-16 代码单元。许多常见中英文字符只占一个代码单元,但部分补充字符需要一对代理项。因此:
length()返回 UTF-16 代码单元数量。charAt(index)返回指定位置的一个代码单元。codePointCount(begin, end)返回范围内的 Unicode 代码点数量。
相等与字典序
equals 比较内容,== 比较引用是否指向同一对象。业务逻辑判断文本内容时应使用 equals;可能出现 null 时可使用 Objects.equals(first, second)。
字典序比较从左向右进行:先寻找第一个不同的代码单元;若存在差异,由该位置决定顺序;若公共前缀完全相同,则较短字符串更小。比较结果只需要关注负数、零和正数,不应依赖某个固定绝对值。
完整示例
下面的 Java 17 程序实现与 String.compareTo 相同的基础 UTF-16 代码单元比较规则,并展示代码单元数量与代码点数量的差异。
public class StringStorageCompareDemo {

    public static void main(String[] args) {
        String first = "Java";
        String second = "Javascript";
        String mixed = "算法😀";

        System.out.println("手工比较: " + manualCompare(first, second));
        System.out.println("compareTo: " + first.compareTo(second));
        System.out.println("UTF-16 长度: " + mixed.length());
        System.out.println("代码点数量: "
            + mixed.codePointCount(0, mixed.length()));
    }

    private static int manualCompare(String first, String second) {
        int limit = Math.min(first.length(), second.length());

        // 先寻找公共范围内的第一个不同代码单元
        for (int i = 0; i < limit; i++) {
            char left = first.charAt(i);
            char right = second.charAt(i);
            if (left != right) {
                return left - right;
            }
        }

        // 公共前缀相同时,由长度决定顺序
        return first.length() - second.length();
    }
}
预期输出:
手工比较: -6
compareTo: -6
UTF-16 长度: 4
代码点数量: 3
Java 是 Javascript 的前缀,因此比较结果来自长度差。算法😀 包含三个代码点,但表情符号占两个 UTF-16 代码单元,所以 length() 返回 4。
使用边界
toCharArray() 会创建并复制一个新数组,时间和空间复杂度均为 O(n)。length() 与 charAt() 为常数时间;equals 和 compareTo 在最坏情况下需要扫描公共部分,时间复杂度为 O(min(n, m)) 或 O(n)。
若业务要求按自然语言规则排序,代码单元顺序通常不够,应使用带语言环境的 Collator。若需要处理用户可见的“字素簇”,仅按代码点仍可能不完整,还要考虑组合字符和规范化规则。
常见错误
使用 == 判断内容可能因字符串常量池而偶尔得到看似正确的结果,但它并不等价于内容比较。逐字符扫描时,循环上限必须取两个长度的较小值;否则较短字符串会发生越界。把 length() 直接解释为用户可见字符数,也会在补充字符场景中出错。