
数据结构与算法 / 系统课时
字符串哈希
字符串哈希
字符串哈希把字符串映射为整数,可用于快速筛选相等子串。通过前缀哈希预处理,任意子串的哈希值都能在常数时间内计算;本课将实现双哈希,并明确哈希相等不等于内容绝对相等。
学习目标
- 理解多项式哈希与前缀哈希数组
- 使用左闭右开区间计算子串哈希
- 正确处理取模减法、溢出与哈希冲突
从逐字符比较到前缀哈希
若反复比较同一文本中的子串,直接调用逐字符比较会重复扫描内容。前缀哈希先用 O(n) 时间保存每个前缀的状态,随后可用 O(1) 计算任意区间的哈希值。
设字符数值为 value,滚动计算规则为 hash = hash * BASE + value。同时维护 power[i] = BASE^i mod MOD,即可消除区间左侧前缀的贡献。
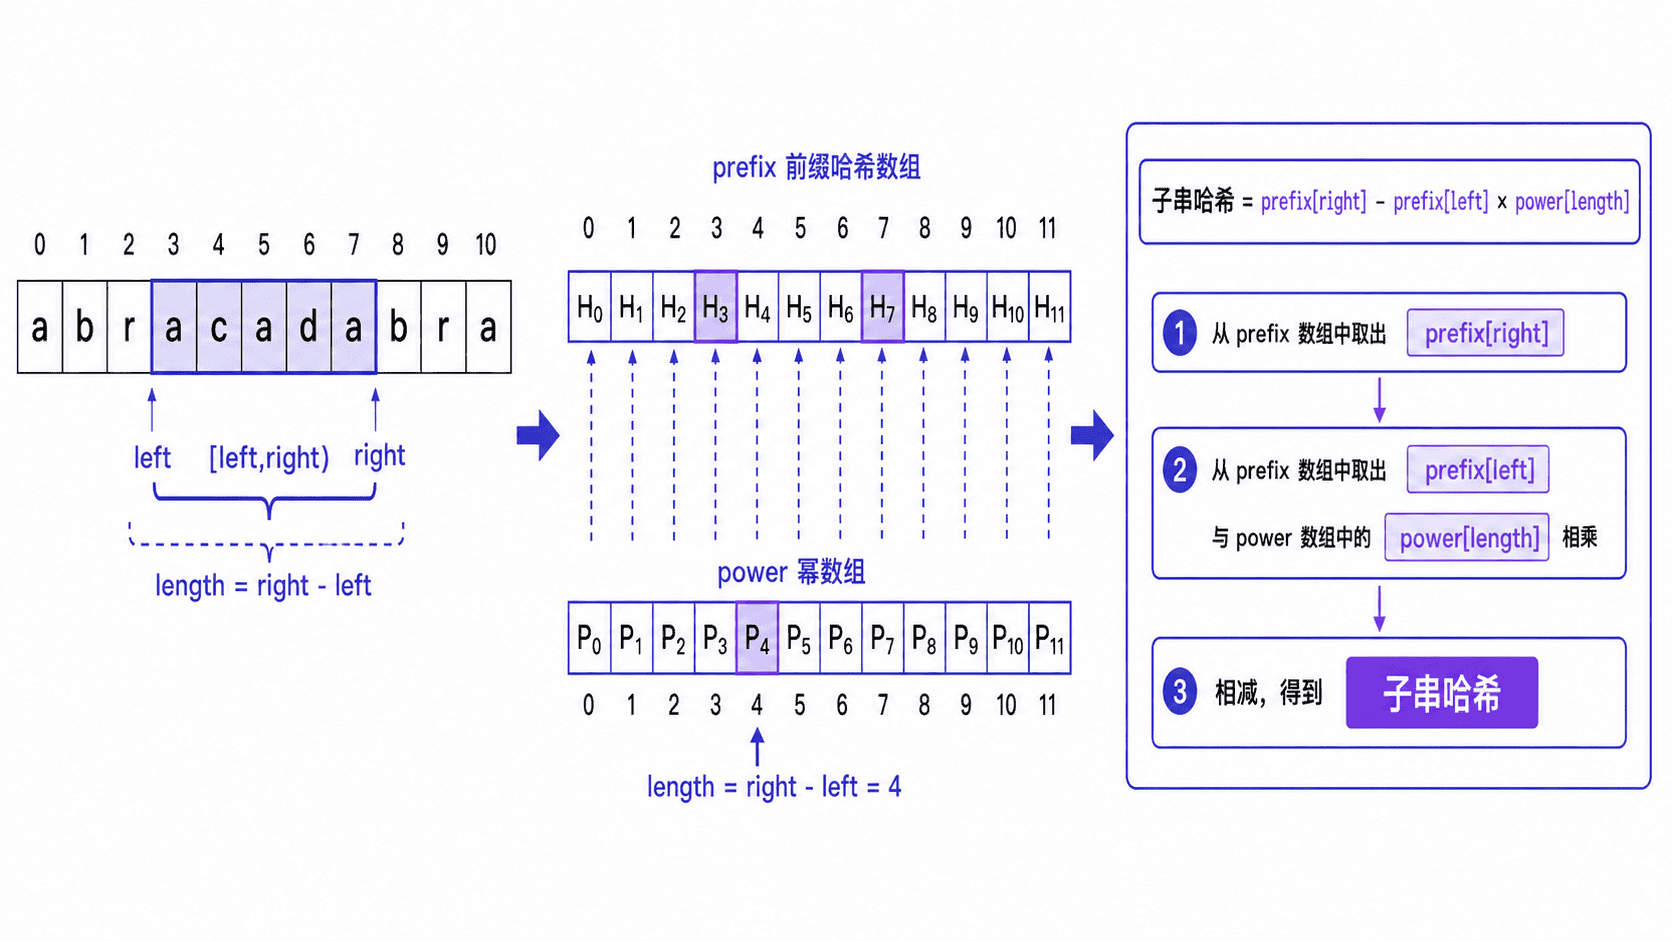
区间公式与边界
定义 prefix[i] 为前 i 个 UTF-16 代码单元的哈希,则区间 [left, right) 的长度为 right - left,其哈希为:
实际计算必须在每一步取模。Java 的 % 可能保留负号,因此减法后要先加模数再取模。中间乘法使用 long,避免 int 溢出。
本课按 UTF-16 代码单元计算,与 String.substring 的下标语义一致。若系统需要按 Unicode 代码点切分文本,应先转换为代码点数组,并让区间下标统一基于代码点。
完整可运行示例
java
public class StringHashDemo {
    private static final long BASE = 131L;
    private static final long MOD1 = 1_000_000_007L;
    private static final long MOD2 = 1_000_000_009L;

    private record HashPair(long first, long second) {
    }

    private static class DoubleHash {
        private final long[] prefix1;
        private final long[] prefix2;
        private final long[] power1;
        private final long[] power2;

        DoubleHash(String text) {
            if (text == null) {
                throw new IllegalArgumentException("text 不能为空");
            }

            int n = text.length();
            prefix1 = new long[n + 1];
            prefix2 = new long[n + 1];
            power1 = new long[n + 1];
            power2 = new long[n + 1];
            power1[0] = 1;
            power2[0] = 1;

            for (int i = 0; i < n; i++) {
                int value = text.charAt(i) + 1;
                prefix1[i + 1] = (prefix1[i] * BASE + value) % MOD1;
                prefix2[i + 1] = (prefix2[i] * BASE + value) % MOD2;
                power1[i + 1] = power1[i] * BASE % MOD1;
                power2[i + 1] = power2[i] * BASE % MOD2;
            }
        }

        HashPair hash(int left, int right) {
            if (left < 0 || left > right || right >= prefix1.length) {
                throw new IndexOutOfBoundsException("非法区间");
            }

            int length = right - left;
            long first = normalize(
                prefix1[right] - prefix1[left] * power1[length] % MOD1,
                MOD1
            );
            long second = normalize(
                prefix2[right] - prefix2[left] * power2[length] % MOD2,
                MOD2
            );
            return new HashPair(first, second);
        }

        private static long normalize(long value, long mod) {
            return (value + mod) % mod;
        }
    }

    public static void main(String[] args) {
        String text = "abracadabra";
        DoubleHash hash = new DoubleHash(text);

        HashPair first = hash.hash(0, 4);
        HashPair second = hash.hash(7, 11);
        HashPair third = hash.hash(3, 7);

        System.out.println("[0,4): " + text.substring(0, 4));
        System.out.println("[7,11): " + text.substring(7, 11));
        System.out.println("前两个区间哈希相等: " + first.equals(second));
        System.out.println("[3,7): " + text.substring(3, 7));
        System.out.println("第一与第三区间哈希相等: " + first.equals(third));
    }
}
将代码保存为 StringHashDemo.java,然后执行:
bash
javac StringHashDemo.java
java StringHashDemo
预期输出:
text
[0,4): abra
[7,11): abra
前两个区间哈希相等: true
[3,7): acad
第一与第三区间哈希相等: false
两个 abra 位于不同位置,但区间公式完成了幂次对齐,因此双哈希一致;acad 内容不同,双哈希也不同。
冲突与使用边界
不同字符串可能映射到同一哈希值,这称为哈希冲突。双哈希通过两个独立模数显著降低碰撞概率,但不能从数学上消除碰撞。
在重复子串检测、去重索引等一般场景中,双哈希通常用于快速筛选;在权限、计费、签名校验等高正确性场景中,哈希相等后仍应比较真实字符内容。字符串哈希也不是密码学哈希,不能用于密码保存或安全签名。
按自己的节奏,确认真正理解。