
数据结构与算法 / 系统课时
根据数据规模选择算法
根据数据规模选择算法
算法选择不能只看当前样例是否运行成功,而要看最大输入、调用次数和资源限制。本课将把复杂度代入具体规模,比较一次性处理与大量查询的总成本,并说明为什么“理论更优”仍需要目标环境验证。
学习目标
- 根据输入上限估算主要操作数量
- 比较时间、空间与预处理成本
- 用规模分析筛除明显不可行的方案
先确定规模变量
常见变量不只有元素数量 n,还包括查询次数 q、图中的边数 m、字符串总长度以及并发请求量。评估时应使用业务上限,而不是当前测试数据的平均值。
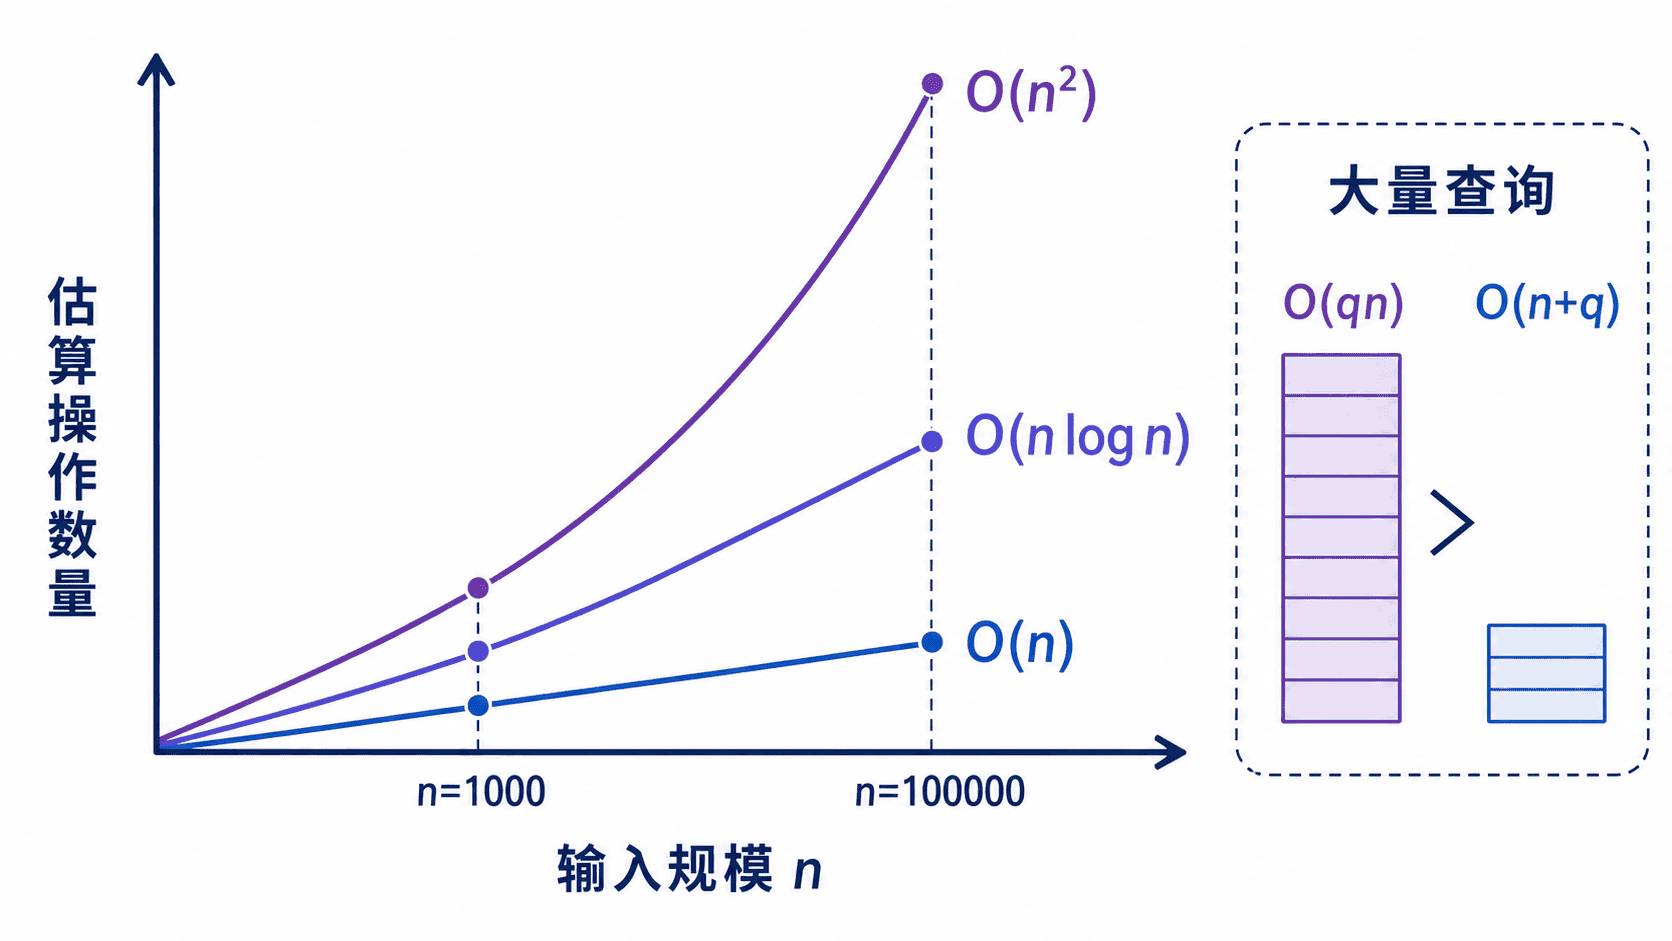
以 n = 100000 为例,平方级算法约需要 10^10 次基本操作,而 n log n 的数量级约为 1.7 × 10^6。常数因子会影响实际耗时,但无法弥补数量级差距。
比较总成本而非单次成本
若一个数组只查询一次,线性扫描可能已经足够;若同一数据需要查询十万次,建立索引或预处理通常更划算。
例如,逐次扫描的总成本约为 q × n,先预处理再常数时间查询的总成本约为 n + q。预处理是否值得,取决于 q 是否足以摊薄一次性成本。
空间也必须纳入评估。哈希表可把平均查询降为常数时间,但需要额外内存,并可能产生装箱、对象头和扩容开销。内存受限时,排序后二分可能比哈希索引更稳妥。
完整可运行示例
下面的程序不测量易受机器影响的耗时,而是计算几个候选方案的数量级,用于第一轮方案筛选。
public class AlgorithmScaleDemo {
    public static void main(String[] args) {
        evaluate(1_000, 10);
        evaluate(100_000, 100_000);
    }

    private static void evaluate(long n, long q) {
        double quadratic = (double) n * n;
        double nLogN = n * log2(n);
        double repeatedScan = (double) n * q;
        double preprocessAndQuery = n + (double) q;

        System.out.printf("n=%d, q=%d%n", n, q);
        System.out.printf("O(n^2) 估算: %.0f%n", quadratic);
        System.out.printf("O(n log n) 估算: %.0f%n", nLogN);
        System.out.printf("重复线性查询 O(qn): %.0f%n", repeatedScan);
        System.out.printf("预处理后查询 O(n+q): %.0f%n", preprocessAndQuery);
        System.out.println(
            repeatedScan > preprocessAndQuery * 100
                ? "建议:优先评估预处理或索引方案"
                : "建议:简单扫描可能已经足够"
        );
        System.out.println();
    }

    private static double log2(long value) {
        return Math.log(value) / Math.log(2);
    }
}
将代码保存为 AlgorithmScaleDemo.java,然后执行:
javac AlgorithmScaleDemo.java
java AlgorithmScaleDemo
预期输出中的小数会按当前格式四舍五入:
n=1000, q=10
O(n^2) 估算: 1000000
O(n log n) 估算: 9966
重复线性查询 O(qn): 10000
预处理后查询 O(n+q): 1010
建议:简单扫描可能已经足够

n=100000, q=100000
O(n^2) 估算: 10000000000
O(n log n) 估算: 1660964
重复线性查询 O(qn): 10000000000
预处理后查询 O(n+q): 200000
建议:优先评估预处理或索引方案
第一组数据中,两种查询方案虽然有差距,但绝对规模仍小;第二组的差距达到多个数量级,应优先考虑索引、哈希或其他预处理方案。
从估算走向工程验证
复杂度分析用于排除明显不可行的方案,不能直接替代基准测试。数据分布、缓存命中、对象分配、JIT 预热和并发竞争都会影响实际结果。
验证时应使用接近生产的数据规模和分布,分别记录吞吐、延迟、峰值内存与最坏情况。若程序根据阈值切换两种算法,还必须验证两条分支的结果完全一致,并通过基准确定阈值,而不是凭经验写死。