
数据结构与算法 / 系统课时
哈希表的基本结构
哈希表的基本结构
本课拆解哈希表从键到桶的完整查找过程,并用链地址法实现一个简化映射。你将看到平均 并非“直接命中”,而是先缩小到目标桶,再通过键相等判断确认结果。
学习目标
- 理解键、哈希值、桶和键值对之间的关系
- 掌握插入、更新与查找的基本流程
- 区分平均 与最坏
从键到桶的查找路径
哈希函数先把键转换为整数哈希值,再通过取模或位运算映射到有限数量的桶。由于键空间远大于桶数量,不同键可能进入同一桶,这种情况称为哈希冲突。
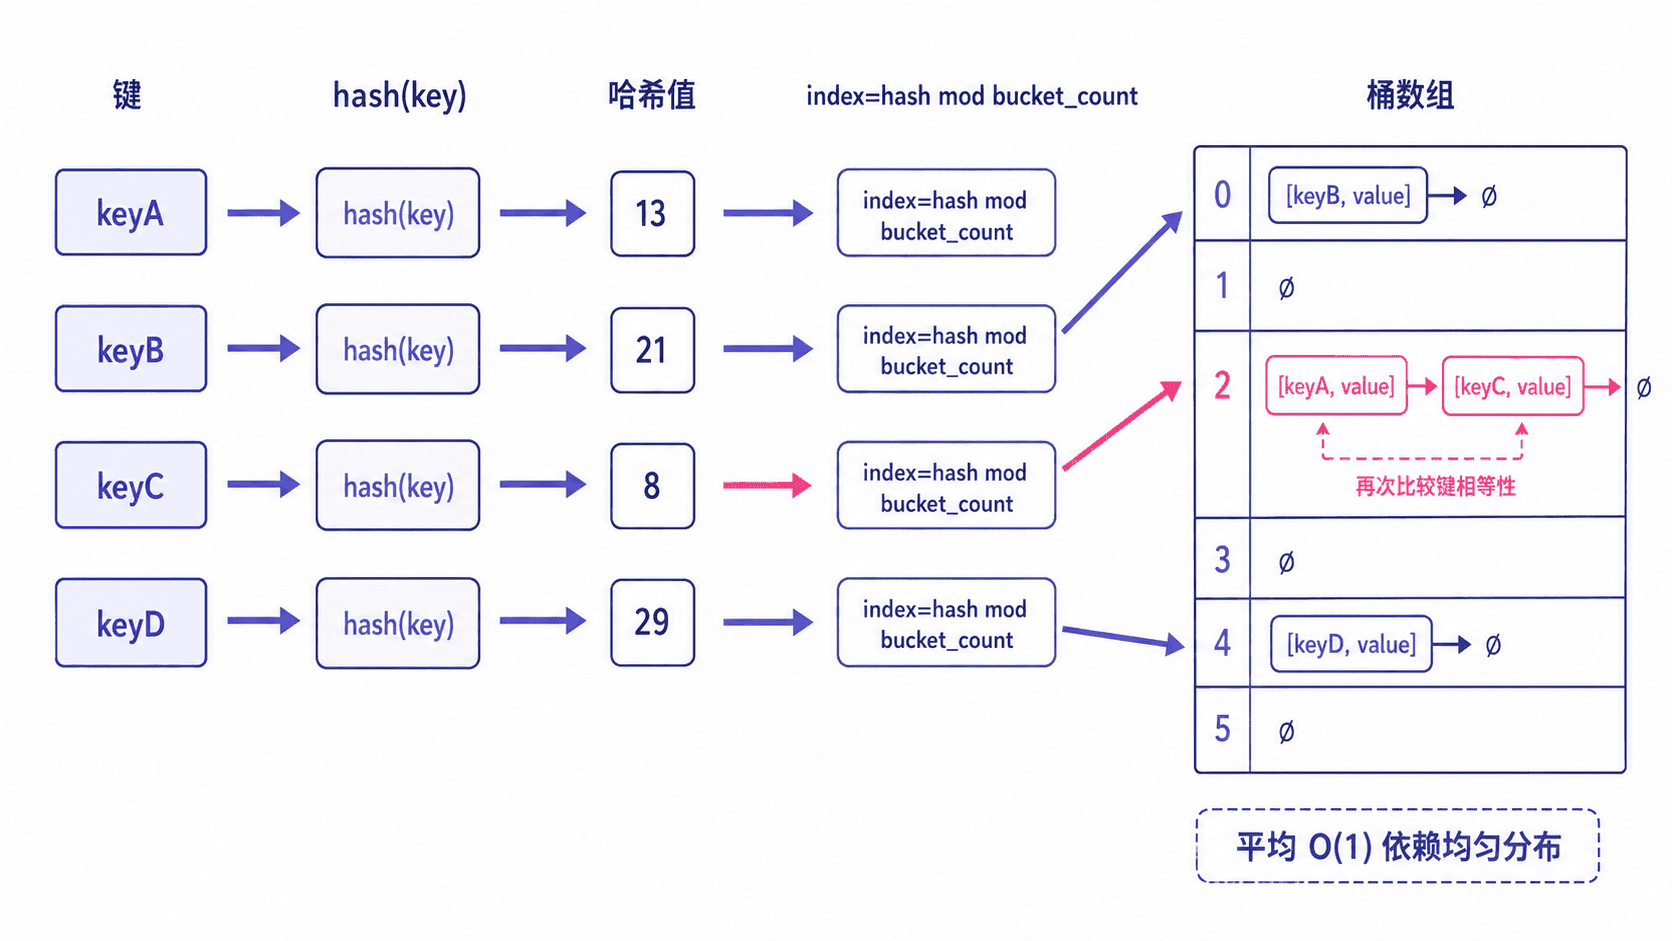
查找不能只比较哈希值。冲突键可能拥有相同哈希结果,因此定位桶后,仍需逐项比较保存的键是否与目标键相等。插入时找到同键就更新值,未找到才新增键值对。
主示例
下面实现固定桶数量的简化哈希表。每个桶使用列表保存键值对,这种冲突处理方式称为链地址法。
python
from typing import Generic, Optional, TypeVar

K = TypeVar("K")
V = TypeVar("V")

class SimpleHashMap(Generic[K, V]):
    def __init__(self, bucket_count: int = 8) -> None:
        if bucket_count <= 0:
            raise ValueError("bucket_count 必须大于 0")
        self._buckets: list[list[tuple[K, V]]] = [
            [] for _ in range(bucket_count)
        ]

    def _index(self, key: K) -> int:
        return hash(key) % len(self._buckets)

    def put(self, key: K, value: V) -> None:
        bucket = self._buckets[self._index(key)]
        for index, (stored_key, _) in enumerate(bucket):
            # 哈希值只能定位桶,最终必须比较键本身。
            if stored_key == key:
                bucket[index] = (key, value)
                return
        bucket.append((key, value))

    def get(self, key: K) -> Optional[V]:
        bucket = self._buckets[self._index(key)]
        for stored_key, value in bucket:
            if stored_key == key:
                return value
        return None

    def contains(self, key: K) -> bool:
        bucket = self._buckets[self._index(key)]
        return any(stored_key == key for stored_key, _ in bucket)

def main() -> None:
    scores = SimpleHashMap[str, int]()
    scores.put("alice", 90)
    scores.put("bob", 85)
    scores.put("alice", 95)

    print("alice 分数:", scores.get("alice"))
    print("包含 bob:", scores.contains("bob"))
    print("包含 carol:", scores.contains("carol"))

if __name__ == "__main__":
    main()
预期输出:
text
alice 分数: 95
包含 bob: True
包含 carol: False
复杂度与键约束
当哈希分布均匀、负载合理时,每个桶通常只含少量元素,插入和查找平均为 。若大量键集中到同一桶,桶内扫描会退化为 ;实际实现通常通过扩容降低负载。
作为键的对象在存入后必须保持哈希相关状态稳定。若键内容变化导致哈希值改变,后续查找会计算出不同桶位置,可能再也找不到原条目。Python 的列表可变且不可哈希,因此不能直接作为字典键。
按自己的节奏,确认真正理解。