
数据结构与算法 / 系统课时
二叉树的深度优先遍历
二叉树的深度优先遍历
深度优先遍历沿一条分支尽可能向下,再回退处理其他分支。本课用一个统一递归函数实现前序、中序和后序遍历,重点理解“访问根节点”在递归流程中的不同位置。
学习目标
- 说清前序、中序和后序遍历的访问规则
- 使用递归实现三种深度优先遍历
- 分析遍历的时间复杂度与递归空间
三种顺序的本质
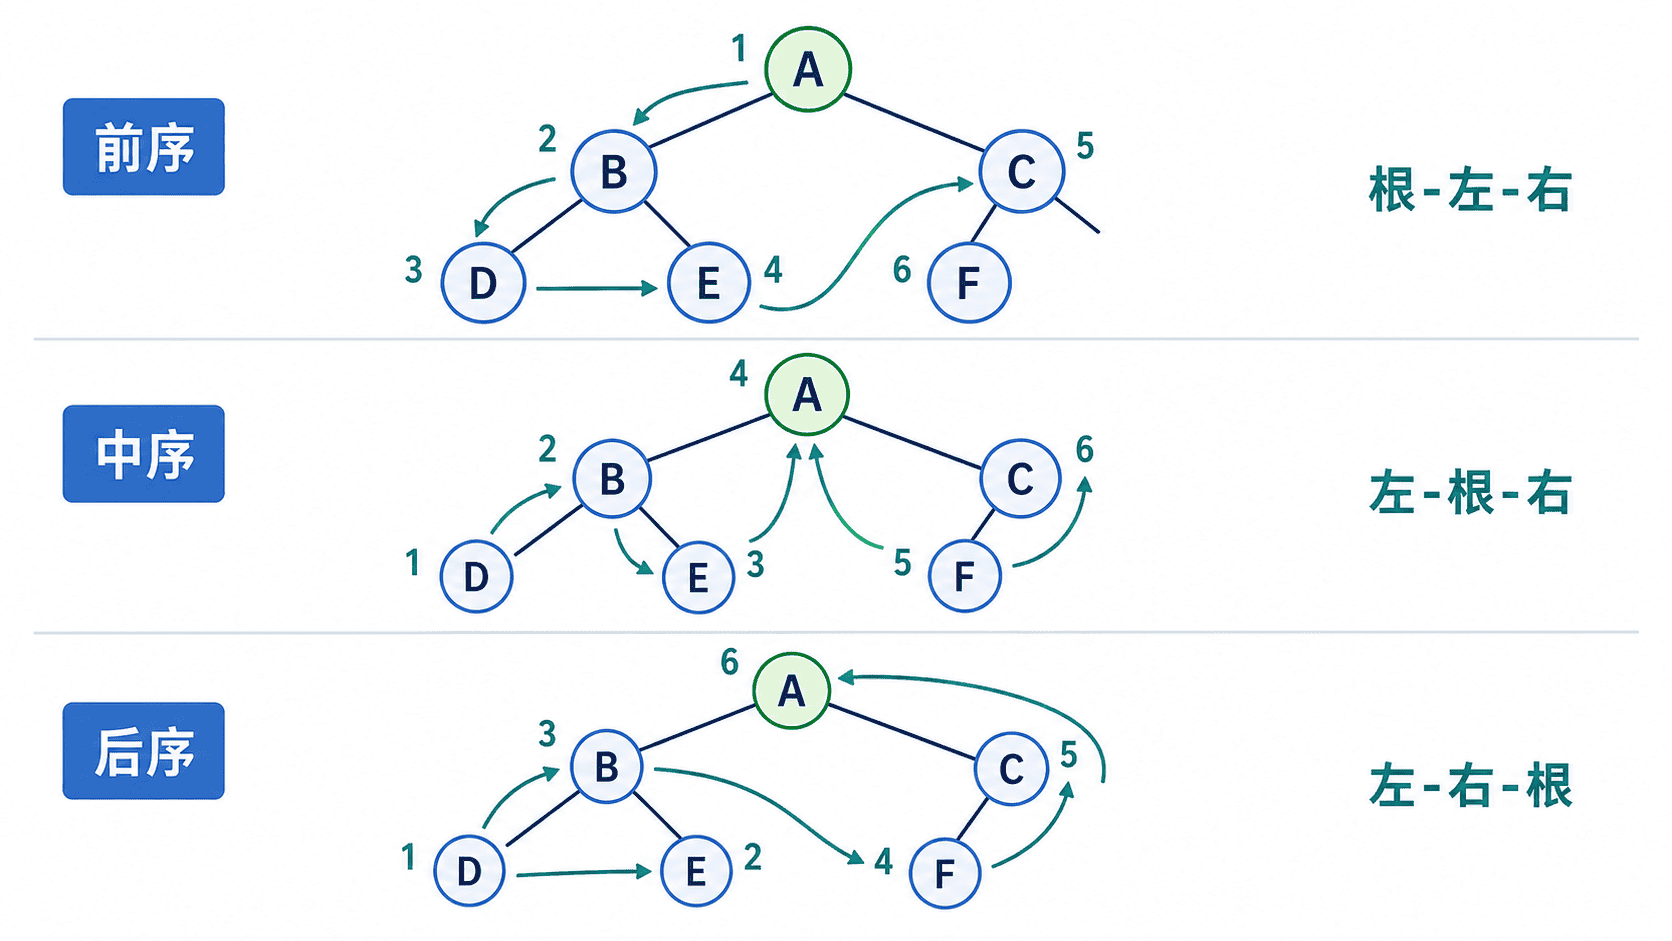
递归处理二叉树时始终包含三个动作:处理当前根节点、遍历左子树、遍历右子树。三种遍历只改变“处理根节点”的时机:
- 前序:根、左、右
- 中序:左、根、右
- 后序:左、右、根
空节点是递归终止条件。前序适合先记录结构,中序遍历二叉搜索树可得到升序序列,后序适合先得到子树结果再汇总当前节点。
统一递归框架
与其维护三份高度重复的代码,可以把遍历顺序作为参数。递归函数进入节点、完成左子树、完成右子树三个时点,正好对应前序、中序和后序的访问位置。
主示例:一个函数完成三种遍历
python
class Node:
    def __init__(self, value, left=None, right=None):
        self.value = value
        self.left = left
        self.right = right

def traverse(node, order):
    if order not in {"pre", "in", "post"}:
        raise ValueError("order 必须是 pre、in 或 post")

    result = []

    def dfs(current):
        if current is None:
            return

        # 根节点的记录位置决定遍历类型
        if order == "pre":
            result.append(current.value)

        dfs(current.left)

        if order == "in":
            result.append(current.value)

        dfs(current.right)

        if order == "post":
            result.append(current.value)

    dfs(node)
    return result

root = Node(
    "A",
    Node("B", Node("D"), Node("E")),
    Node("C", None, Node("F")),
)

print("前序:", traverse(root, "pre"))
print("中序:", traverse(root, "in"))
print("后序:", traverse(root, "post"))
预期输出
text
前序: ['A', 'B', 'D', 'E', 'C', 'F']
中序: ['D', 'B', 'E', 'A', 'C', 'F']
后序: ['D', 'E', 'B', 'F', 'C', 'A']
复杂度与使用边界
无论采用哪种顺序,每个节点都恰好访问一次,因此时间复杂度为 。递归栈深度等于当前根到叶子的路径长度,空间复杂度为 ;平衡树中通常为 ,退化成链表时为 。
中序结果只有在二叉搜索树满足左子树值小于根、右子树值大于根等排序约束时才天然有序。普通二叉树使用中序遍历,并不能保证输出有序。
按自己的节奏,确认真正理解。