
数据结构与算法 / 系统课时
二分查找与边界定位
二分查找与边界定位
二分查找的难点不是“每次砍掉一半”,而是统一区间定义并准确处理重复元素。本课使用左闭右开区间实现 lower_bound、upper_bound 和目标范围查找。
学习目标
- 使用左闭右开区间编写二分模板
- 定位第一个不小于和第一个大于目标的位置
- 正确区分命中位置与插入位置
统一边界模型
设搜索区间为 [left, right),其中 right 不参与搜索。循环条件使用 left < right,每轮都保证候选区间严格缩小。查找第一个大于等于目标的位置时,中点值小于目标,说明答案只能在右侧;否则中点仍可能是答案,因此保留在右侧边界中。
lower_bound 返回第一个大于等于目标的位置,upper_bound 返回第一个大于目标的位置。二者即使未命中,也会返回合法插入位置,因此调用方必须继续检查下标范围和元素值。
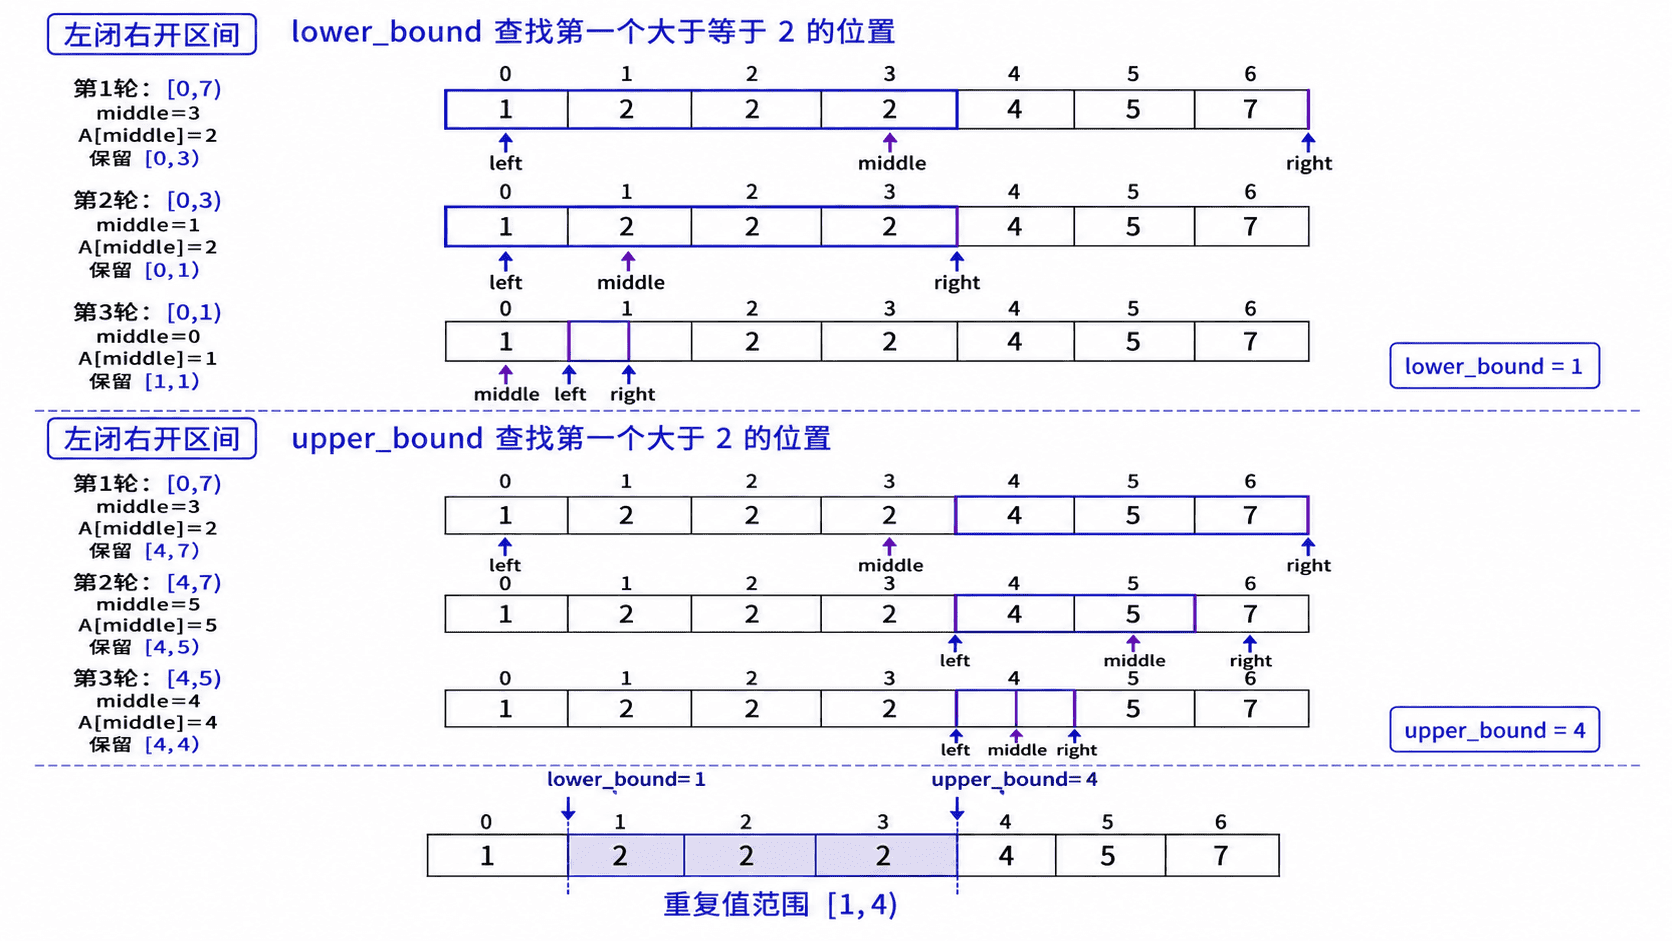
主示例
python
def lower_bound(items, target):
    left = 0
    right = len(items)

    while left < right:
        middle = left + (right - left) // 2
        if items[middle] < target:
            left = middle + 1
        else:
            right = middle

    return left

def upper_bound(items, target):
    left = 0
    right = len(items)

    while left < right:
        middle = left + (right - left) // 2
        if items[middle] <= target:
            left = middle + 1
        else:
            right = middle

    return left

def find_range(items, target):
    first = lower_bound(items, target)
    # lower_bound 也可能返回插入位置,必须验证是否真正命中。
    if first == len(items) or items[first] != target:
        return -1, -1

    last = upper_bound(items, target) - 1
    return first, last

data = [1, 2, 2, 2, 4, 5, 7]
print("2 的范围:", find_range(data, 2))
print("3 的范围:", find_range(data, 3))
print("6 的插入位置:", lower_bound(data, 6))
预期输出:
text
2 的范围: (1, 3)
3 的范围: (-1, -1)
6 的插入位置: 6
复杂度与常见边界
每轮至少排除一半候选区间,因此时间复杂度为 ,迭代实现只占用 额外空间。前提是数据按同一比较规则有序,并支持高效随机访问;在普通链表上按下标取中点并不高效。
常见错误包括混用 left <= right 与右开区间、遇到目标立即返回而无法定位首尾边界,以及把插入位置直接当作命中结果。空数组、目标小于最小值和目标大于最大值都能由该模板自然处理。
按自己的节奏,确认真正理解。