
数据结构与算法 / 系统课时
朴素字符串匹配
朴素字符串匹配
朴素字符串匹配把模式串依次对齐到文本的每个可能起点,并从头逐字符比较。本课实现首次匹配位置查询,明确空模式、模式过长和比较次数等关键边界。
学习目标
- 理解文本串与模式串的逐位置对齐过程
- 实现返回首次匹配下标的朴素算法
- 分析重复比较导致的最坏时间复杂度
对齐与比较过程
设文本长度为 n,模式长度为 m。只有 0 到 n - m 是合法起点;若 m > n,可以直接返回 -1。
固定起点 start 后,模式字符 pattern[j] 对应文本字符 text[start + j]。遇到第一个不同字符时,当前起点失败,模式串整体右移一位;若 j == m,说明模式串已完整匹配。
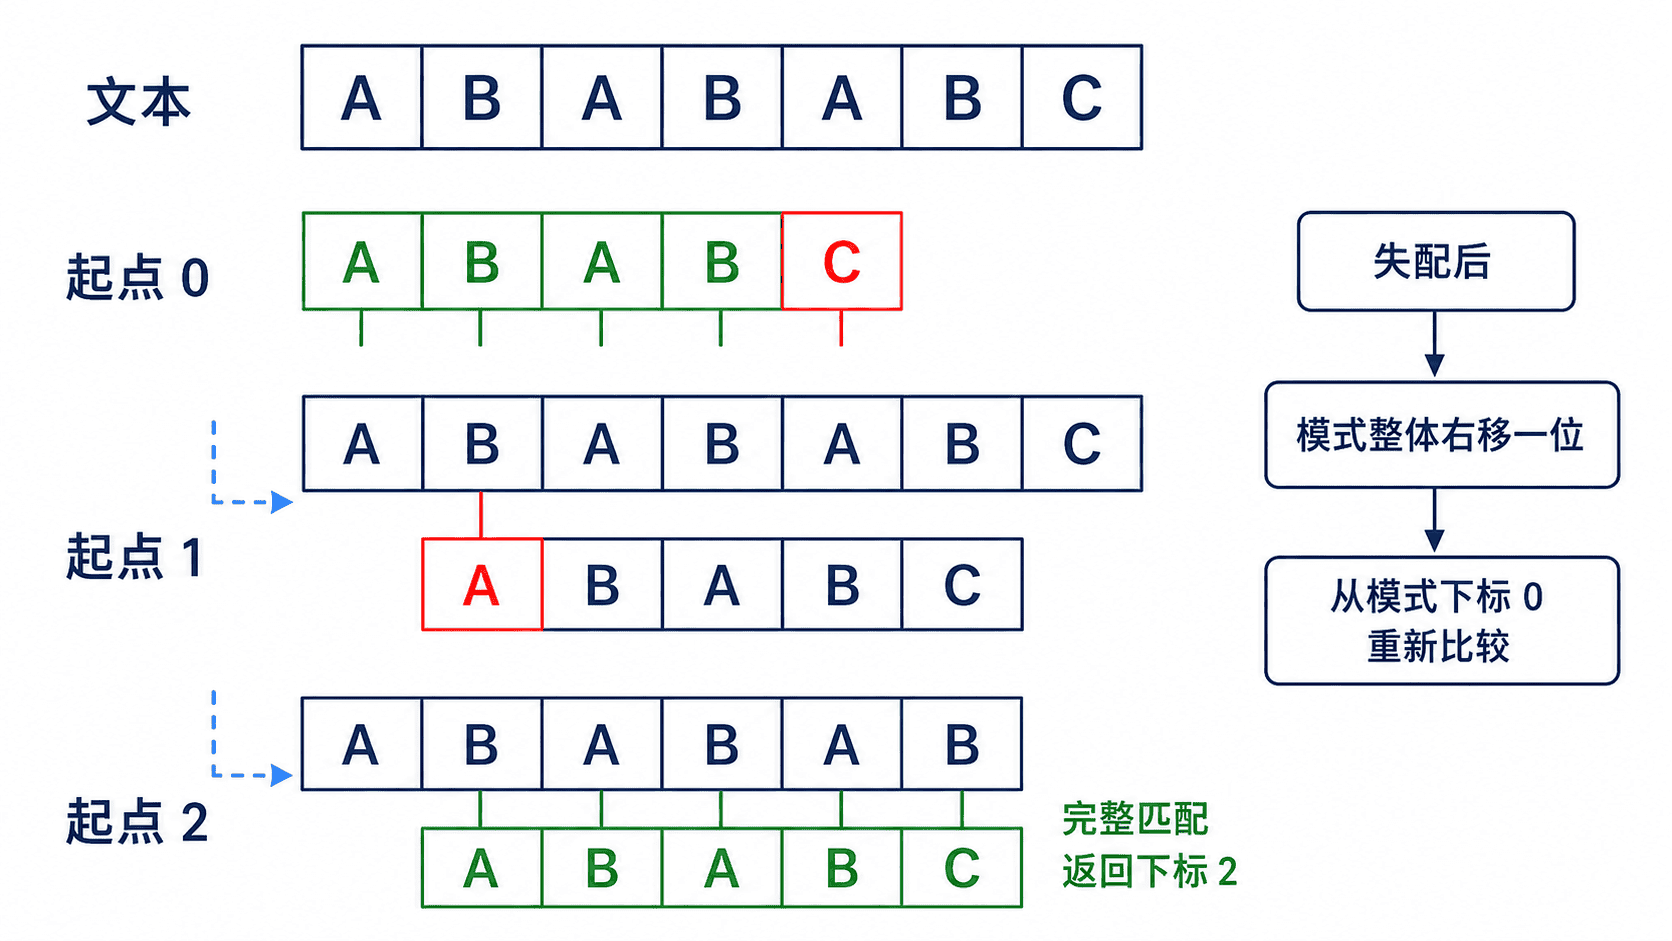
完整示例
下面的 Java 17 程序返回首次匹配位置,并统计真实字符比较次数。空模式串按常见 API 约定返回 0。
java
public class NaiveStringMatchDemo {

    private record MatchResult(int index, int comparisons) {
    }

    public static void main(String[] args) {
        String text = "ABABABC";
        String pattern = "ABABC";
        MatchResult result = findFirst(text, pattern);

        System.out.println("首次匹配位置: " + result.index());
        System.out.println("字符比较次数: " + result.comparisons());
    }

    private static MatchResult findFirst(String text, String pattern) {
        if (pattern.isEmpty()) {
            return new MatchResult(0, 0);
        }
        if (pattern.length() > text.length()) {
            return new MatchResult(-1, 0);
        }

        int comparisons = 0;

        // 外层枚举全部合法起点,包含最后一个 n - m
        for (int start = 0;
             start <= text.length() - pattern.length();
             start++) {
            int patternIndex = 0;

            while (patternIndex < pattern.length()) {
                comparisons++;
                if (text.charAt(start + patternIndex)
                    != pattern.charAt(patternIndex)) {
                    break;
                }
                patternIndex++;
            }

            if (patternIndex == pattern.length()) {
                return new MatchResult(start, comparisons);
            }
        }
        return new MatchResult(-1, comparisons);
    }
}
预期输出:
text
首次匹配位置: 2
字符比较次数: 11
起点 0 比较 5 次后失配,起点 1 比较 1 次后失配,起点 2 完整比较 5 次,因此总数是 11。统计结果必须以代码实际执行路径为准。
复杂度与适用场景
最坏情况下,每个合法起点都比较接近 m 个字符,时间复杂度为 O((n - m + 1) × m),通常简写为 O(nm);算法只维护少量下标和计数,额外空间复杂度为 O(1)。
短文本、短模式或低频查询中,朴素算法简单且足够可靠。模式内部重复结构较多、文本很长或需要大量查询时,应考虑 KMP、Boyer-Moore 或滚动哈希等方法。
常见错误
外层条件写成 < n - m 会漏掉最后一个合法起点,正确条件是 <= n - m。文本下标必须是 start + patternIndex,否则每轮都会错误地从文本开头比较。当前起点一旦失配,应立即退出内层循环,不能继续跳着比较后续字符。
练习
把程序改为返回全部匹配位置,并允许结果重叠。文本 aaaaa、模式 aa 的结果应为 [0, 1, 2, 3]。
按自己的节奏,确认真正理解。