
浏览器与 Web API / 系统课时
innerHTML 与 XSS 风险
innerHTML 与 XSS 风险
本课解决“把接口返回或用户输入直接塞进页面”的安全问题。你将看清不可信字符串从数据源进入 HTML 解析器的风险链路,并学会按内容意图选择 textContent、节点 API 或经过净化的富文本方案。
学习目标
- 识别
innerHTML、insertAdjacentHTML等 HTML 解析入口的 XSS 风险。 - 使用
textContent和createElement安全呈现普通文本与结构化内容。 - 理解富文本净化、URL 校验、CSP 等措施各自解决的边界。
XSS 风险从哪里产生
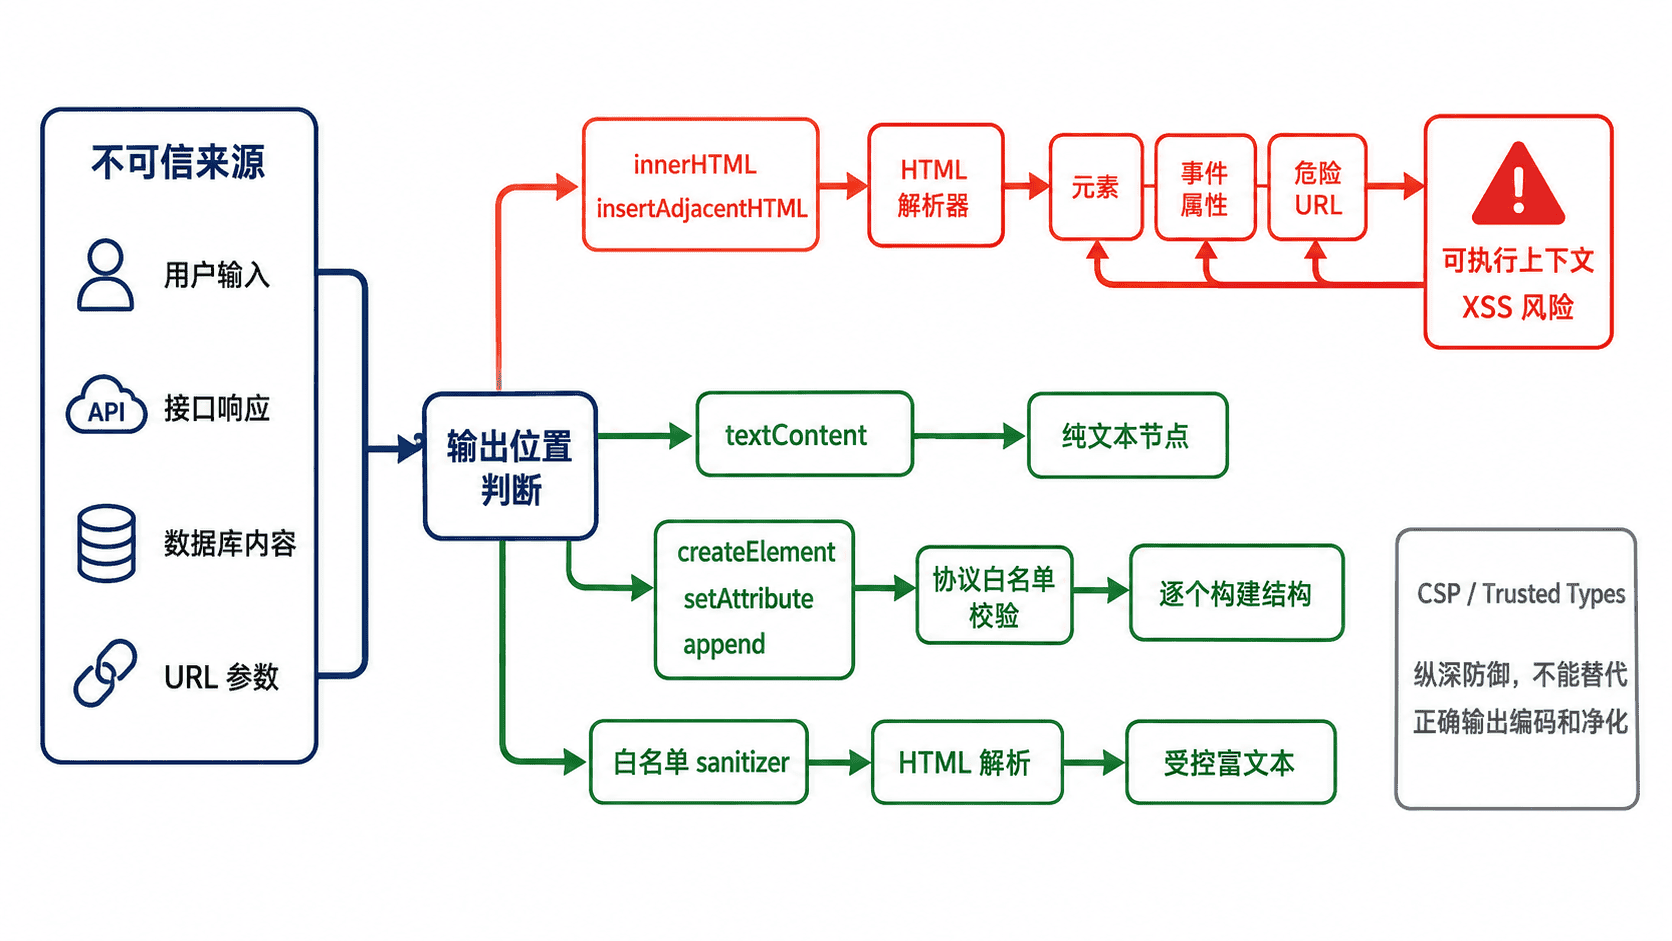
XSS 的关键不是字符串里是否出现 <script>,而是“不可信数据进入了可解释为代码或标记的上下文”。当输入被赋给 innerHTML,浏览器会按 HTML 解析并创建节点;事件处理属性、危险 URL、SVG 或其他可执行上下文都可能成为攻击入口。
数据是否来自数据库、接口或本地缓存并不能证明它可信。只要最初可被用户、第三方内容或受污染数据修改,就应按不可信输入处理。安全设计要在输出位置选择正确 API,而不是依赖简单删除几个标签或关键字。
按内容意图选择输出 API
普通文本应使用 textContent,它会把尖括号、引号和事件属性都当作字符显示。需要创建卡片、按钮或列表时,使用 createElement、属性 API 和 append 构建节点。只有业务明确允许富文本时,才应把内容交给成熟、持续维护且采用白名单策略的净化器,再写入 HTML 解析入口。
| 内容意图 | 推荐方式 | 关键边界 |
|---|---|---|
| 显示名称、评论、提示文字 | textContent |
不解析任何 HTML |
| 创建固定结构 | createElement 与 append |
属性值仍要按上下文校验 |
| 插入可信的静态模板 | 受控模板或节点克隆 | 不混入运行时不可信字符串 |
| 展示用户富文本 | 先净化,再写入 HTML | 净化规则必须覆盖标签、属性和 URL |
完整示例:比较 HTML 解析与安全文本插入
下面的页面使用同一段输入生成三种结果。第一栏故意展示 innerHTML 会解析标签的行为;第二栏使用 textContent 显示原始字符;第三栏通过节点 API 创建固定结构,只把输入放进文本节点。示例默认值是无害标记,不会执行攻击代码。
<!doctype html>
<html lang="zh-CN">
<head>
<meta charset="utf-8">
<meta name="viewport" content="width=device-width, initial-scale=1">
<title>innerHTML 与安全文本插入</title>
<style>
textarea { width: 100%; max-width: 720px; }
.grid { display: grid; grid-template-columns: repeat(3, 1fr); gap: 12px; margin-top: 12px; }
.panel { min-height: 90px; padding: 12px; border: 1px solid #cbd5e1; }
</style>
</head>
<body>
<label for="source">待渲染内容</label>
<textarea id="source" rows="3"><strong>课程提示</strong></textarea>
<button id="render" type="button">渲染对比</button>
<div class="grid">
<section>
<h2>innerHTML</h2>
<div id="html-output" class="panel"></div>
</section>
<section>
<h2>textContent</h2>
<div id="text-output" class="panel"></div>
</section>
<section>
<h2>节点 API</h2>
<div id="node-output" class="panel"></div>
</section>
</div>
<script>
const source = document.querySelector("#source");
const htmlOutput = document.querySelector("#html-output");
const textOutput = document.querySelector("#text-output");
const nodeOutput = document.querySelector("#node-output");
document.querySelector("#render").addEventListener("click", () => {
const value = source.value;
// 风险示范:不可信字符串会被当作 HTML 解析。
htmlOutput.innerHTML = value;
// 安全呈现普通文本:输入只成为文本节点。
textOutput.textContent = value;
// 固定结构由程序创建,动态内容仍放入 textContent。
const card = document.createElement("article");
const title = document.createElement("strong");
title.textContent = "安全卡片:";
const content = document.createElement("span");
content.textContent = value;
card.append(title, content);
nodeOutput.replaceChildren(card);
});
</script>
</body>
</html>预期结果
输入 <strong>课程提示</strong> 并点击“渲染对比”:
innerHTML 区域把“课程提示”显示为粗体;
textContent 区域显示完整的 <strong>...</strong> 字符;
节点 API 区域保留固定卡片结构,并把输入作为普通文本显示。
富文本、属性与 URL 的边界
setAttribute 并不自动让所有值安全。把不可信值写入 href、src、style 或事件属性时,仍可能进入危险上下文。链接应解析为 URL,并只允许业务需要的协议,例如 https:;不要接受 javascript: 等可执行协议,也不要让用户控制属性名。
若必须支持富文本,净化规则应采用允许列表,只保留业务需要的标签、属性和 URL 协议。不要用正则表达式“删除 <script>”来代替 HTML 解析和净化,因为浏览器语法、编码和嵌套方式会产生大量绕过路径。
纵深防御与验证方法
内容安全策略 CSP 可限制脚本来源,Trusted Types 可在支持的环境中约束危险 DOM 接口;它们属于纵深防御,不能替代正确的输出 API。服务端仍要按输出上下文编码,前端也要在最终 DOM 写入点判断数据是否可信。
验证时可先输入普通标签,确认安全区域显示原始字符;再检查代码,确保用户数据没有流入 innerHTML、outerHTML、insertAdjacentHTML 或字符串形式的脚本执行入口。需要富文本的路径应单独测试允许标签、拒绝属性和危险 URL。