
图形渲染与 Shader / 系统课时
实例矩阵怎样传给顶点阶段
实例矩阵怎样传给顶点阶段
实例化绘制能够一次处理许多物体,但 GPU 必须知道当前顶点属于哪个实例,并取得该实例对应的变换矩阵。本节沿着 CPU 实例缓冲、顶点属性槽位、实例推进规则和顶点着色器一路追踪,解释一份 mat4 最终怎样参与顶点位置计算。
学习目标
- 理解实例矩阵从缓冲区进入顶点着色器的数据路径
- 正确配置
mat4对应的四个顶点属性槽位 - 区分实例属性推进与
gl_InstanceID的作用
矩阵进入顶点阶段的完整路径
CPU 先把多个模型矩阵连续写入实例 VBO,再通过 VAO 描述这些字节应该如何解释。实例化绘制启动后,顶点获取阶段同时读取普通顶点属性和当前实例属性,最终让顶点着色器拿到当前顶点的位置以及当前实例的模型矩阵。
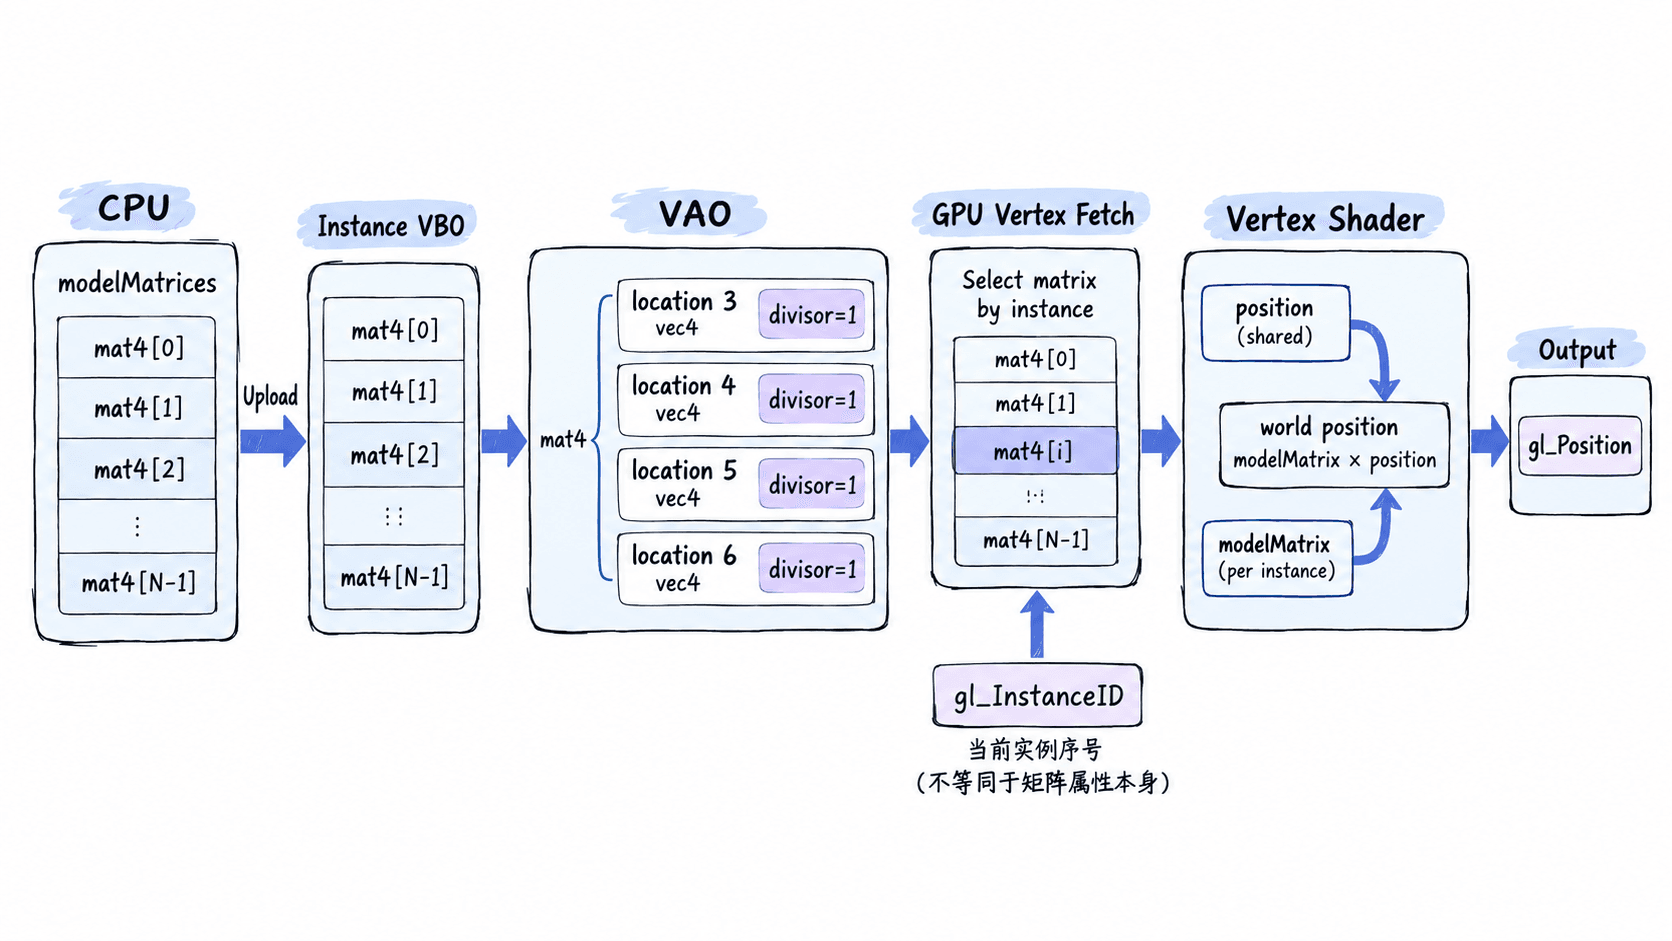
这条路径中最容易混淆的一点是:实例矩阵并不是每次 Draw 前重新设置一个 uniform,而是像普通顶点属性一样保存在缓冲区中,只是它的读取频率从“每顶点一次”改成了“每实例一次”。
为什么一个 mat4 要占四个属性位置
OpenGL 顶点属性接口一次描述的属性通常是一个标量或最多四分量向量。一个 mat4 包含四个 vec4 列,因此不能只用一个 attribute location 完整承载,而要占用连续四个位置。
下面是片段示例,依赖已经绑定的 VAO 和实例矩阵 VBO。假设普通顶点属性已经占用了 location 0 到 2,因此矩阵从 location 3 开始。
const GLsizei stride = sizeof(glm::mat4);

for (GLuint column = 0; column < 4; ++column) {
    const GLuint location = 3 + column;

    glEnableVertexAttribArray(location);
    glVertexAttribPointer(
        location,
        4,
        GL_FLOAT,
        GL_FALSE,
        stride,
        reinterpret_cast<void*>(sizeof(glm::vec4) * column)
    );

    glVertexAttribDivisor(location, 1);
}
stride 是整份矩阵的大小,所以四个属性读取完当前矩阵后,下一个实例会跳到下一份 mat4。偏移量分别落在矩阵的第 0、1、2、3 个 vec4 上。四个槽位都必须设置相同的 divisor,否则矩阵各列可能以不同频率推进,最终得到错误变换。
顶点着色器怎样取得当前实例矩阵
着色器端可以直接声明 mat4 输入。只要它的起始 location 与 VAO 配置一致,编译器会让它连续占用四个属性位置。下面是片段示例,依赖应用已经提供有效的 view 与 projection uniform。
#version 330 core

layout(location = 0) in vec3 aPosition;
layout(location = 3) in mat4 instanceModel;

uniform mat4 view;
uniform mat4 projection;

void main() {
    vec4 worldPosition = instanceModel * vec4(aPosition, 1.0);
    gl_Position = projection * view * worldPosition;
}
这里没有显式索引 modelMatrices[instanceIndex]。实例索引的推进已经由固定功能的顶点获取阶段根据 divisor 完成:同一实例的所有顶点看到同一份 instanceModel,进入下一个实例时才自动切换到下一份矩阵。
预期结果是在一次实例化绘制中,同一份网格按照不同实例矩阵出现在多个位置。若所有实例重叠在同一点,应优先检查矩阵数据是否真的不同、四个 attribute location 是否连续,以及四个位置是否都调用了 glVertexAttribDivisor(location, 1)。
gl_InstanceID 与实例属性不是一回事
顶点着色器还可以读取内建变量 gl_InstanceID。它表示当前正在处理第几个实例,通常从 0 开始递增。这个值适合用来索引着色器中的数组、生成实例相关变化,或者调试实例编号,但它本身并不会自动提供模型矩阵。
例如矩阵通过实例 VBO 传入时,硬件根据 attribute divisor 自动选择矩阵,而 gl_InstanceID 只是额外可用的实例序号。另一种设计是把变换存进 SSBO、纹理缓冲或其他可索引资源,再主动使用实例编号读取;那属于不同的数据传递方案。
实例矩阵能够正确到达顶点阶段,依赖三个条件同时成立:CPU 缓冲中的矩阵连续且布局正确,VAO 用四个连续属性槽描述 mat4,并且这些属性的 divisor 都设置为 1。把这三层逐层核对,比只盯着着色器代码更容易定位实例变换异常。