
图形渲染与 Shader / 系统课时
完成一个大规模场景优化方案
完成一个大规模场景优化方案
面对成千上万个可见对象,最有效的方案通常不是单押某一种技术,而是先量化场景,再组合资源合并、实例化、剔除、间接绘制和持续采样。本课给出一条可落地的优化路径,并用简单脚本把“优化前后该看什么”变成可验证的预算。
学习目标
- 能按场景数据判断哪些对象适合实例化、间接绘制或保持独立绘制
- 能把材质治理、剔除和 draw call 优化组合成完整方案
- 能设计基线、预算和复测流程,避免只凭 FPS 判断效果
先建立可复现的性能基线
开始优化前,固定相机路径、分辨率、画质和测试设备,记录 CPU frame time、GPU frame time、draw call、可见实例数、材质数量和显存占用。没有稳定基线,后续每一次“变快”都可能只是镜头、负载或后台任务变化造成的。
大规模场景通常先按对象特征分组:重复网格且材质一致的对象是实例化候选;数量极多、可见性频繁变化且 CPU 提交压力明显的对象是 GPU culling 与间接绘制候选;少量高价值对象则没必要为了合批牺牲独立材质或动画能力。
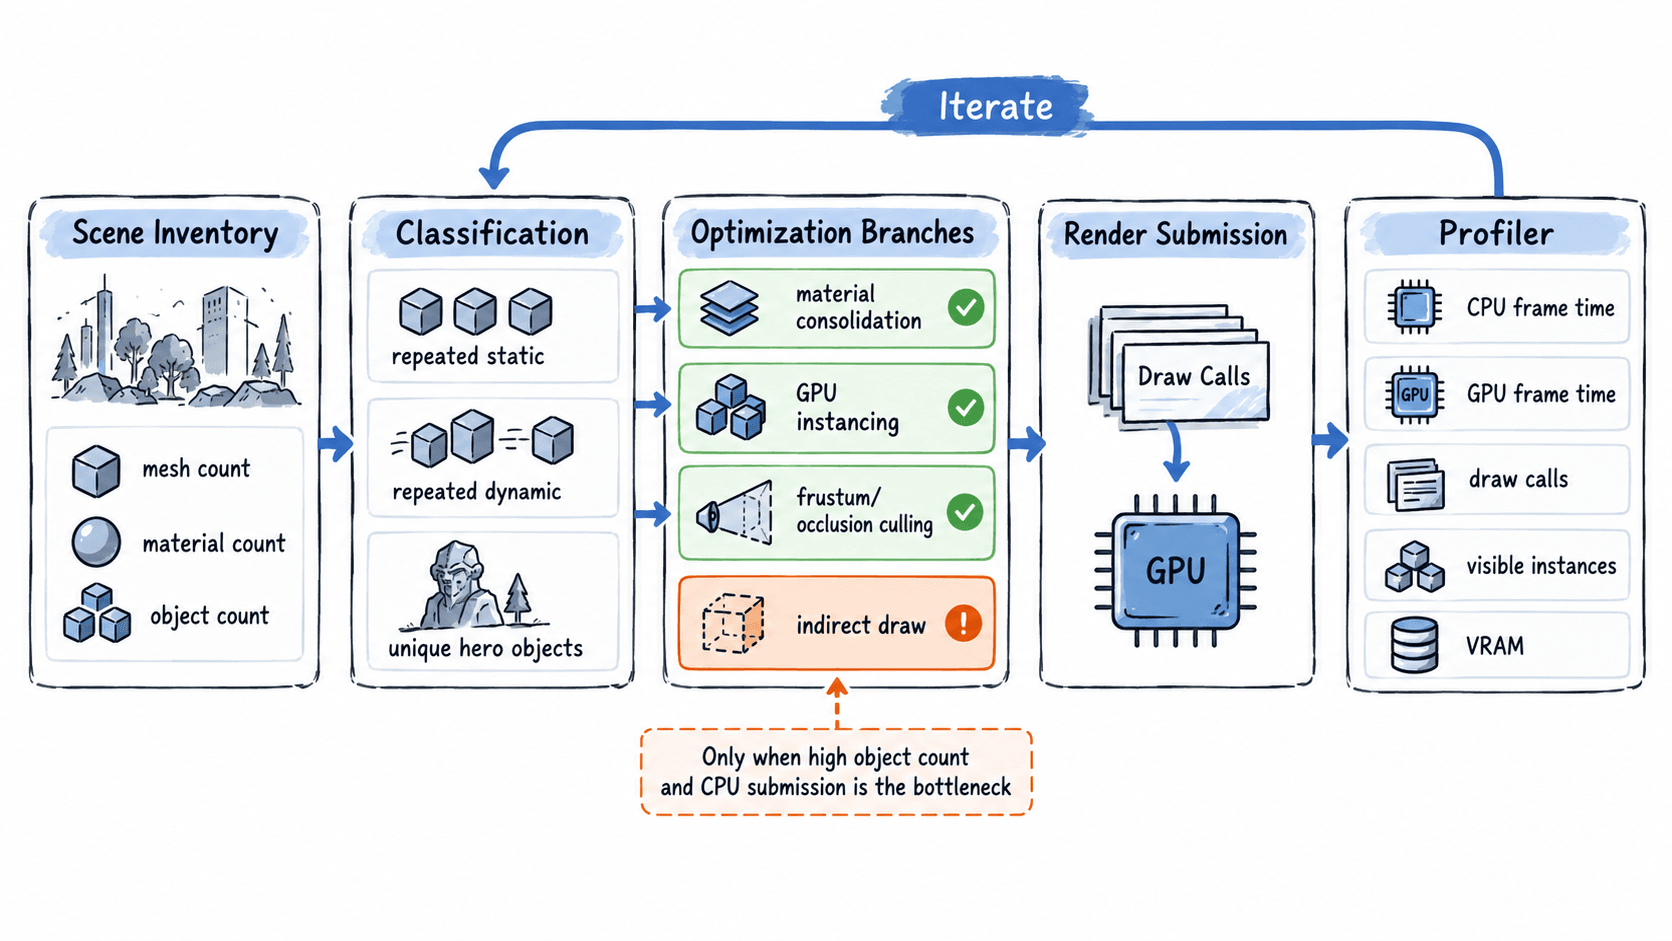
这一步的产物不是一张“技术清单”,而是一张对象分类表。每一类都要能回答:数量是多少、为什么当前绘制方式昂贵、准备改成什么、成功后哪个指标应该下降。
先解决材质和批次碎片
如果 5000 棵树使用 30 份仅颜色不同的材质,即使网格相同,也很可能被拆成多个批次。应先统一 shader 与基础材质,把颜色、风摆幅度、随机参数等真正属于实例差异的数据放到实例缓冲中。
材质治理完成后再看实例化收益。如果批次数仍高,继续检查 shader variant、阴影、光照贴图、render queue 等状态差异。不要在批次键尚未稳定时直接上间接绘制,否则只是把碎片化批次搬进更复杂的提交路径。
让剔除发生在绘制之前
视锥剔除应尽量早地排除屏幕外对象;超大场景还可以结合空间分区、遮挡剔除或距离阈值。对实例化系统而言,剔除后的核心结果不是“对象消失了”,而是一组可见实例 ID,它们将决定本帧真正上传和提交的数据量。
当可见实例经常达到数万、CPU 仍需要逐批构建参数并发起大量调用时,再考虑 GPU culling 加 indirect draw。它的目标是减少 CPU 参与,而不是自动让 GPU 更快;如果 GPU 已经被像素、阴影或复杂 shader 压满,间接绘制可能几乎不改善帧时间。
用预算脚本检查方案是否值得推进
下面的 Python 示例根据场景分组估算实例化后的批次数,并标出“对象很多且批次很少”的间接绘制候选。它不替代引擎 Profiler,但适合在资源盘点阶段快速发现最值得处理的组。
groups = [
    {"name": "trees", "objects": 6000, "compatible_material_groups": 3},
    {"name": "rocks", "objects": 1800, "compatible_material_groups": 2},
    {"name": "hero_props", "objects": 24, "compatible_material_groups": 24},
]

total_objects = sum(g["objects"] for g in groups)
estimated_draws = sum(g["compatible_material_groups"] for g in groups)

print(f"objects={total_objects}")
print(f"estimated_instanced_draws={estimated_draws}")

for g in groups:
    indirect_candidate = (
        g["objects"] >= 2000 and
        g["compatible_material_groups"] <= 4
    )
    print(f"{g['name']}: indirect_candidate={indirect_candidate}")
预期输出:
objects=7824
estimated_instanced_draws=29
trees: indirect_candidate=True
rocks: indirect_candidate=False
hero_props: indirect_candidate=False
这里的阈值只是项目预算示例,不是通用标准。真实决策应由目标设备上的 CPU 提交耗时、GPU 利用率和可见对象波动决定。脚本的意义是把“很多对象”变成可度量条件,方便团队先排序,再进入引擎验证。
把最终方案写成可验收的改动
一个完整方案可以按下面顺序实施:先统一重复资源的材质和 shader 变体,再建立实例数据布局;随后接入视锥与距离剔除,确认可见实例数正确;然后对高数量批次启用实例化;只有在 CPU 提交仍是瓶颈时,再为目标组引入 GPU culling 与间接绘制。
验收时不要只比较平均 FPS。至少同时比较 CPU frame time、GPU frame time、draw call、P95 或最差帧时间、显存和实例缓冲上传量。若 draw call 大幅下降但 GPU frame time 上升,要继续检查 shader 复杂度、过度绘制、阴影和不可见实例是否仍被执行。
最终交付的不是“开启 GPU Instancing”这一项设置,而是一套可解释的决策链:场景数据说明问题,资源与实例结构保证合批,剔除减少无效工作,必要时再用间接绘制降低 CPU 提交成本,最后用稳定基线证明方案确实改善了目标设备上的帧时间。