
图形渲染与 Shader / 系统课时
实例缓冲区该放哪些数据
实例缓冲区该放哪些数据
实例缓冲区不是“实例有什么属性就全塞进去”,而是要围绕着色器真正读取的数据和 CPU 更新频率设计。本课会把变换、颜色、材质索引等信息拆开分析,并用一个可验证的结构体示例理解字节布局、对齐以及更新成本之间的关系。
学习目标
- 判断哪些属性适合进入实例缓冲区,哪些数据应放到其他资源中
- 理解实例数据大小、内存带宽和更新频率之间的关系
- 根据冷热数据设计紧凑且容易维护的实例布局
先从着色器真正需要的数据出发
每个实例通常至少需要回答两个问题:它在哪里,以及它和其他实例有什么差异。前者一般由变换数据表示,后者可能是颜色、材质索引、动画参数、LOD 状态或对象标识。
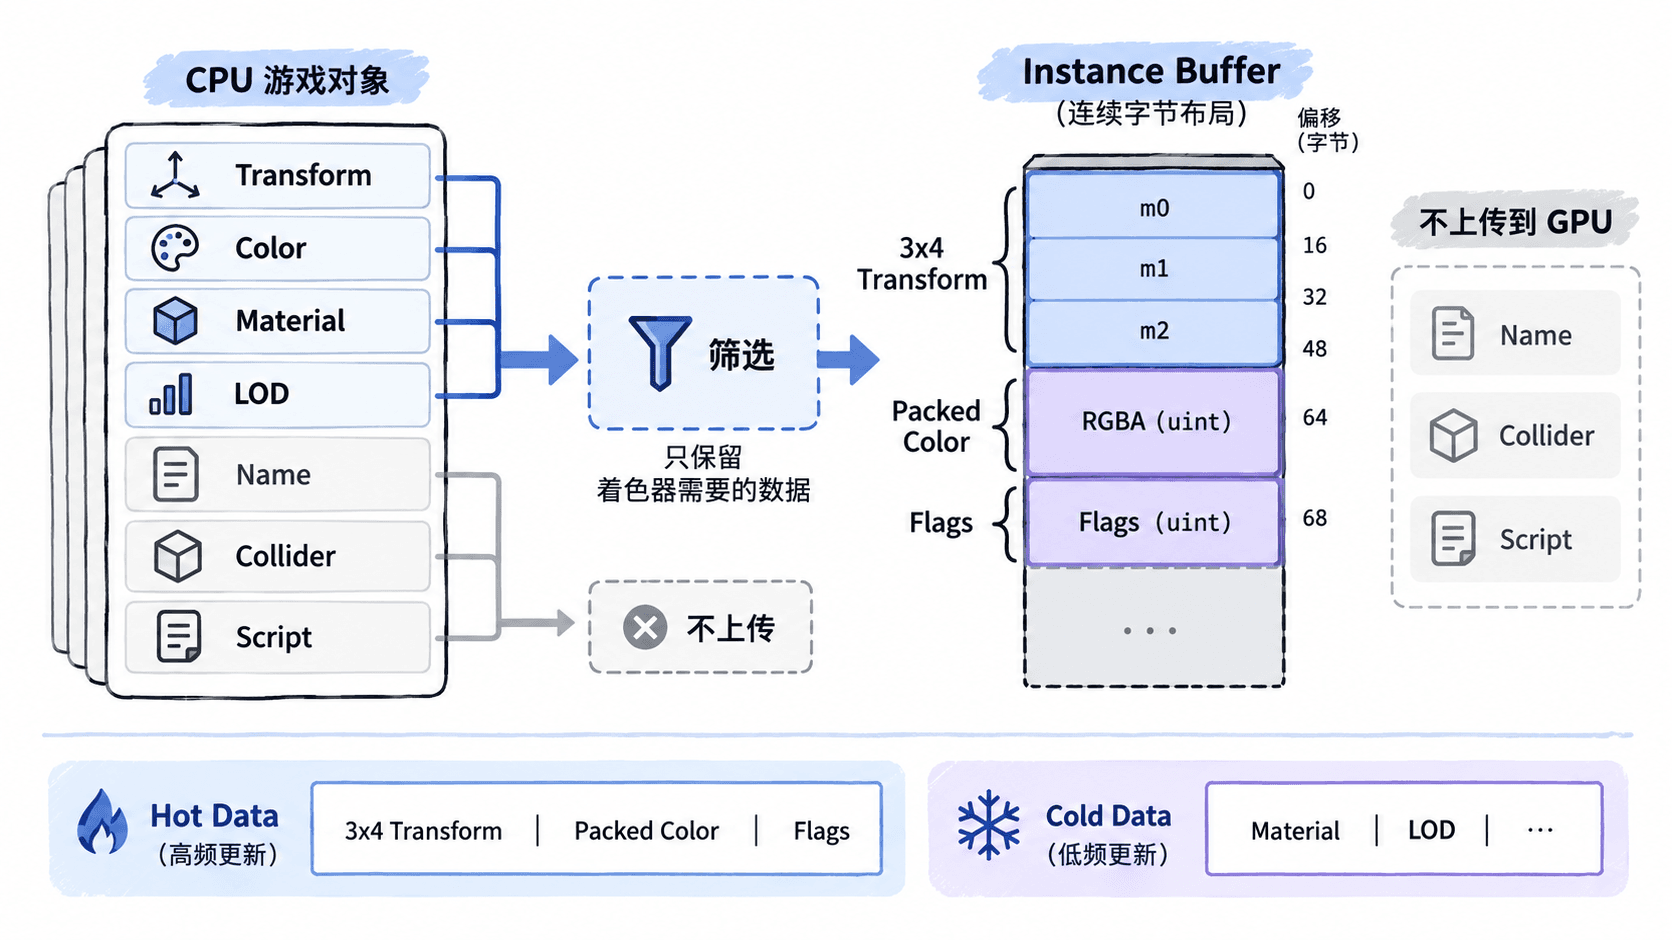
不要把 CPU 侧完整游戏对象直接复制到 GPU。名称、指针、碰撞状态、脚本对象和只供逻辑系统使用的字段,即使属于这个实例,也不应该占用实例缓冲区带宽。
一个常见的最小布局可以包含 3×4 仿射变换矩阵、压缩颜色和少量标志位。3×4 矩阵需要 12 个 float,相比完整 4×4 矩阵少传 4 个 float,前提是着色器能够自行补出仿射矩阵最后一行。
用字节数检查布局是否真的紧凑
下面的标准 C++ 程序模拟一个实例记录。它不依赖图形 API,只用于检查字段偏移、结构体对齐和单实例占用空间,因此可以独立编译验证。
#include <cstddef>
#include <cstdint>
#include <iostream>

struct alignas(16) InstanceData {
    // 3x4 仿射矩阵:12 个 float,共 48 字节
    float transform[12];
    std::uint32_t color;
    std::uint32_t flags;
};

int main() {
    std::cout << "align=" << alignof(InstanceData) << '\n';
    std::cout << "size=" << sizeof(InstanceData) << '\n';
    std::cout << "transform=" << offsetof(InstanceData, transform) << '\n';
    std::cout << "color=" << offsetof(InstanceData, color) << '\n';
    std::cout << "flags=" << offsetof(InstanceData, flags) << '\n';
}
预期输出:
align=16
size=64
transform=0
color=48
flags=52
这里有效字段只有 56 字节,但 alignas(16) 使结构体大小补齐到 64 字节。对十万个实例而言,8 字节尾部填充会额外占用约 0.8 MB。是否值得接受,要结合目标图形 API 的布局要求、访问方式和维护成本决定,不能只追求最小 sizeof。
热数据与冷数据不要强行绑在一起
如果位置和旋转每帧变化,而颜色、材质编号几分钟都不变,把它们放在一个 64 字节记录中意味着更新 Transform 时常常还要重复搬运静态字段。十万个实例的规模下,这种方便的 AoS 布局可能产生明显的额外内存流量。
可以按更新频率拆分:频繁变化的 Transform 放入动态实例缓冲区,颜色、材质索引等低频数据放入静态缓冲区。这样做会增加资源绑定和索引管理复杂度,却能显著减少每帧写入的数据量。
相反,如果实例数量只有几千,所有字段都会一起更新,而且一次 Draw 就希望顺序读取全部属性,单个紧凑结构体通常更简单。布局设计不是越拆越好,而是让更新粒度接近业务真正变化的粒度。
选择字段时做三次检查
加入一个实例字段前,可以依次检查:Shader 是否真的会读它;它是否必须每个实例独立保存;它是否和当前缓冲区中的其他字段以相近频率更新。如果三个答案中有一个是否定的,就值得重新考虑存放位置。
例如材质只有十几个固定类型时,实例通常只需保存一个小型材质索引,而不是重复保存整套材质参数。大量实例共享的数据更适合由材质资源、常量缓冲区或其他共享资源提供。
最终目标不是得到理论上最小的结构体,而是在 Shader 读取成本、CPU 写入量、GPU 上传带宽和工程可维护性 之间取得平衡。真正影响十万级实例性能的,往往不是某一个字段多了 4 字节,而是那些本不需要每帧更新的数据也被反复搬运。