
图形渲染与 Shader / 系统课时
批次减少了为什么帧率没提升
批次减少了为什么帧率没提升
把 Draw Call 从几千降到几百,只能说明 CPU 提交开销下降了,并不代表整帧最慢的环节也变快。本课用一套可执行的诊断顺序,把问题拆成 CPU 提交、顶点处理、像素填充、显存带宽和剔除几类瓶颈,并学会用数据确认真正限制帧率的阶段。
学习目标
- 判断批次下降后是否仍受 CPU 提交限制
- 识别顶点、填充率、带宽和剔除造成的 GPU 瓶颈
- 用可重复的 A/B 测试验证优化是否击中了主瓶颈
先确认 Draw Call 是否真是主瓶颈
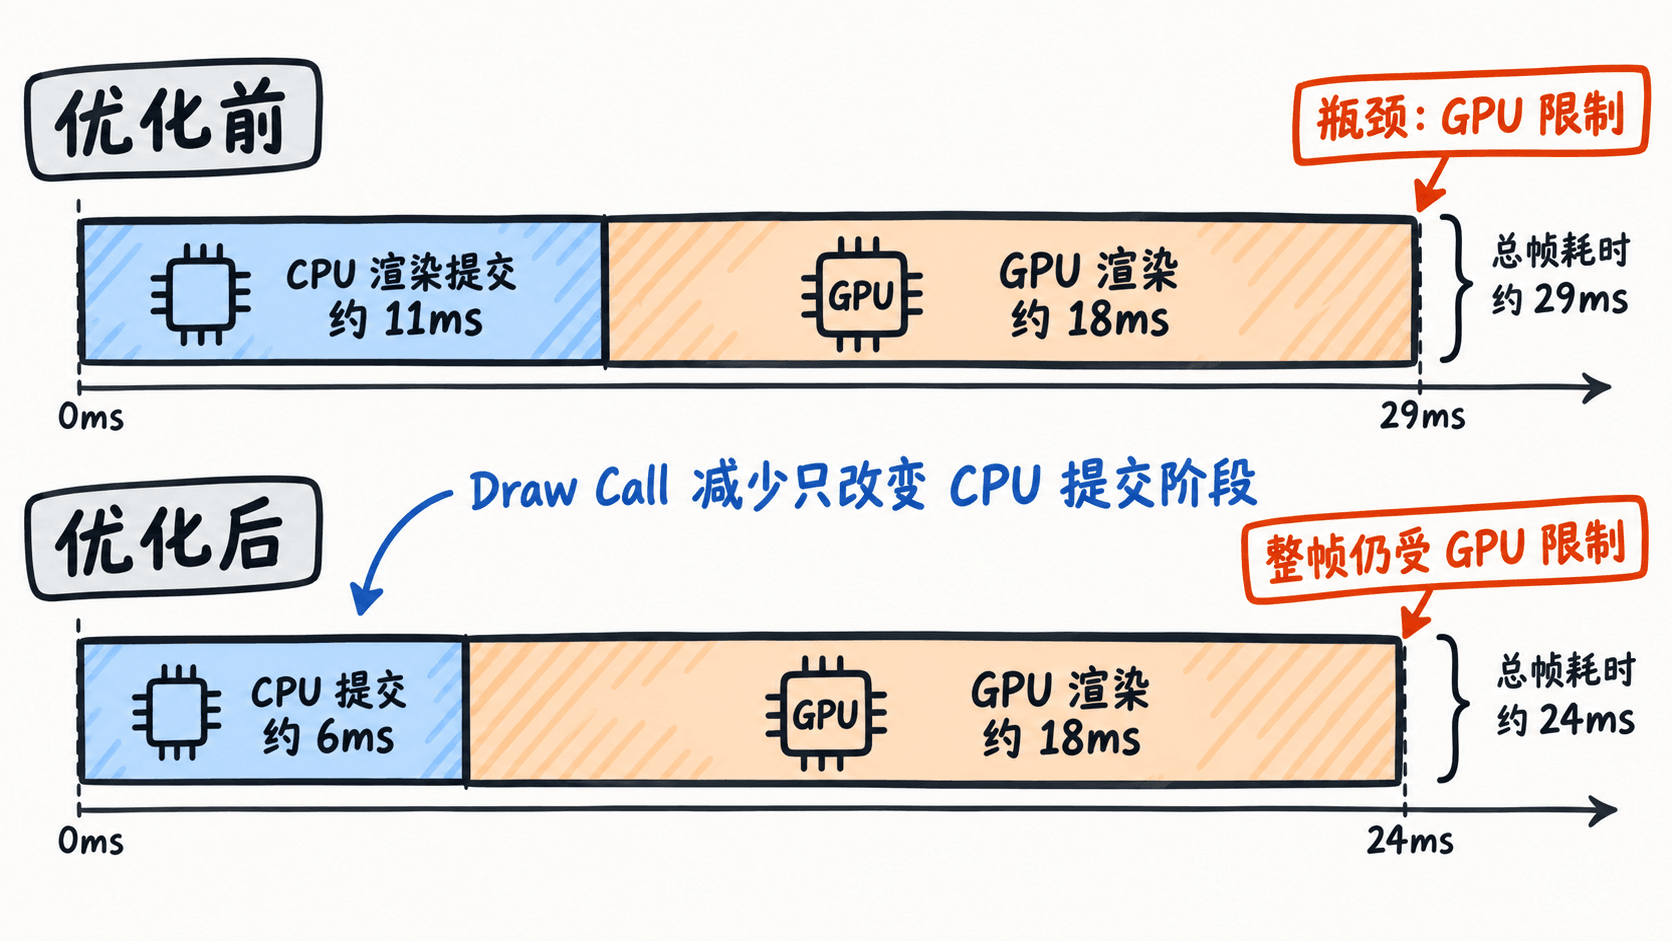
GPU Instancing 主要减少重复网格的提交次数。如果原本 CPU 在渲染线程上花了大量时间组织和提交命令,批次下降通常会让 CPU Frame Time 明显降低;但如果 GPU 已经更慢,CPU 节省出来的时间不会直接转化为更高帧率。
最可靠的判断不是看 FPS,而是同时比较 CPU 与 GPU 每帧耗时。可以先记录优化前后数据,并换算理论上限:
def fps_from_ms(frame_ms: float) -> float:
    return 1000.0 / frame_ms

samples = {
    "before": {"cpu_ms": 11.0, "gpu_ms": 18.0},
    "after": {"cpu_ms": 6.0, "gpu_ms": 18.0},
}

for name, value in samples.items():
    frame_ms = max(value["cpu_ms"], value["gpu_ms"])
    print(name, round(fps_from_ms(frame_ms), 1))
预期输出
before 55.6
after 55.6
这里 CPU 已从 11 ms 降到 6 ms,但 GPU 仍需 18 ms,所以整帧仍由 GPU 决定。真实引擎里还会有同步、排队和并行执行,不能只用 max 精确建模,但它足以说明“优化了非瓶颈阶段,FPS 可以完全不变”。
GPU 端常见的四类非提交瓶颈
顶点处理过重时,即使实例共用一次提交,每个实例的顶点仍要执行顶点着色。大量高模、蒙皮、复杂顶点变换会让 Vertex Shader 成为主要成本。一个简单验证法是临时切换到低模或减少可见实例,如果 GPU 时间明显下降,说明瓶颈不在 Draw Call。
填充率受屏幕像素数量和 Overdraw 影响。大量透明粒子、草、树叶或全屏特效会让同一像素被重复写入多次。此时减少实例批次几乎不改变像素着色次数,降低分辨率反而更容易看到 GPU 时间下降。
带宽瓶颈常见于超大纹理、频繁访问实例缓冲、过宽的 GBuffer 或高采样材质。它的特点是算术复杂度并不高,但 GPU 需要持续搬运大量数据。减少纹理尺寸、降低渲染目标格式或压缩每实例数据后,帧时间才会改善。
剔除不足则会让“看不见但仍被提交或绘制”的实例消耗 GPU。Instancing 把很多对象并到一个批次后,如果剔除粒度变粗,可能出现批次减少但实际处理的实例更多,甚至抵消 CPU 侧收益。
用 A/B 测试定位是哪一段慢
排查时一次只改一个变量,否则无法知道性能变化来自哪里。建议按“分辨率、模型复杂度、实例数量、材质复杂度”的顺序做快速对照。
| 测试动作 | 如果 GPU 时间明显下降 | 更可能的瓶颈 |
|---|---|---|
| 渲染分辨率降到 50% | 是 | 像素填充、后处理 |
| 换成低模网格 | 是 | 顶点处理 |
| 关闭透明和复杂材质 | 是 | Overdraw、像素着色 |
| 大幅减少可见实例 | 是 | 顶点、带宽或剔除 |
| 仅继续减少 Draw Call | 几乎不变 | 非提交瓶颈 |
测试时应观察毫秒而不是只看 FPS。60 FPS 到 66 FPS 只节省约 1.5 ms,而 30 FPS 到 36 FPS 节省约 5.6 ms;用 Frame Time 才能直接比较优化收益。
警惕实例化带来的新成本
实例化并不是“批次越少越快”。如果每帧把大量实例矩阵重新上传到 GPU,CPU 到 GPU 的传输可能变成新瓶颈;如果实例数据布局过大,GPU 读取带宽也会增加。动态实例还可能造成缓冲区更新和同步等待。
一个有效的优化闭环是:先确认哪个阶段最慢,再做单变量实验,最后比较毫秒级变化。只要 GPU 端的顶点、像素、带宽或剔除成本仍占主导,Draw Call 降低就可能只让 CPU 更轻松,而不会立刻提高最终帧率。