
图形渲染与 Shader / 系统课时
实例化后出现闪烁怎么查
实例化后出现闪烁怎么查
实例化后偶发闪烁通常不是“显卡随机出错”,而是实例索引、实例缓冲更新、对象生命周期或 CPU/GPU 同步出现了错位。本课给出一条从现象到根因的排查路径,并用最小示例演示为什么错误复用实例数据会让画面在相邻帧之间跳变。
学习目标
- 根据闪烁范围判断是单实例数据错位还是整批同步问题
- 排查实例索引、缓冲更新和生命周期复用错误
- 用双缓冲或显式同步避免 CPU 覆盖 GPU 尚未消费的数据
先按闪烁范围缩小问题
如果只有少数物体随机跳位置、材质或颜色,优先检查“实例索引是否与实例数据一一对应”。如果整批实例偶尔同时错乱,更像是缓冲区被提前覆盖、写入范围错误或资源生命周期失效。
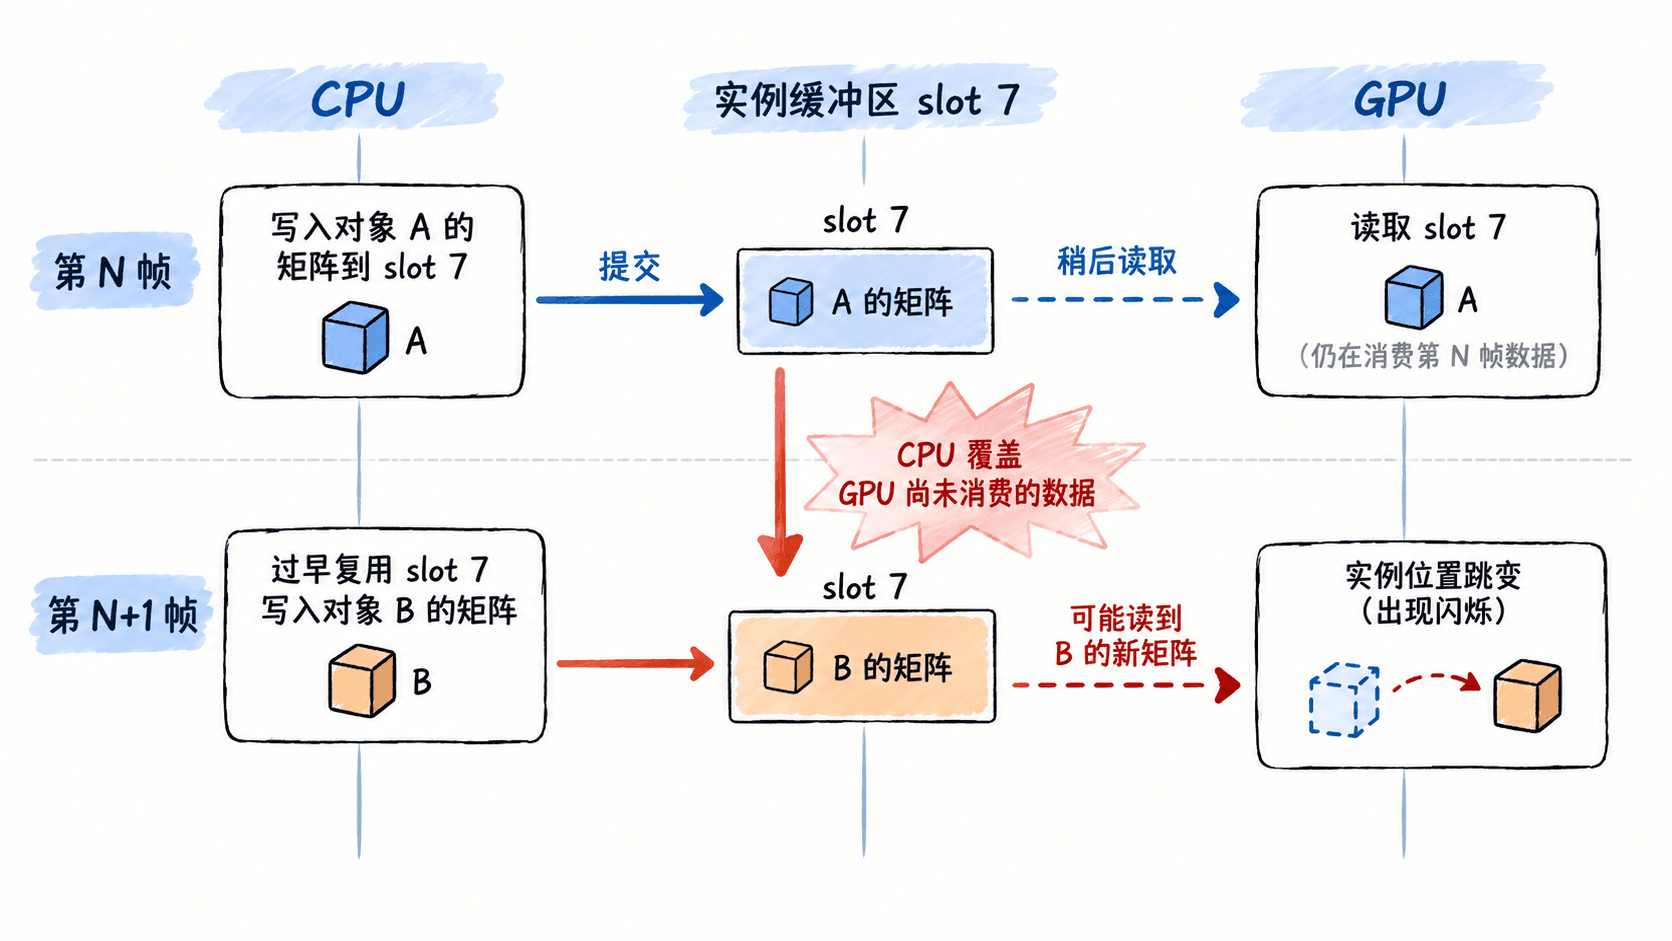
如果问题只在对象频繁创建和销毁时出现,要重点检查实例槽位复用。常见错误是 CPU 已把槽位分配给新对象,但 GPU 仍在读取上一帧属于旧对象的数据,于是同一个索引在相邻帧代表了不同实体。
检查索引和写入边界
实例数据通常由连续数组或结构化缓冲保存。最先要确认三件事:绘制时的 instanceID 是否越界、CPU 写入顺序是否与 GPU 读取顺序一致、上传字节数是否覆盖了完整实例结构。
下面用一个最小 Python 示例模拟“复用槽位后,旧索引读到了新对象数据”的问题:
slots = [None, None]

# 第 N 帧:A 占用 slot 0,B 占用 slot 1
slots[0] = {"name": "A", "x": 10}
slots[1] = {"name": "B", "x": 20}
submitted_indices = [0, 1]

# 错误:GPU 尚未消费第 N 帧,CPU 就提前复用 slot 0
slots[0] = {"name": "C", "x": 100}

for index in submitted_indices:
    item = slots[index]
    print(index, item["name"], item["x"])
预期输出
0 C 100
1 B 20
第 N 帧本来应该绘制 A 和 B,但 slot 0 已被 C 覆盖,因此 GPU 若此时才读取缓冲,就会把 C 的数据当成 A 使用。在真实渲染中,这会表现为位置、缩放、颜色或动画状态突然跳变。
再查缓冲更新和同步
如果实例数据每帧更新,不要默认“CPU 写完就等于 GPU 已经读完”。现代图形 API 通常允许 CPU 和 GPU 并行执行,GPU 可能落后一个或多个帧。直接覆盖正在使用的缓冲区域,会产生读写竞争。
常见修复方式是环形缓冲或多缓冲:每个飞行帧使用独立实例区域,只有确认某一帧完成后才复用对应区域。若引擎或 API 提供 Fence、Frame Resource、Command Buffer 生命周期等机制,应依赖这些机制判断资源是否可安全重写,而不是靠延时或猜测。
检查生命周期和删除策略
动态场景里还要核对对象删除后的槽位管理。若采用“删除后把最后一个实例搬到空洞位置”的紧凑策略,就必须同步更新对象到实例索引的映射;只移动数据、不更新索引表,会让后续修改写到错误对象。
更稳妥的调试方法是临时关闭槽位复用:对象销毁后先保留空洞,只在整帧结束或确认 GPU 不再引用旧数据时回收。如果这样做后闪烁消失,几乎可以确定问题与生命周期或资源复用有关。
用最小场景完成验证
最后把场景缩到几十个实例,关闭动画、LOD、透明和异步加载,只保留位置或颜色更新。然后固定随机种子,并给每个实例分配稳定 ID,把 CPU 侧的 stableID -> slot 映射与 GPU 读取索引同时记录。
修复后应满足三个条件:同一可见对象在生命周期内保持稳定槽位或稳定映射;任何被 GPU 使用的实例区域都不会被提前覆盖;对象删除和搬移后,所有索引映射同步更新。若最小场景连续运行多帧不再出现位置、颜色或材质跳变,再逐项恢复 LOD、动画和异步更新,就能确认真正的触发条件。