
图形渲染与 Shader / 系统课时
一次 Draw Call 到底提交了什么
一次 Draw Call 到底提交了什么
理解 GPU Instancing 之前,需要先把 Draw Call 看成一次“带着完整上下文的绘制命令”,而不是一句简单的“画这个模型”。本节沿着一次提交链路,梳理网格、材质、常量与对象状态如何共同决定 GPU 最终执行的绘制。
学习目标
- 理解 Draw Call 与网格、材质和渲染状态之间的关系
- 分清公共绘制状态与对象级、实例级数据
- 看懂为什么实例化能够合并部分重复提交
Draw Call 不是只有一个网格参数
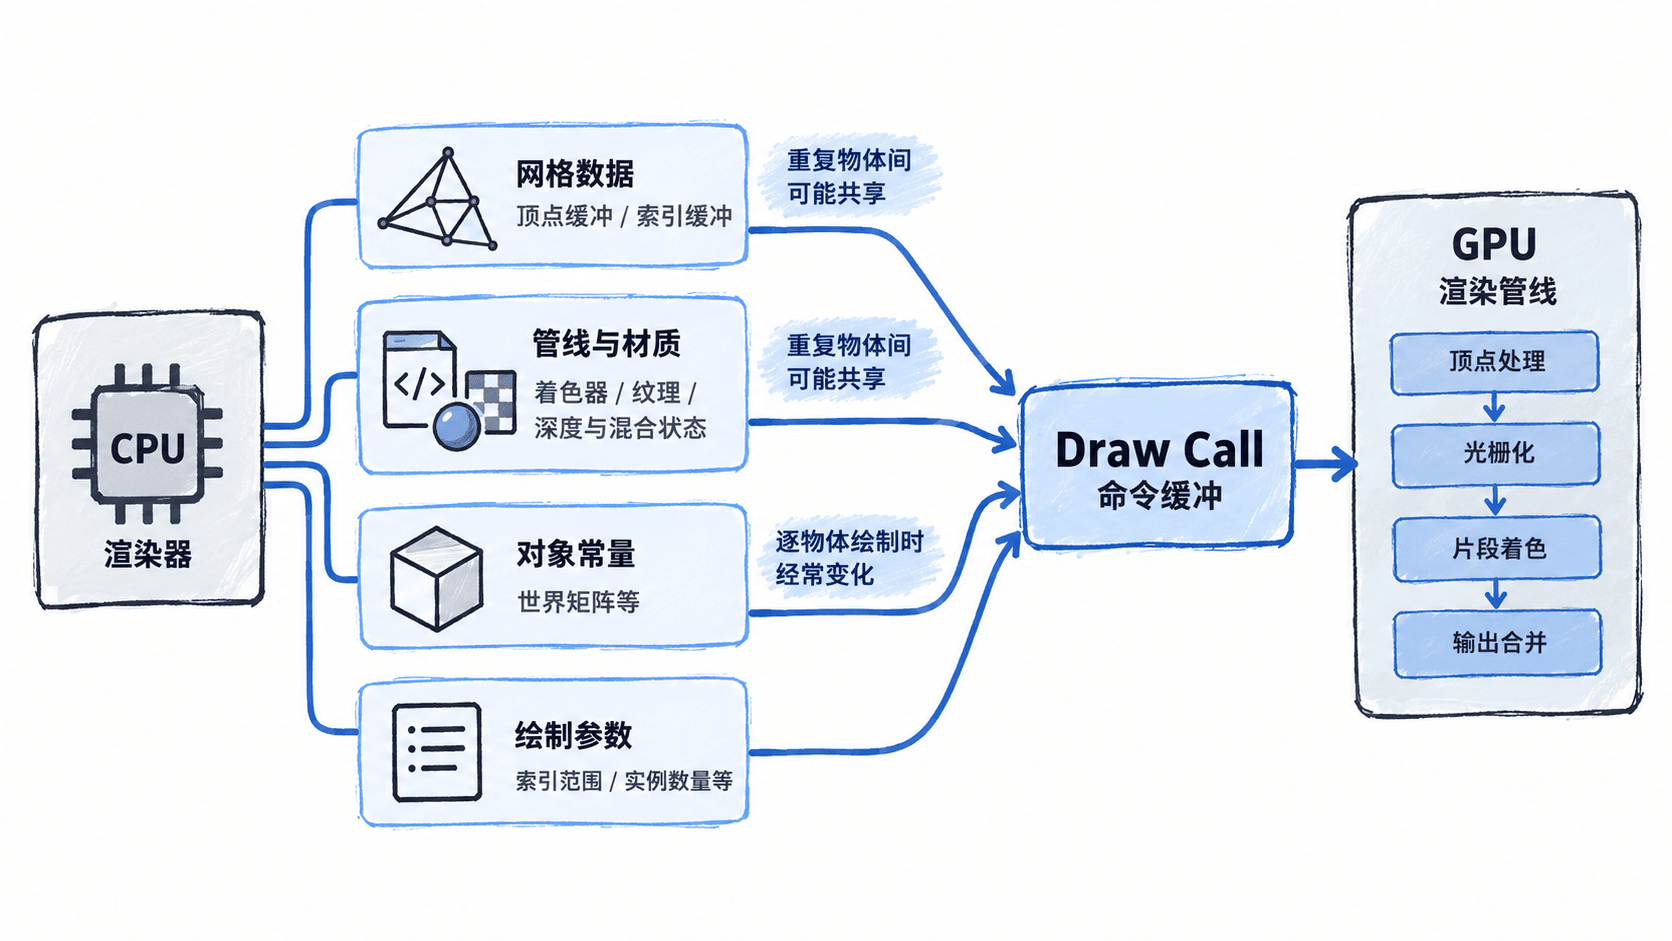
一次绘制要成立,GPU 必须知道“画什么”和“怎么画”。“画什么”通常来自顶点缓冲、索引缓冲以及绘制范围;“怎么画”则取决于当前图形管线、着色器、纹理、混合方式、深度状态以及着色器需要读取的参数。
所以从 CPU 视角看,一次 Draw Call 更接近某一时刻渲染状态的组合结果。CPU 先把必要状态和资源准备好,再记录绘制命令;GPU 随后按命令流读取这些状态并执行顶点、光栅化和像素阶段等工作。
网格负责说明画哪些几何
网格通常已经以 GPU 缓冲资源的形式存在。绘制时并不需要 CPU 每次重新发送整个模型文件,而是让命令引用已经创建的顶点缓冲、索引缓冲,并指定要绘制的顶点或索引范围。
这也是为什么 1000 个对象共享一个网格并不等于有 1000 份顶点数据。几何资源可以共享,但如果 CPU 仍然对每个对象单独记录绘制命令,提交次数依旧可能接近对象数量。
材质和管线决定怎么解释这些几何
着色器程序、纹理资源、深度测试、混合方式、剔除模式等状态共同决定网格如何进入最终画面。在现代图形 API 中,其中相当一部分状态会被组织进管线对象、描述符或其他资源绑定结构;具体名称随 API 而异。
当连续对象需要不同的着色器变体、纹理集合或关键渲染状态时,渲染器可能不得不切换对应状态,再记录下一次绘制。状态差异越大,可直接合并的空间通常越小。
对象常量让同一网格出现在不同位置
两个对象即使共享网格和材质,也必须让顶点着色阶段知道各自位于世界中的什么位置。传统逐物体绘制中,CPU 可以在每次 Draw Call 前更新当前对象的世界矩阵或其他对象级参数,然后提交这个对象的绘制。
于是同一组公共资源会出现这样的模式:网格相同、材质相同,但对象参数 A、B、C 不同,每变化一次对象参数就配合一次独立绘制。这正是重复实例大量出现时最值得合并的部分。
| 数据类别 | 重复物体间是否常见共享 | 典型内容 |
|---|---|---|
| 网格资源 | 是 | 顶点缓冲、索引缓冲 |
| 管线与材质状态 | 经常可以 | 着色器、纹理、深度与混合状态 |
| 对象或实例数据 | 通常不同 | 世界矩阵、颜色、实例参数 |
| 绘制范围 | 常常相同 | 索引起点、索引数量 |
Instancing 改变的是提交组织方式
GPU Instancing 的核心不是省掉每个物体的差异,而是重新组织这些差异。共享的网格、材质和管线状态仍作为公共部分使用,而多个对象各自的世界矩阵、颜色等差异被组织成实例数据;一次实例化绘制可以要求 GPU 对同一几何执行多次实例处理。
因此,理解一次 Draw Call 的关键,是把信息分成“能够共享的公共状态”和“每个实例必须不同的数据”。只有前者足够一致、后者能够按实例传递时,多个重复物体才具备合并为实例化绘制的条件。