
图形渲染与 Shader / 系统课时
为什么同网格物体也会拖慢 CPU
为什么同网格物体也会拖慢 CPU
场景里摆放大量相同树木、石块或路灯时,GPU 可能还有余力,CPU 帧时间却已经明显上升。本节从逐物体提交的角度拆开这部分成本,解释为什么“网格相同”并不自动意味着渲染提交便宜。
学习目标
- 理解同一网格被重复绘制时 CPU 仍要承担哪些工作
- 区分 Draw Call、状态设置与 GPU 实际执行的职责
- 判断大量重复物体为什么适合进一步做批量提交
同一个网格不等于同一次提交
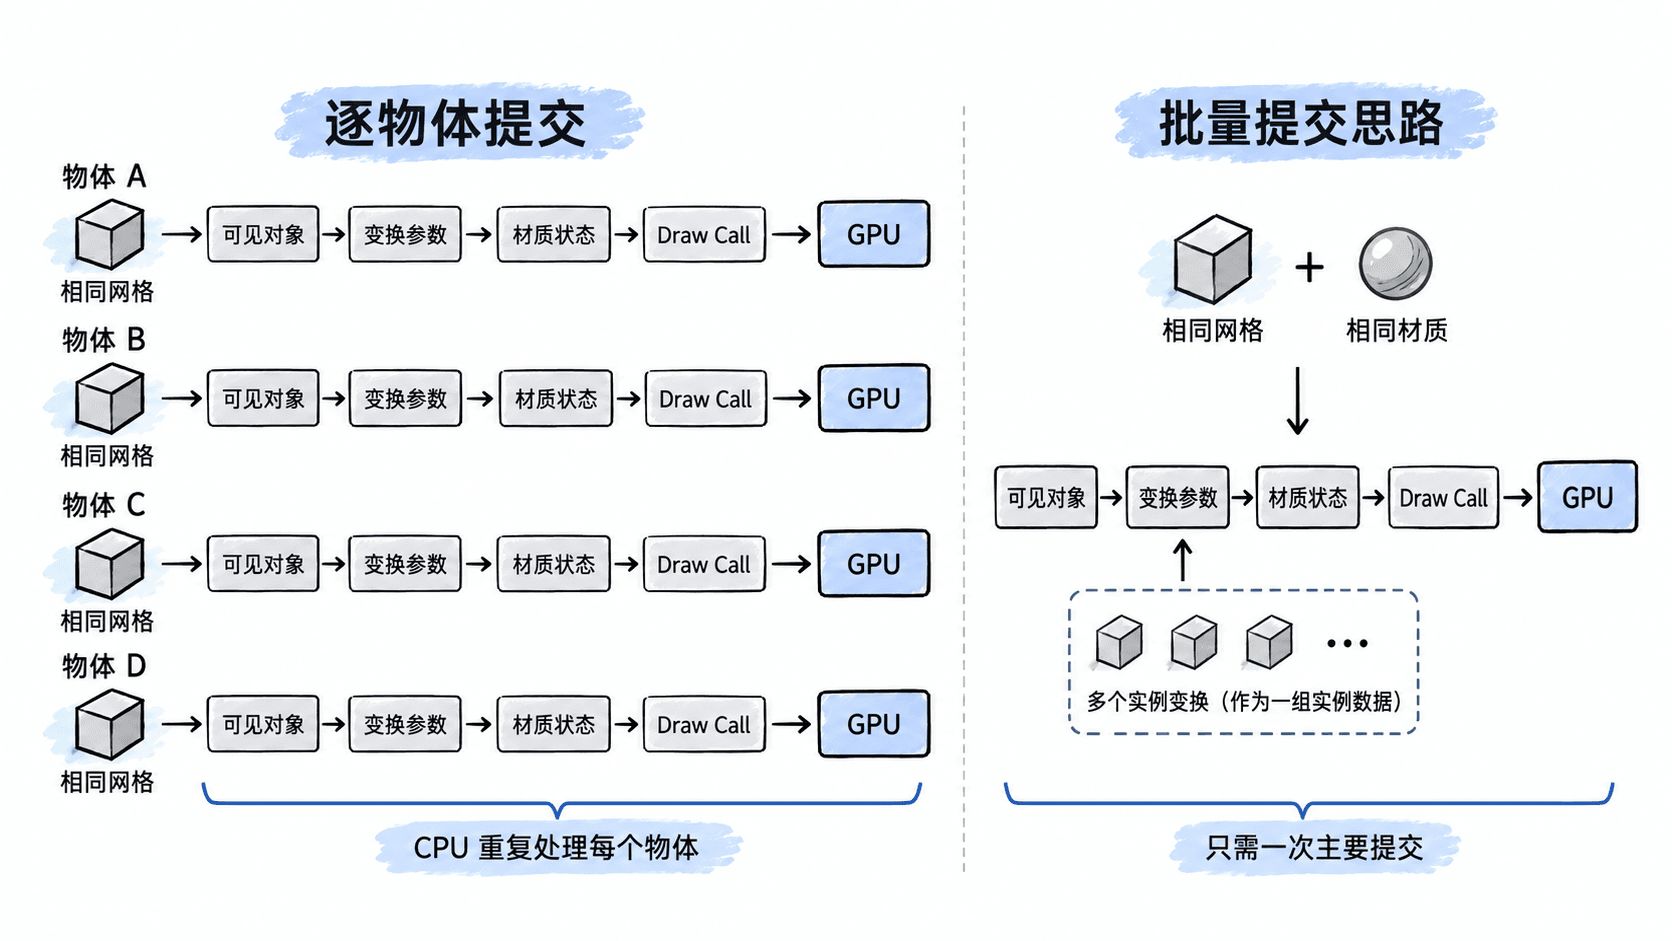
假设场景里有 1000 棵树,它们引用完全相同的网格和材质。如果渲染器仍按物体逐个处理,那么 CPU 通常需要遍历这 1000 个可见对象,并为每个对象准备一次绘制所需的信息。
网格顶点本身可以复用,但每棵树至少拥有不同的世界变换,例如位置、旋转和缩放。渲染器还可能需要确认材质状态、绑定资源、更新对象级参数,并把对应的绘制命令记录到图形 API 的命令流中。
因此,真正需要关注的不是“模型文件有几份”,而是“一帧内 CPU 要准备多少次独立绘制提交”。
CPU 在一次逐物体绘制前做什么
不同引擎与图形 API 的实现细节会变化,但逐物体渲染常见的 CPU 工作可以归纳为三类。第一类是对象处理,例如判断当前对象是否可见、选择渲染阶段并取得世界变换。第二类是状态准备,例如选择管线、材质参数、纹理或其他资源。第三类是命令记录,把这次绘制及其依赖状态写入命令缓冲或驱动能够处理的提交结构。
这些工作单次看起来很小,但它们发生在 CPU 上,而且会随着独立绘制次数增长。当对象数量从几十增加到几千甚至更多时,重复的函数调用、状态检查、参数更新和命令记录就可能累计成明显的帧时间。
状态切换为什么也会增加成本
如果连续物体使用不同材质、着色器变体或渲染状态,CPU 往往还需要在绘制之间调整管线状态。即使多个物体使用同一网格,只要它们无法共享足够多的渲染状态,就很难简单合并为一次批量绘制。
反过来,如果大量对象同时满足“网格一致、材质和管线兼容,只是每个实例的变换或少量参数不同”,就形成了非常适合实例化渲染的数据形态:公共几何与公共状态只提交较少次数,实例差异集中放进实例数据。
判断瓶颈时不要只看三角形数量
面对“相同小物体很多就掉帧”的场景,应同时观察 CPU 与 GPU。若降低模型面数后改善有限,而减少可见对象数量或减少独立绘制后 CPU 帧时间明显下降,问题更可能出在提交路径,而不是单纯的顶点处理能力。
一个实用判断是:当场景包含大量重复网格,而且这些对象共享材质与渲染状态时,逐物体提交会让 CPU 重复准备高度相似的命令。GPU Instancing 的价值正是减少这类重复提交,而不是让 GPU 凭空少绘制那些实例。