
图形渲染与 Shader / 系统课时
动态实例怎样避免重复拷贝
动态实例怎样避免重复拷贝
动态实例每帧都可能移动,但“会变化”不等于“所有实例都要整批重传”。这一课用持久映射、分段更新和按需更新三种思路,把 CPU 到 GPU 的数据搬运控制在真正发生变化的范围内,并避免覆盖 GPU 仍在读取的数据。
学习目标
- 判断整批重传为何会浪费总线带宽与 CPU 时间
- 理解持久映射、环形分段和脏区更新各自解决的问题
- 根据实例变化比例选择合适的数据更新策略
先找到重复拷贝发生在哪里
最常见的低效路径是:CPU 维护一份实例数组,每帧修改少量元素,却仍把整个数组交给 glBufferSubData。如果共有 100000 个实例、每个实例数据 64 字节,即使本帧只移动 500 个对象,整批上传仍要搬运约 6.1 MiB。
真正需要优化的不是“有没有调用上传 API”,而是每帧复制的字节数、调用次数,以及 CPU 是否会因为等待 GPU 读完旧数据而停顿。先统计变化实例比例,再决定是否值得引入更复杂的更新机制。
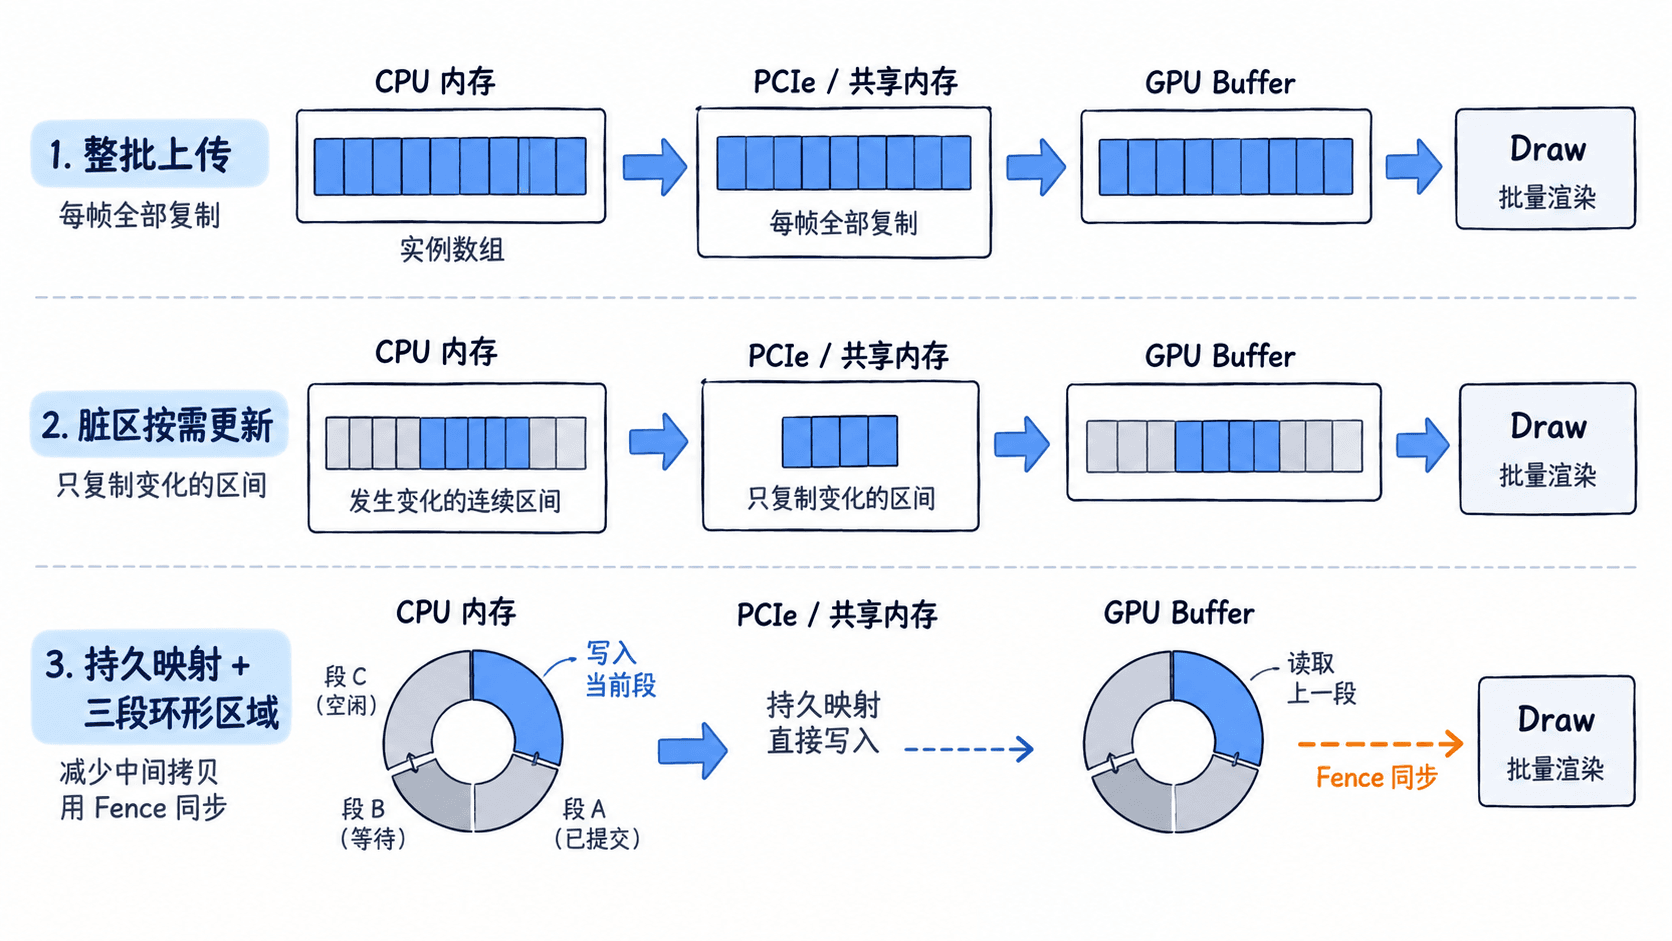
变化少时优先按需更新
当实例数组仍保存在普通 CPU 内存中,而每帧只有少量连续区域变化时,先记录“脏区”通常最划算。把多个相邻修改合并成较少的连续区间,再调用 glBufferSubData,可以同时控制复制字节数和 API 调用次数。
下面的可运行 C++ 示例只演示“合并脏区”的核心逻辑。真实渲染中,合并后的 [begin, end] 区间可换算成字节偏移,再传给缓冲区更新 API。
#include <algorithm>
#include <iostream>
#include <utility>
#include <vector>

int main() {
    std::vector<std::pair<int, int>> dirty = {
        {10, 14}, {13, 18}, {40, 43}, {44, 46}
    };

    std::sort(dirty.begin(), dirty.end());
    std::vector<std::pair<int, int>> merged;

    for (const auto& range : dirty) {
        if (merged.empty() || range.first > merged.back().second + 1) {
            merged.push_back(range);
        } else {
            merged.back().second = std::max(merged.back().second, range.second);
        }
    }

    for (const auto& range : merged) {
        std::cout << "[" << range.first << ", " << range.second << "]" << std::endl;
    }
}
预期输出
[10, 18]
[40, 46]
示例中的索引是实例编号。若每个实例占 64 字节,则第一个区间可从 10 * 64 字节处开始,只上传覆盖实例 10 到 18 的数据。实际项目还应设置合并阈值,避免为了几十个离散实例产生大量很小的更新调用。
高频变化时用分段写入隔离读写
如果多数实例每帧都会变化,脏区很快会接近整批数据,此时继续维护大量小区间意义不大。更稳妥的方式是把 GPU 缓冲区划成 2~3 段:CPU 写当前段,GPU 读取之前提交的段,下一帧再轮换。
这种环形分段的核心价值是避免“CPU 正要改的数据仍被 GPU 使用”。OpenGL 中常配合同步对象判断某一段是否已可复用;若 GPU 尚未完成,应等待、延后复用,或准备更多分段,而不是直接覆盖。
持久映射减少中间搬运
OpenGL 4.4 的缓冲区存储可通过 glBufferStorage 创建不可变存储,并配合 GL_MAP_PERSISTENT_BIT 长期保持映射地址。CPU 可以直接写映射区,不必每帧重新 map/unmap,也能减少应用侧重复复制和映射管理开销。
片段示例:下面只展示持久映射建立方式,依赖已经创建并绑定到 GL_ARRAY_BUFFER 的缓冲对象、有效的 OpenGL 4.4 上下文,以及已定义的 InstanceData 和 instanceCount。
const GLsizeiptr bytes = instanceCount * sizeof(InstanceData);
const GLbitfield flags =
    GL_MAP_WRITE_BIT |
    GL_MAP_PERSISTENT_BIT |
    GL_MAP_COHERENT_BIT;

glBufferStorage(GL_ARRAY_BUFFER, bytes, nullptr, flags);

void* mapped = glMapBufferRange(
    GL_ARRAY_BUFFER,
    0,
    bytes,
    flags
);
使用 GL_MAP_COHERENT_BIT 后不需要为普通 CPU 写入额外调用显式 flush,但仍必须处理“GPU 是否已消费旧内容”的同步时序。持久映射解决的是重复映射与数据搬运开销,不会自动解决 CPU 与 GPU 对同一区域的竞争。
按变化比例选择方案
实例几乎不变时,应把数据留在 GPU,仅在对象生成、销毁或属性变化时更新。变化量较小且能形成连续区域时,脏区合并加分段更新通常足够简单。绝大多数实例持续变化、上传量已经接近整批时,再考虑环形分段和持久映射。
优化的目标不是追求某个高级 API,而是让每帧搬运的数据接近真实变化量,并让 CPU 写入与 GPU 读取互不阻塞。验证时同时观察上传字节数、CPU 提交时间和同步等待时间,才能确认优化真正落到了帧时间上。