
图形渲染与 Shader / 系统课时
实例数据布局如何影响带宽
实例数据布局如何影响带宽
实例渲染的瓶颈不只取决于实例数量,还取决于每个实例到底要传输和读取多少字节。本课从结构大小、访问模式和对齐出发,检查实例数据布局是否让低频或无用字段长期占据热路径,并用可计算的字节量判断优化收益。
学习目标
- 计算实例结构大小对每帧数据量的影响
- 区分 AoS 与按用途拆分数据的访问差异
- 识别对齐、填充和低频字段造成的隐藏浪费
先算每个实例真正需要多少字节
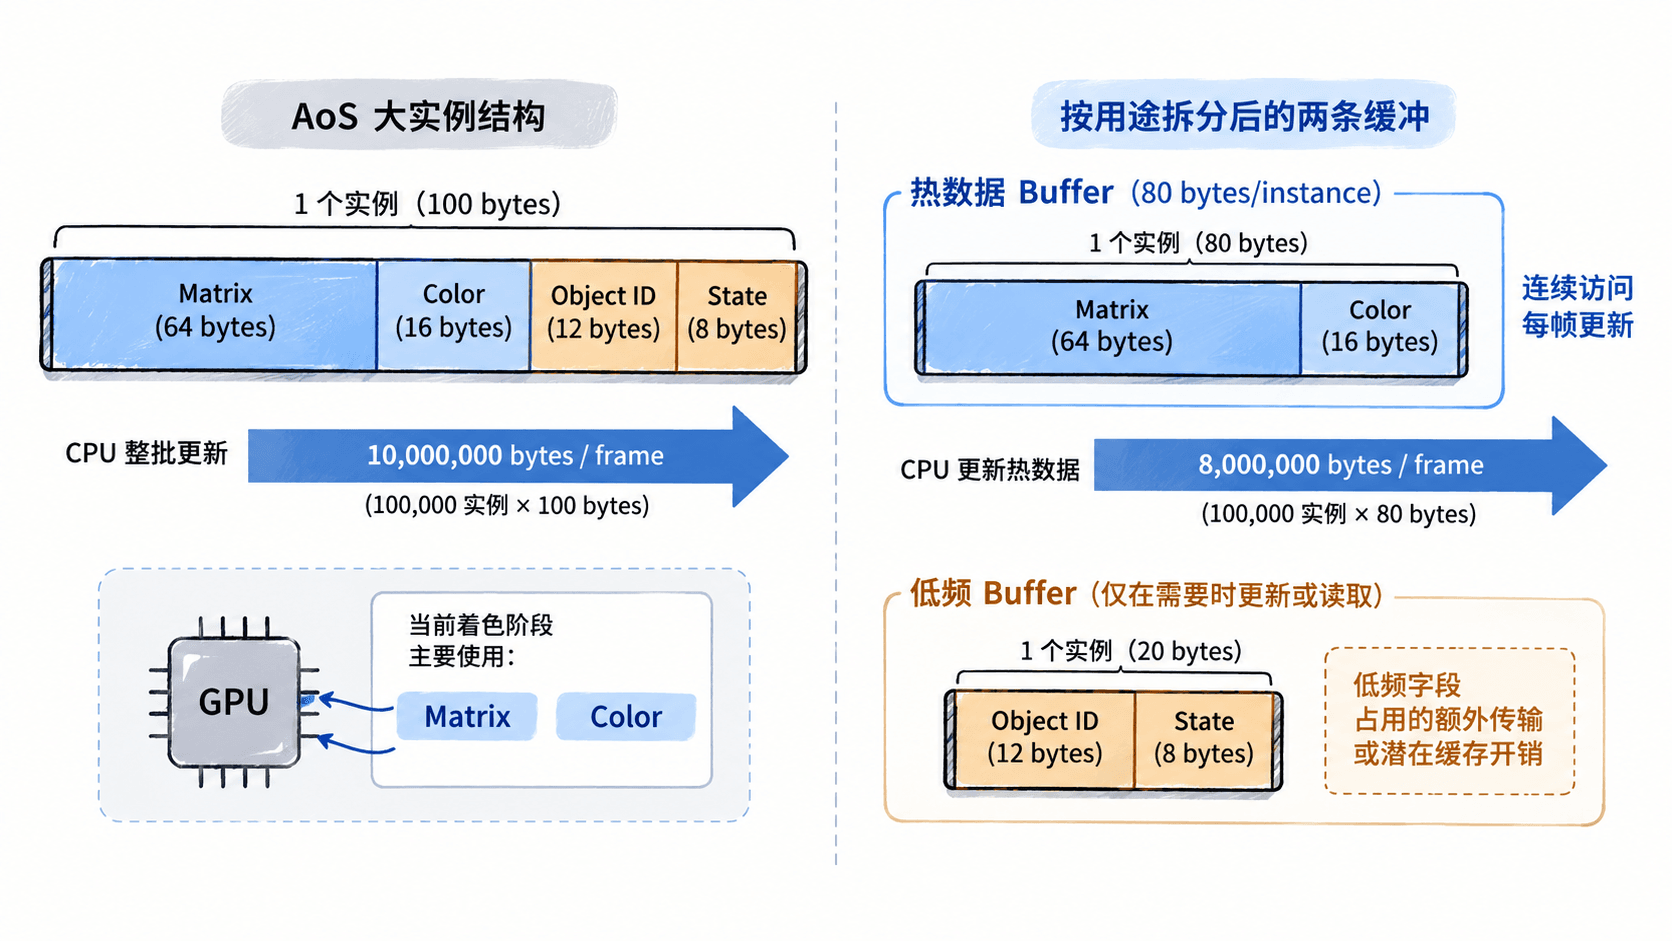
假设每个实例保存一个 4×4 变换矩阵、颜色、对象 ID 和额外状态向量,而当前绘制阶段主要需要变换与颜色。若 CPU 每帧仍按完整大结构上传,低频字段就会直接增加传输量;GPU 端是否产生同等比例的额外读取,则还取决于属性配置、硬件取数粒度和驱动实现。
带宽检查可以先用简单估算:每帧数据量约等于“实例数 × 每实例参与当前热路径的字节数”。这个值不等同于显卡最终显存流量,但足以判断一次布局调整是否值得继续验证。
#include <cstddef>
#include <cstdint>
#include <iostream>

int main() {
    constexpr std::size_t instances = 100000;
    constexpr std::size_t matrixBytes = 16 * sizeof(float);
    constexpr std::size_t colorBytes = 4 * sizeof(float);
    constexpr std::size_t idBytes = sizeof(std::uint32_t);
    constexpr std::size_t stateBytes = 4 * sizeof(float);

    const std::size_t wide = matrixBytes + colorBytes + idBytes + stateBytes;
    const std::size_t compact = matrixBytes + colorBytes;

    std::cout << "wide bytes/frame: " << instances * wide << std::endl;
    std::cout << "compact bytes/frame: " << instances * compact << std::endl;
}
预期输出
wide bytes/frame: 10000000
compact bytes/frame: 8000000
示例为了让计算可复现,直接按字段有效字节数统计,没有假设某个编译器对 C++ 结构体采用特定填充规则。真实工程中还应使用 sizeof(InstanceData) 检查 CPU 结构最终大小,并核对 GPU 侧属性格式。
AoS 方便管理但可能扩大热路径
AoS(Array of Structures)把一个实例的所有字段放在一起,CPU 更新单个对象时直观,上传完整实例也方便。问题出现在字段的更新频率差异很大时:变换每帧变化,而对象 ID、调试状态或其他属性很少变化,整结构更新会反复搬运这些冷数据。
GPU 顶点属性取数也不能简单理解为“定义了 100 字节结构就一定读取 100 字节”。实际访问由启用的属性、步长、硬件取数事务和着色器使用情况共同决定。因此优化时应把 CPU 上传字节数和 GPU 性能计数器分开测量,而不是只根据结构声明推断显存流量。
按访问模式拆分热数据和冷数据
更有效的布局依据不是“字段属于哪个对象”,而是“哪些字段会一起读取、一起更新”。经常变化并参与实例绘制的变换、颜色可以进入热数据缓冲;对象 ID、调试标记或低频状态则放入单独缓冲,只在发生变化或特定阶段需要时处理。
这种拆分首先能确定性地降低 CPU 到 GPU 的更新字节数,同时让频繁访问的数据更紧凑。代价是缓冲对象、绑定关系和生命周期管理会增加,因此字段很少、实例数量不大时,没有必要为了理论上的紧凑度过度拆分。
对齐与属性格式必须一起检查
数据布局优化不能只看 C++ 字段声明。CPU 端结构可能因成员对齐产生填充,GPU 端实例属性还有独立的分量类型、步长和偏移。最终应同时核对 sizeof、属性 offset、stride,以及着色器声明是否与 VAO 配置匹配。
片段示例:下面展示一个常见的实例矩阵属性配置。它依赖已经绑定的实例缓冲和有效 VAO,并约定着色器中的 mat4 占用从位置 4 开始的四个连续属性位置。
constexpr GLsizei stride = 16 * sizeof(float);

for (GLuint column = 0; column < 4; ++column) {
    const GLuint location = 4 + column;
    glEnableVertexAttribArray(location);
    glVertexAttribPointer(
        location,
        4,
        GL_FLOAT,
        GL_FALSE,
        stride,
        reinterpret_cast<void*>(column * 4 * sizeof(float))
    );
    glVertexAttribDivisor(location, 1);
}
这里四个属性共同使用 64 字节步长,glVertexAttribDivisor(location, 1) 让对应属性每推进一个实例才更新一次。验证时应检查着色器属性位置与 VAO 状态一致,并通过图形调试器确认每列矩阵的 offset 和 stride 没有错位。
用测量决定是否继续压缩
布局调整后至少比较三个指标:每实例结构大小、每帧实际上传字节数和 GPU 顶点阶段耗时。若上传量明显下降但 GPU 时间没有变化,瓶颈可能在顶点数量、片元负载、驱动提交或其他阶段,继续压缩实例字段未必有收益。
好的实例布局不是单纯追求最小结构,而是让经常一起更新和访问的数据保持紧凑,让低频字段退出热路径。结构大小、访问模式和对齐三者一起检查,再用性能数据验证,才能把带宽优化真正落实到帧时间上。