
图形渲染与 Shader / 系统课时
贴图差异为什么会拆批
贴图差异为什么会拆批
GPU Instancing 能把共享网格和渲染状态的对象合并到一次绘制中,但“只换一张贴图”往往已经改变了材质绑定状态。本课从纹理资源、采样器和材质状态三个层面解释拆批原因,并给出不破坏批次的常见组织方式。
学习目标
- 判断纹理差异何时会让实例无法进入同一批次
- 区分纹理资源、采样器状态与实例数据的职责
- 选择 Texture Array、图集或统一材质参数来保持批量绘制
同一批次真正共享的是什么
一次实例化绘制并不只是“网格相同”就够了。CPU 提交批次时,通常还要求这些实例共享着色器程序、材质关键字、渲染状态以及同一组可绑定资源。若两个对象分别绑定 albedo_a 与 albedo_b,驱动看到的是两套纹理绑定,往往需要拆成两次绘制。
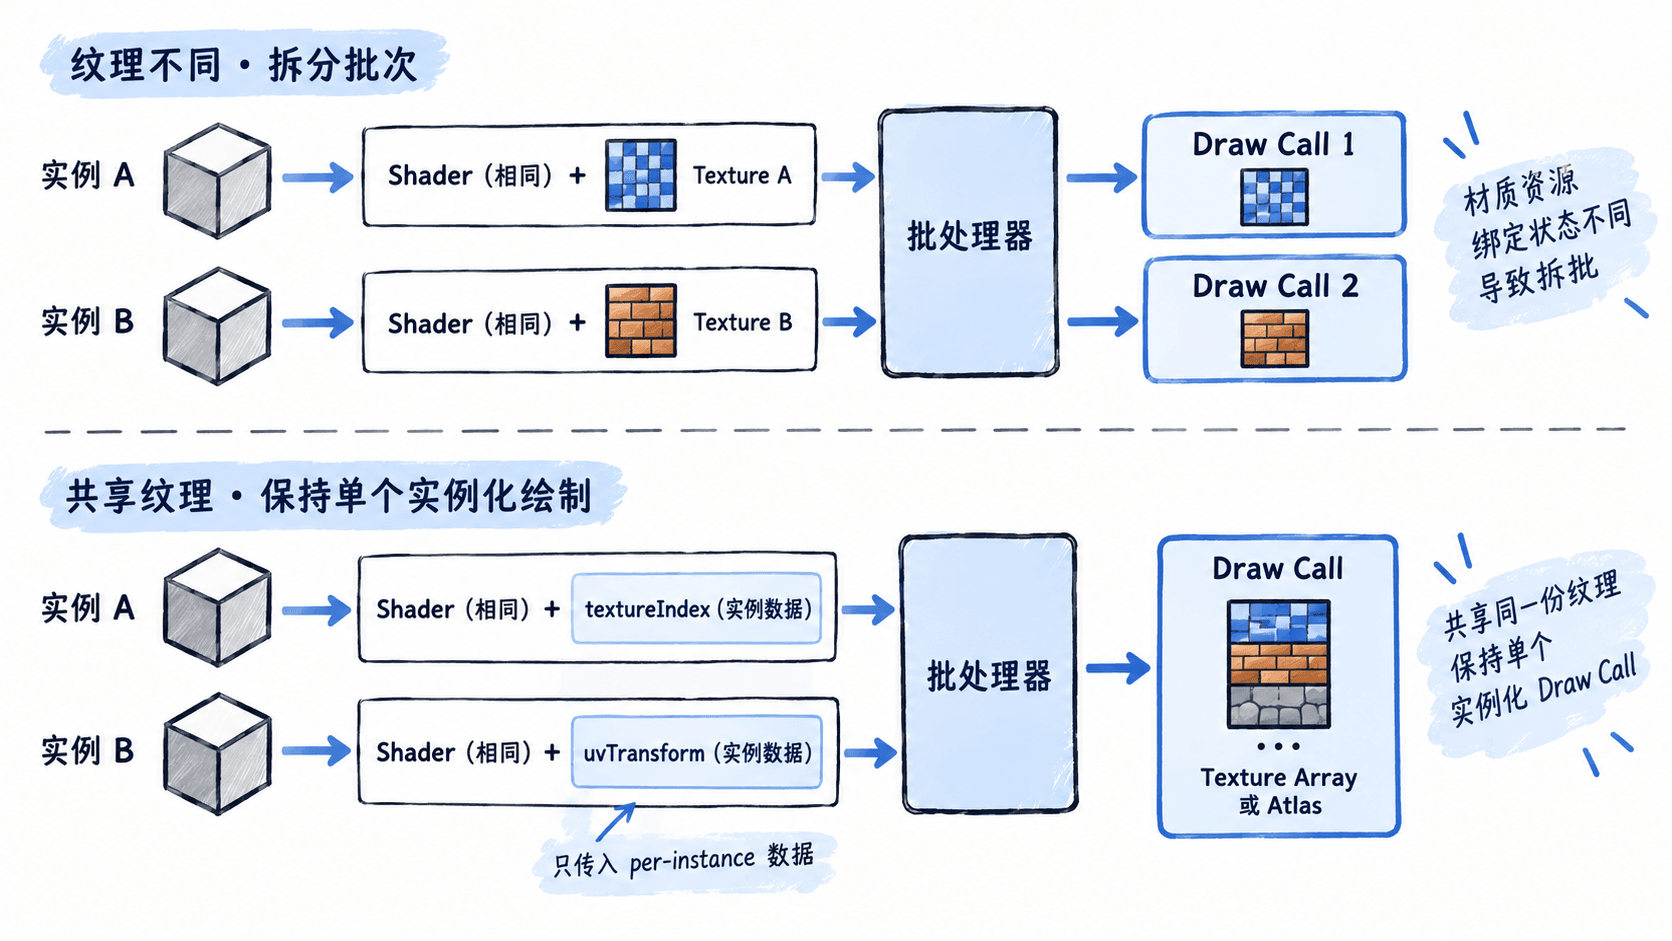
这里的关键边界是:可批量变化的数据应放进实例属性,不能要求每个实例重新绑定一套材质资源。 例如颜色、浮点参数、矩阵和纹理索引适合做实例数据;独立纹理对象、不同混合模式或不同 Shader Variant 则更容易改变整次绘制的状态。
纹理和采样器为什么都可能影响批次
纹理是图像资源,采样器决定过滤、寻址和各向异性等读取方式。不同引擎和图形 API 对二者的绑定模型不同,但从批处理视角看,只要对象之间需要切换绑定资源或采样状态,就可能引入新的状态组合。
| 差异来源 | 是否容易拆批 | 更合适的处理 |
|---|---|---|
| 每实例颜色、强度 | 低 | 放入实例属性 |
| 不同纹理对象 | 高 | Texture Array、图集或统一资源表 |
| 不同纹理尺寸或格式 | 中到高 | 先统一规格再进入数组/图集 |
| 不同过滤或寻址方式 | 中到高 | 尽量统一采样器状态 |
| 不同材质关键字 | 高 | 减少 Variant,按功能分组 |
用纹理数组把差异变成实例数据
Texture Array 的思路是把多张规格一致的纹理组织成一个资源,整批实例只绑定一次纹理数组,每个实例再携带一个层索引。这样变化的是小型实例数据,而不是整套纹理绑定。图集也有类似作用,只是索引通常变成 UV 偏移与缩放。
这种方案要求纹理尺寸、格式、mip 规则等满足资源组织要求;如果纹理差异很大、数量频繁变化,强行合并反而会增加内存浪费和资源管理复杂度。此时按材质或纹理集合分组,得到少量稳定批次,通常比追求“所有对象只打一批”更实际。
排查拆批时先看状态,再看实例数量
看到 Draw Call 增加时,不要先怀疑实例数量上限。先在 Frame Debugger、RenderDoc 或引擎统计面板中确认相邻绘制的 Shader、材质关键字、纹理绑定和采样状态是否一致;若只因纹理不同而被拆分,再评估是否值得改成数组或图集。
判断标准可以简化为一句话:让大量对象共享同一套资源绑定,把真正需要变化的部分压缩成每实例数据。 这既符合 GPU Instancing 的工作方式,也能避免为了省 Draw Call 而制造新的资源管理成本。