
图形渲染与 Shader / 系统课时
从单物体绘制改成批量绘制
从单物体绘制改成批量绘制
场景里有几十到几千个使用同一网格和材质的物体时,逐对象调用绘制接口会产生大量重复提交。本节把传统的“设置变换再 Draw”改成一次准备全部实例数据、一次发起实例化绘制,并明确哪些数据仍然共享、哪些数据必须按实例变化。
学习目标
- 区分逐对象绘制与实例化批量绘制的数据组织方式
- 使用 OpenGL 实例化接口一次提交多个相同网格
- 判断哪些物体适合合并为一个实例批次
从 N 次 Draw 变成一次实例化 Draw
传统写法通常遍历对象,每次更新模型矩阵,然后调用一次 glDrawElements。如果有 1000 个相同网格,就可能产生 1000 次绘制提交。GPU 真正处理的顶点数量未必减少,但 CPU 到图形 API 的提交次数会明显增加。
实例化绘制把共享数据与实例数据拆开:网格顶点、索引和大部分材质状态只绑定一次;位置、旋转、缩放或完整模型矩阵则整理成实例数组。随后使用 glDrawElementsInstanced,把实例数量作为一次绘制调用的参数交给 GPU。
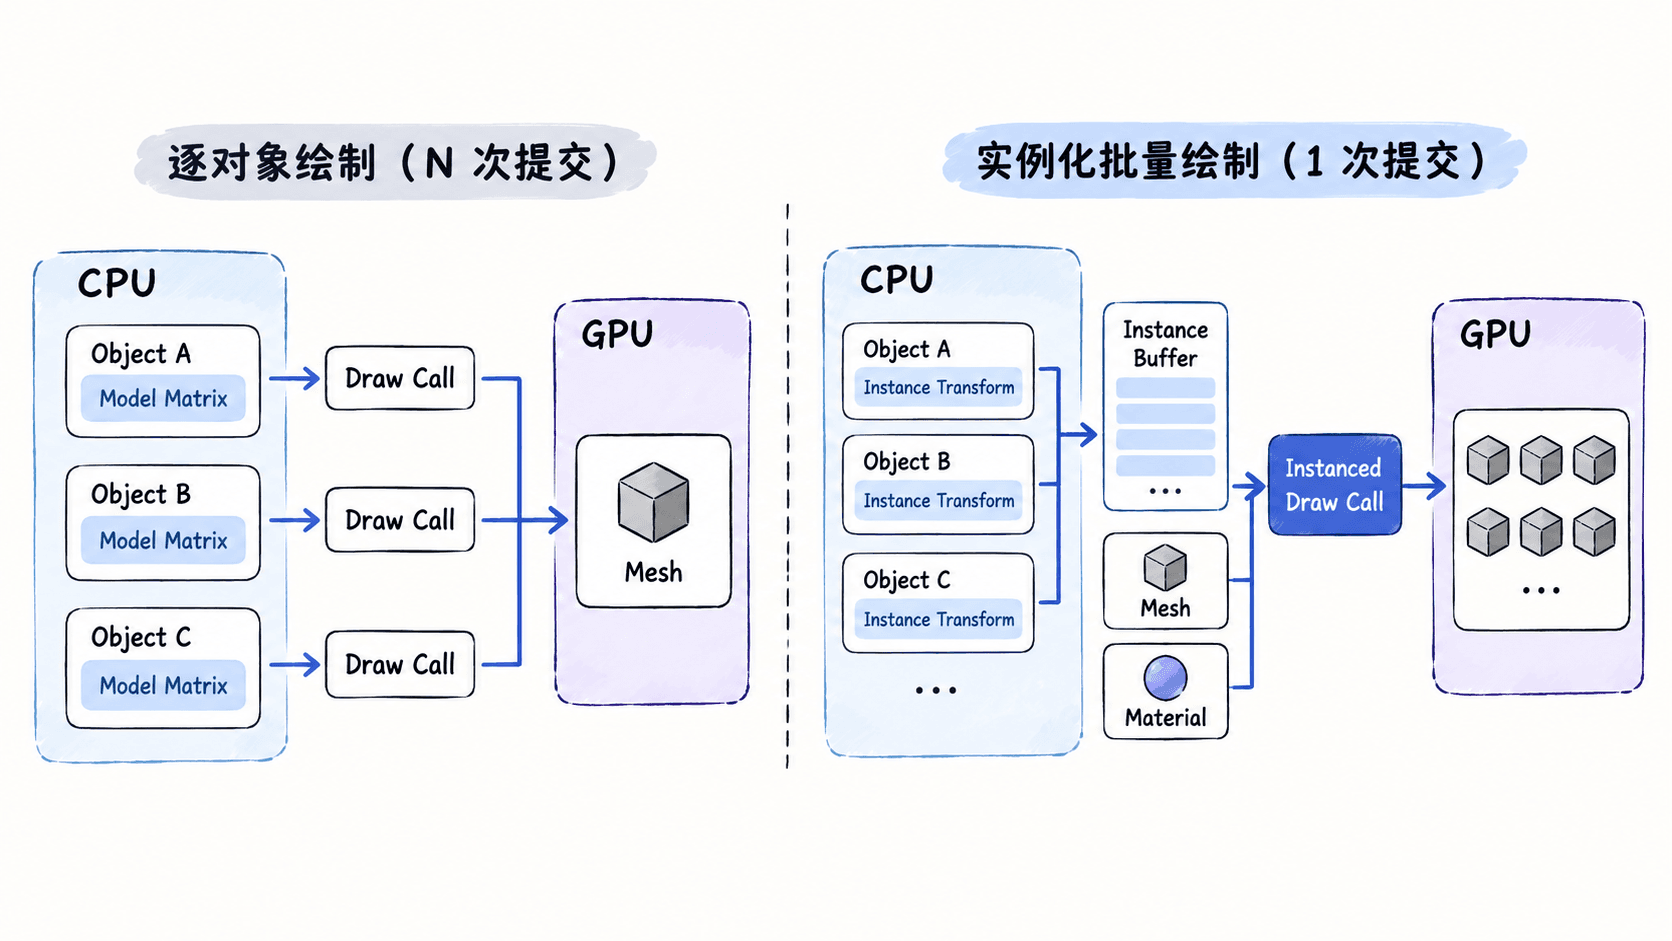
批量并不意味着所有物体都必须完全相同。通常要求它们共享同一套网格拓扑与绘制状态,而每个实例可以拥有不同的变换数据,甚至还可以扩展颜色、材质索引等实例属性。
准备实例变换数据
假设 VAO、顶点缓冲、索引缓冲和着色器已经创建完成,可以把每个物体的模型矩阵连续存入一个实例 VBO。下面是片段示例,依赖有效的 OpenGL 上下文、已经创建的 vao、instanceVbo,以及包含三个 glm::mat4 的 modelMatrices。
glBindVertexArray(vao);

glBindBuffer(GL_ARRAY_BUFFER, instanceVbo);
glBufferData(
    GL_ARRAY_BUFFER,
    sizeof(glm::mat4) * modelMatrices.size(),
    modelMatrices.data(),
    GL_STATIC_DRAW
);

// mat4 在顶点属性中占用连续 4 个 vec4 槽位。
const GLsizei stride = sizeof(glm::mat4);
for (GLuint i = 0; i < 4; ++i) {
    const GLuint location = 3 + i;
    glEnableVertexAttribArray(location);
    glVertexAttribPointer(
        location,
        4,
        GL_FLOAT,
        GL_FALSE,
        stride,
        reinterpret_cast<void*>(sizeof(glm::vec4) * i)
    );
    // 每绘制一个实例才读取下一组矩阵列,而不是每个顶点都推进。
    glVertexAttribDivisor(location, 1);
}
这里最关键的是 glVertexAttribDivisor(..., 1)。普通顶点属性在每处理一个顶点时向后读取,而实例属性设置 divisor 为 1 后,会在切换到下一个实例时才推进。矩阵为何要拆成四个属性槽位,会在后续追踪顶点阶段数据时进一步说明。
发起一次批量绘制
实例缓冲配置完成后,绘制阶段不再对每个对象重复调用 glDrawElements。下面同样是片段示例,依赖前面已经绑定并配置好的 VAO,以及正确的索引数量 indexCount。
glBindVertexArray(vao);

glDrawElementsInstanced(
    GL_TRIANGLES,
    indexCount,
    GL_UNSIGNED_INT,
    nullptr,
    static_cast<GLsizei>(modelMatrices.size())
);
调用中的最后一个参数就是实例数量。假设索引缓冲描述一个立方体,而 modelMatrices 中有 500 个矩阵,GPU 会复用同一套网格数据执行 500 个实例,而 CPU 侧只发起一次实例化绘制调用。
预期结果不是终端文本,而是渲染画面中同时出现与 modelMatrices.size() 数量一致的物体,并且每个物体的位置、旋转或缩放与对应矩阵一致。可以同时使用图形调试器或引擎统计面板观察 Draw Call 数,确认原来的多次对象绘制已经合并为一次实例化提交。
批处理成立的边界
GPU Instancing 最适合大量共享网格和渲染状态、但实例属性不同的对象,例如草木、石块、弹壳、路灯或重复建筑部件。如果对象使用不同网格、不同着色器,或者频繁切换会破坏批次的材质状态,就不能简单塞进同一次实例化绘制。
真正的改写重点不是把 API 名称从 glDrawElements 换成 glDrawElementsInstanced,而是先把“共享一次的数据”和“每实例变化的数据”分离。只有数据布局与渲染状态也完成批量化,实例化调用才能稳定降低重复提交开销。