
图形渲染与 Shader / 系统课时
可见实例列表怎样驱动批量绘制
可见实例列表怎样驱动批量绘制
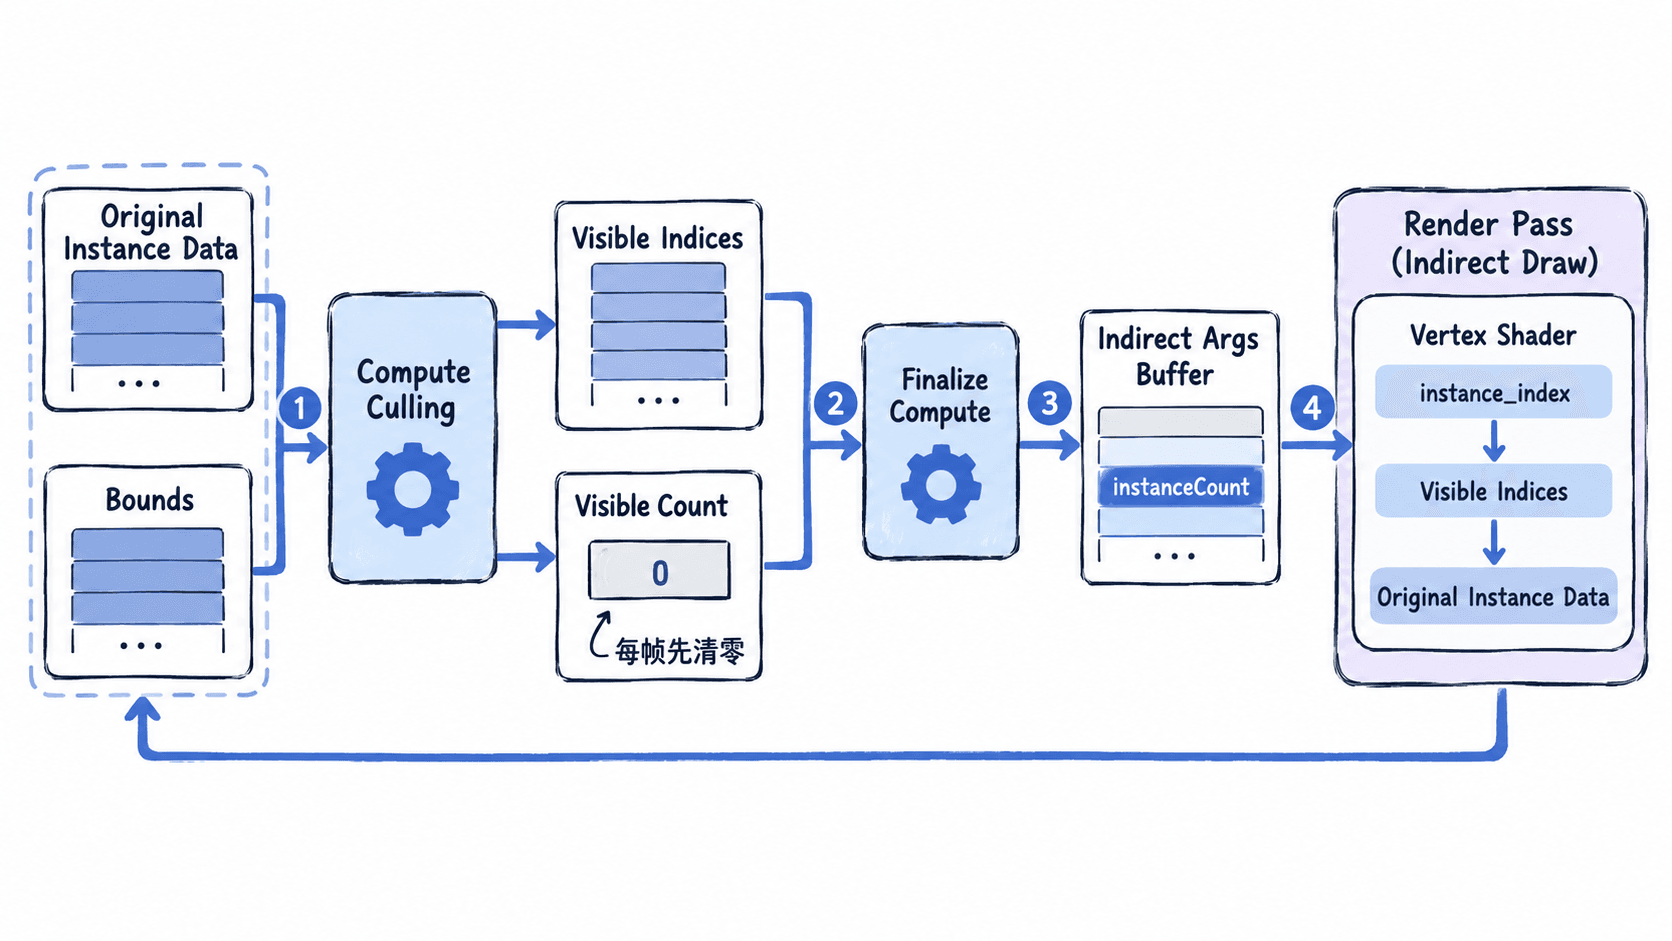
GPU 剔除只得到“哪些实例可见”还不够,渲染阶段还必须把这些结果真正消费掉。本篇把可见实例索引、可见计数、间接参数和实例数据串成一条完整链路,使最终批量绘制只处理剔除后保留下来的实例。
学习目标
- 理解可见实例索引列表为什么能把原始实例数据与紧凑绘制序号解耦。
- 掌握“剔除写列表 → 更新实例数量 → Indirect Draw → 顶点阶段反查实例”的数据流。
- 识别计数器重置、越界和错误同步等常见问题。
为什么不能只更新实例数量
假设原始实例有 10 万个,剔除后只剩 2 万个。单独把 instanceCount 改成 2 万并不能说明是哪 2 万个实例,因为 instance_index 只会得到连续的 0..19999,它不会自动跳过被剔除的原始实例。
解决方法是额外维护一个紧凑的 visibleIndices。剔除阶段把真实实例编号写入列表,例如 [3, 8, 11, 42, ...];绘制阶段把连续的绘制实例序号映射回真实实例编号,再从原始变换、材质或包围盒数据中取值。
剔除阶段怎样写紧凑列表
最常见的方法是用原子计数器分配写入位置:每个可见实例执行一次 atomicAdd,返回值就是它在 visibleIndices 中的槽位。这样不需要 CPU 预先知道可见数量,也不要求线程按实例编号顺序完成。
下面是片段示例,假设包围盒和视锥判断函数已经在同一 WGSL 模块中定义;代码展示的重点是紧凑列表、计数器和间接参数之间的关系,不能脱离这些上下文单独编译。
@group(0) @binding(0)
var<storage, read> bounds : array<BoundingSphere>;

@group(0) @binding(1)
var<storage, read_write> visibleIndices : array<u32>;

@group(0) @binding(2)
var<storage, read_write> visibleCount : atomic<u32>;

@group(0) @binding(3)
var<storage, read_write> indirectArgs : array<u32>;

@compute @workgroup_size(64)
fn cull(@builtin(global_invocation_id) gid : vec3<u32>) {
    let instanceId = gid.x;
    if (instanceId >= arrayLength(&bounds)) {
        return;
    }

    if (isVisible(bounds[instanceId])) {
        // 原子加返回旧值,可直接作为紧凑列表的写入位置。
        let slot = atomicAdd(&visibleCount, 1u);
        visibleIndices[slot] = instanceId;
    }
}

@compute @workgroup_size(1)
fn finalizeIndirectArgs() {
    // drawIndirect 的第二个 u32 是 instanceCount。
    indirectArgs[1] = atomicLoad(&visibleCount);
}
每帧开始剔除前必须把 visibleCount 重置为 0,并确保 visibleIndices 的容量不小于候选实例上限。Compute Pass 完成后再运行 finalizeIndirectArgs,最后进入 Render Pass;同一命令编码顺序中的后续 pass 才能消费前面写出的结果。
绘制阶段怎样找到真实实例
Indirect Draw 只负责决定“执行多少个实例”。真正解决“画哪个实例”的,是顶点阶段的二次索引:instance_index 先访问 visibleIndices,得到真实的 instanceId,再用它读取原始实例变换、颜色或其他属性。
这意味着原始实例缓冲区不需要在每帧被压缩重排。剔除只维护一张较小的索引表,既减少复制成本,也让同一份实例数据能够被不同相机、阴影 Pass 或 LOD Pass 生成各自的可见列表。
容易出错的三个边界
首先是忘记清零计数器,结果会把上一帧数量累加到当前帧,最终越界写入列表。其次是列表容量与候选实例数不匹配,极端视角下所有实例可见时最容易暴露问题。最后是为了调试频繁把计数器读回 CPU,这会引入额外同步。
把这条链路跑通后,CPU 只需要提交固定结构的 Compute 与 Render 工作,真正随镜头变化的可见实例集合和实例数量都由 GPU 更新。这样批量规模越大,越能体现 GPU 驱动剔除与间接绘制的价值。