
图形渲染与 Shader / 系统课时
Instancing 和 LOD 如何配合
Instancing 和 LOD 如何配合
Instancing 负责把大量相同网格合并提交,LOD 则负责让远处对象使用更便宜的模型。真实项目不能只开启两项功能就结束,还要按距离先选择 LOD,再按网格与材质重新分组实例,否则批次规模、切换抖动和可见性裁剪会互相影响。
学习目标
- 理解 LOD 切换为什么会自然拆分 Instancing 批次
- 设计按距离分级、再按渲染状态分组的实例化流程
- 控制 LOD 边界抖动与过大批次带来的额外成本
先选 LOD,再建立实例批次
同一种树木即使都支持 Instancing,只要当前选择的 LOD 网格不同,也不能直接放进同一个实例批次。实际流程通常是先做可见性判断和距离计算,为每个对象确定 LOD0、LOD1 或 LOD2,再按照网格、材质和其他会影响渲染状态的条件分桶。
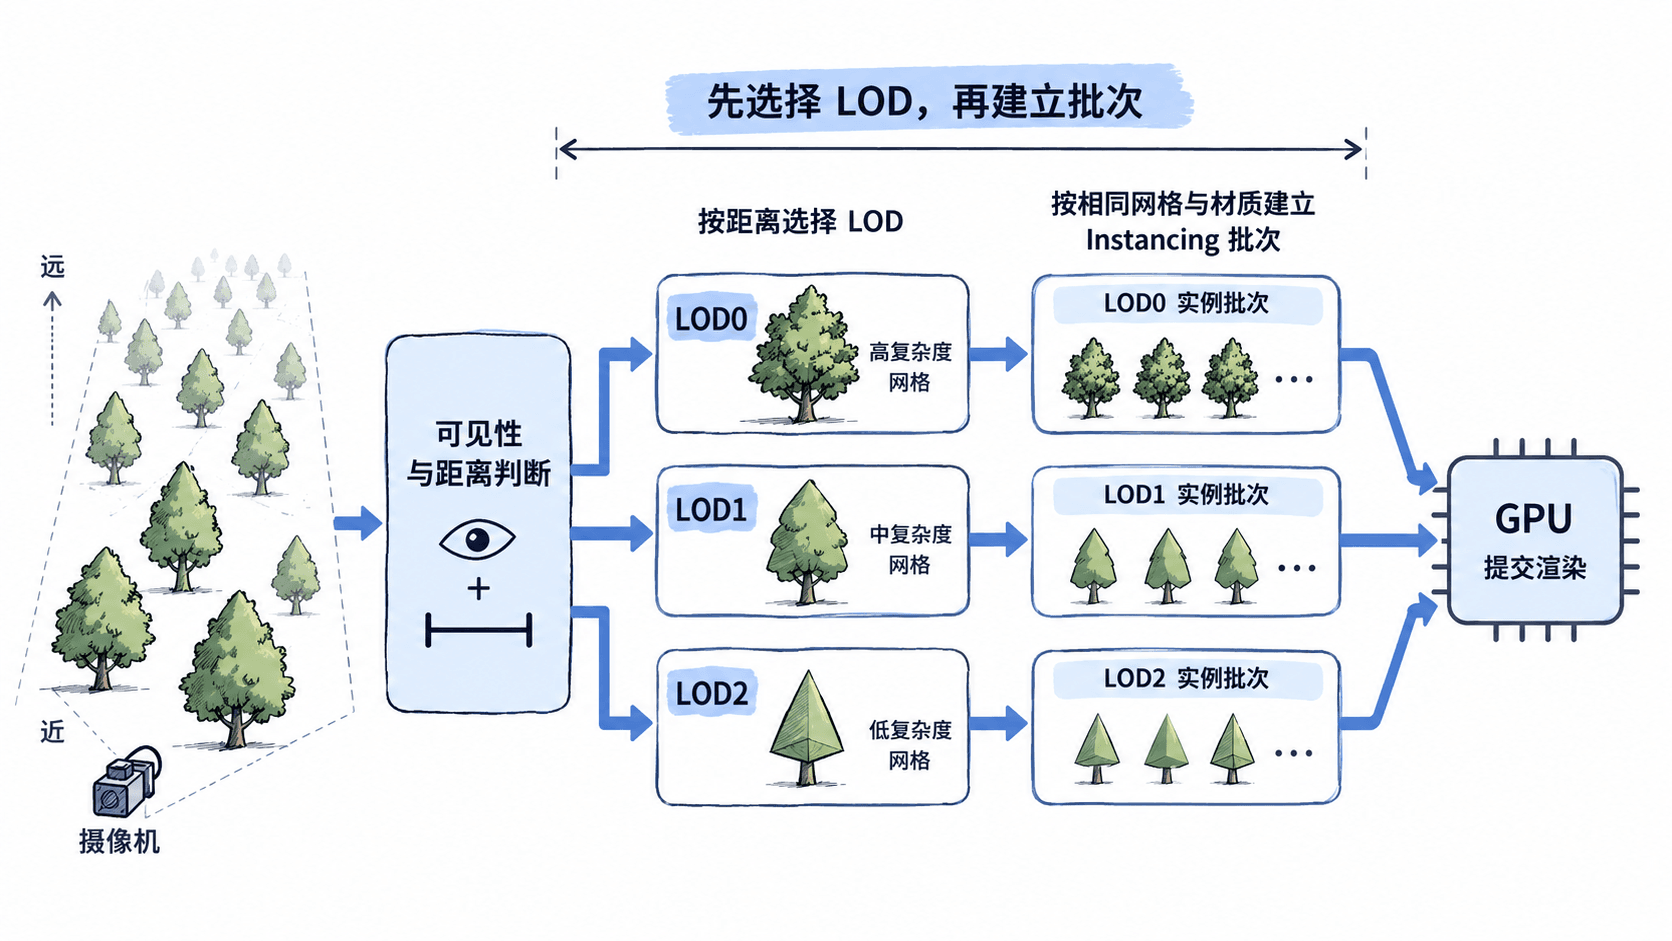
这样组织后,近处高模对象、中距离中模对象和远处低模对象分别形成批次。虽然批次数比“所有对象强行放在一个批次”更多,但 GPU 不再为远距离对象处理没有视觉价值的高精度顶点,通常更符合真实场景的成本结构。
用一个小程序观察分组结果
下面用距离模拟 LOD 分类,再统计每一级需要处理多少实例。真实引擎会把距离换成屏幕占比、包围体尺寸或项目自己的 LOD 指标,但“先分类再分批”的思路不变。
from collections import defaultdict
from math import ceil

DISTANCES = [12, 18, 34, 67, 72, 105, 140]
MAX_INSTANCES_PER_BATCH = 4


def choose_lod(distance: float) -> str:
    # 阈值只是演示值,项目中应根据视觉效果和性能测试确定。
    if distance < 30:
        return "LOD0"
    if distance < 80:
        return "LOD1"
    return "LOD2"


groups = defaultdict(list)
for instance_id, distance in enumerate(DISTANCES):
    groups[choose_lod(distance)].append(instance_id)

for lod in ("LOD0", "LOD1", "LOD2"):
    count = len(groups[lod])
    batches = ceil(count / MAX_INSTANCES_PER_BATCH) if count else 0
    print(f"{lod}: instances={count}, batches={batches}")
预期输出:
LOD0: instances=2, batches=1
LOD1: instances=3, batches=1
LOD2: instances=2, batches=1
示例中的批次上限只是为了展示拆批逻辑,不代表某个图形 API 或游戏引擎的固定限制。实际项目应使用目标渲染接口允许的实例数量、常量缓冲区大小以及引擎自身的提交策略进行测试。
处理距离变化带来的抖动
如果 LOD0 在 30 米切到 LOD1,而对象或摄像机正好在 30 米附近来回移动,实例会连续在两个批次之间迁移。这不仅造成视觉跳变,还可能让每帧的分组结果频繁变化,增加 CPU 侧列表维护和实例数据更新成本。
常见做法是加入滞回区间,例如进入 LOD1 使用 32 米阈值,但已经处于 LOD1 的对象只有回到 28 米以内才重新进入 LOD0。另一个选择是做短时间交叉淡化,不过它可能让切换阶段同时绘制两个 LOD,应把额外像素和 Shader 成本计入预算。
批次越大并不一定越好
Instancing 希望批次足够大,以减少 CPU 提交次数,但如果一个批次包含空间上相距很远的对象,粗粒度裁剪可能变差。只要整个批次的包围范围仍与视锥相交,就可能保留本应单独剔除的实例,具体表现取决于引擎是否支持实例级 GPU Culling。
因此可以先按 LOD 分类,再按空间区域继续拆分,例如将森林按网格块组织。近处对象的 LOD 变化频繁,可以使用较小空间块;远处低模对象变化较少,则允许更大的批次。这样是在“提交次数”和“裁剪精度”之间寻找平衡,而不是单纯追求最大实例数。
用帧数据决定组合策略
调优时至少同时观察 CPU 渲染提交时间、Draw Call 或对应提交次数、各 LOD 实例数量、顶点处理量以及 GPU 帧时间。如果降低 Draw Call 后 GPU 时间反而增加,应检查远处是否仍使用过高 LOD,或者大批次是否导致无效实例没有被及时裁剪。
稳定的组合策略通常是:先裁剪不可见对象,为可见对象选择合适 LOD,再按网格、材质和空间区域组织实例批次。Instancing 解决“如何少提交”,LOD 解决“每个实例画多复杂”,两者分别优化不同层面的成本,只有一起纳入帧分析才能得到真正有效的结果。