
图形渲染与 Shader / 系统课时
GPU 剔除适合什么场景
GPU 剔除适合什么场景
把剔除移到 GPU,并不是“实例越多就越好”。它真正适合的是实例数量大、可见性变化频繁、CPU 已经成为瓶颈,而且剔除结果能直接留在 GPU 参与后续间接绘制的场景。判断时要比较数据移动、并行度与同步成本,而不是只比较单次测试速度。
学习目标
- 区分 CPU 剔除与 GPU 剔除各自承担的工作边界
- 理解 GPU 剔除需要避免 CPU 回读的原因
- 能根据实例规模、可见率和瓶颈位置选择剔除位置
CPU 与 GPU 剔除的边界
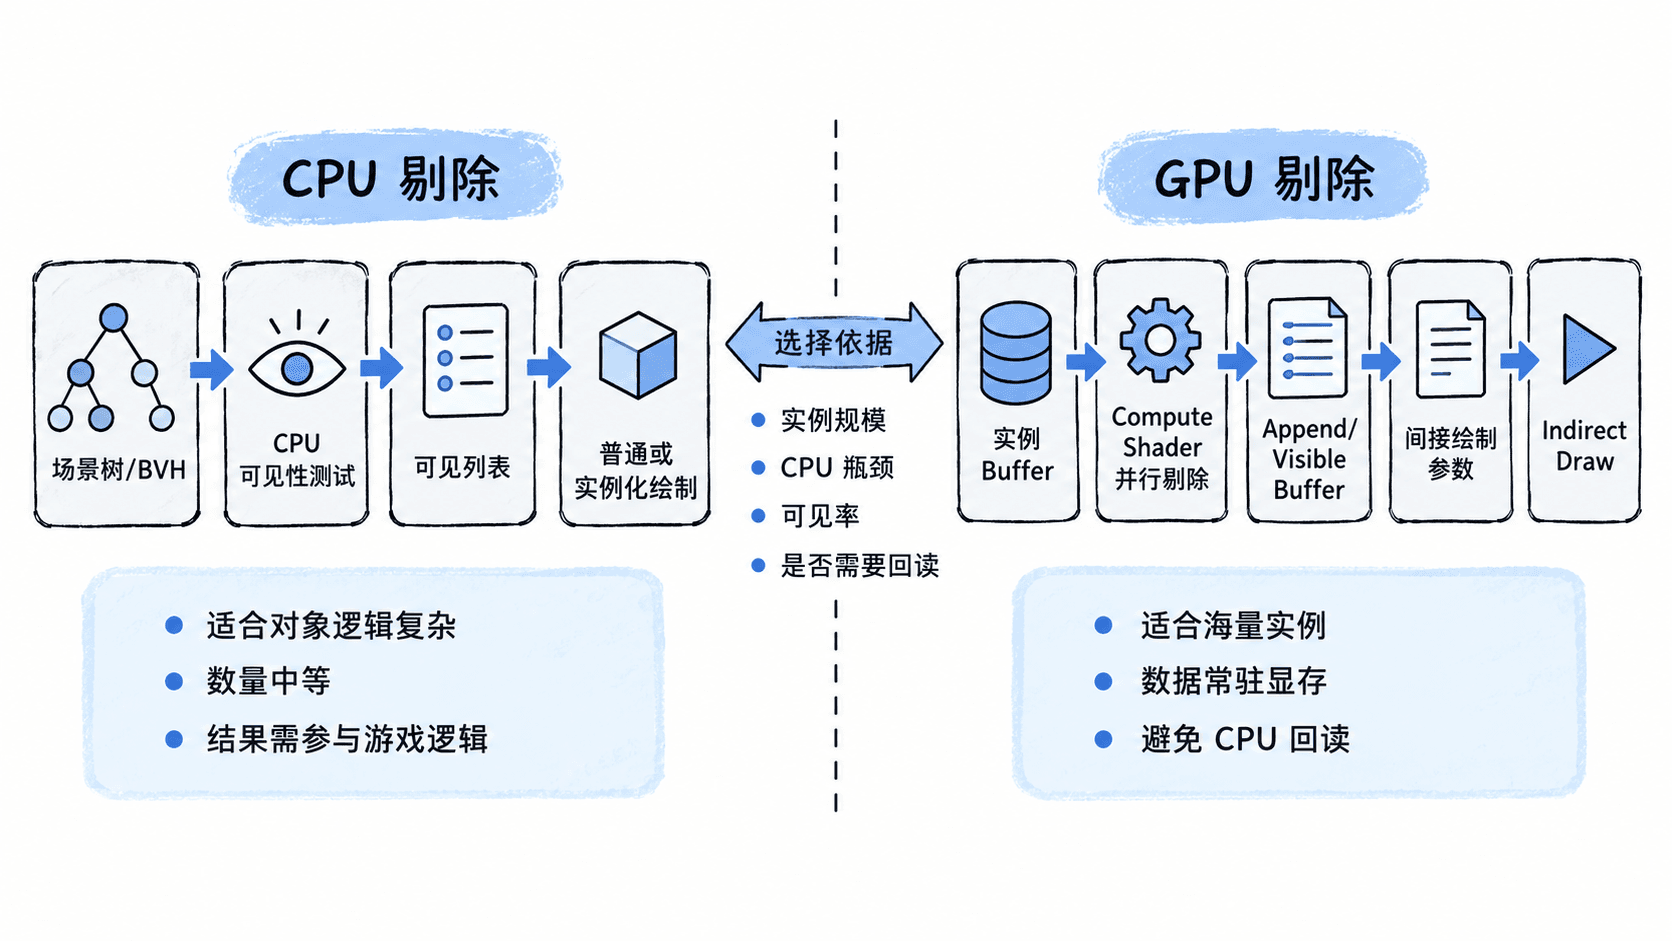
CPU 剔除更适合数量中等、对象管理逻辑复杂、结果还要参与脚本或游戏逻辑的场景。它容易调试,也能直接复用场景树、BVH、四叉树或八叉树等已有空间结构。
GPU 剔除更适合数量巨大且数据已经常驻显存的实例,例如草、石块、建筑碎片和海量装饰物。Compute Shader 可以让大量线程并行测试包围体,并把通过测试的实例索引直接写入 GPU Buffer。
GPU 剔除为什么要配合间接绘制
GPU 剔除最大的陷阱,是剔除完再把可见数量读回 CPU,然后由 CPU 决定绘制多少实例。读回会引入同步点,CPU 可能不得不等待 GPU 完成计算,抵消并行剔除带来的收益。
更顺畅的链路是:Compute Shader 生成可见实例列表,同时更新实例计数或间接参数缓冲区,随后由 GPU 直接执行 Indirect Draw。CPU 只负责发起计算与绘制,不需要知道本帧到底剩下多少可见实例。
下面是一个简化的 HLSL Compute Shader 片段,展示“测试后把可见索引追加到 Buffer”的核心形式。它依赖宿主程序绑定实例包围球、视锥平面与 AppendStructuredBuffer,因此不是独立可运行程序。
StructuredBuffer<float4> Bounds;          // xyz: 中心,w: 半径
AppendStructuredBuffer<uint> VisibleIds;
float4 FrustumPlanes[6];

[numthreads(64, 1, 1)]
void CSMain(uint3 id : SV_DispatchThreadID)
{
    uint index = id.x;
    float4 sphere = Bounds[index];

    [unroll]
    for (uint i = 0; i < 6; i++)
    {
        float distanceToPlane =
            dot(FrustumPlanes[i].xyz, sphere.xyz) + FrustumPlanes[i].w;

        if (distanceToPlane < -sphere.w)
            return;
    }

    VisibleIds.Append(index);
}
生效行为是:每个线程负责一个实例,通过六个视锥平面测试后才把索引写入 VisibleIds。验证时应统计 Append Buffer 的最终计数,并与 CPU 参考实现对比;相同相机参数下,两者的可见集合应一致或只存在可解释的浮点边界差异。
哪些情况值得迁移到 GPU
当实例达到数万甚至更多、每帧可见性都在变化,而且 CPU 已经花费明显时间遍历对象时,GPU 剔除通常值得评估。尤其是实例变换与包围体本来就在显存中,GPU 可以直接读取,省去每帧把大量剔除输入重新搬到 CPU。
另一个重要信号是:后续本来就要使用 Indirect Draw。此时剔除结果天然可以直接进入可见列表与绘制参数缓冲区,整个链路无需回读,GPU 剔除的优势最容易兑现。
哪些情况不适合
如果对象只有几百或几千个、CPU 剔除耗时很低,迁移到 GPU 往往只是增加 Buffer 管理、Compute Dispatch 和调试复杂度。可见集合还需要立即驱动 AI、交互、碰撞或脚本逻辑时,CPU 仍然要拿到结果,GPU 回读会使方案变得不划算。
同样,如果瓶颈其实在像素着色、透明叠加或带宽,而不是 CPU 遍历和顶点处理,改成 GPU 剔除也不会解决主要问题。应先用性能分析工具确认 CPU 帧时间、GPU 帧时间以及可见率,再决定迁移。
用四个问题做决策
可以先问四个问题:实例是否足够多;CPU 剔除是否已经占用显著帧时间;剔除输入是否能长期保留在 GPU;剔除结果是否能直接连接 Indirect Draw。如果四项大多成立,GPU 剔除通常更合理。
如果其中“必须读回 CPU”这一项成立,就应特别谨慎。GPU 剔除的核心价值不是把一段 for 循环搬到 Compute Shader,而是让海量实例的可见性计算与后续绘制都留在 GPU 流水线中,减少 CPU 参与和同步。