
图形渲染与 Shader / 系统课时
先剔除再实例化为什么更快
先剔除再实例化为什么更快
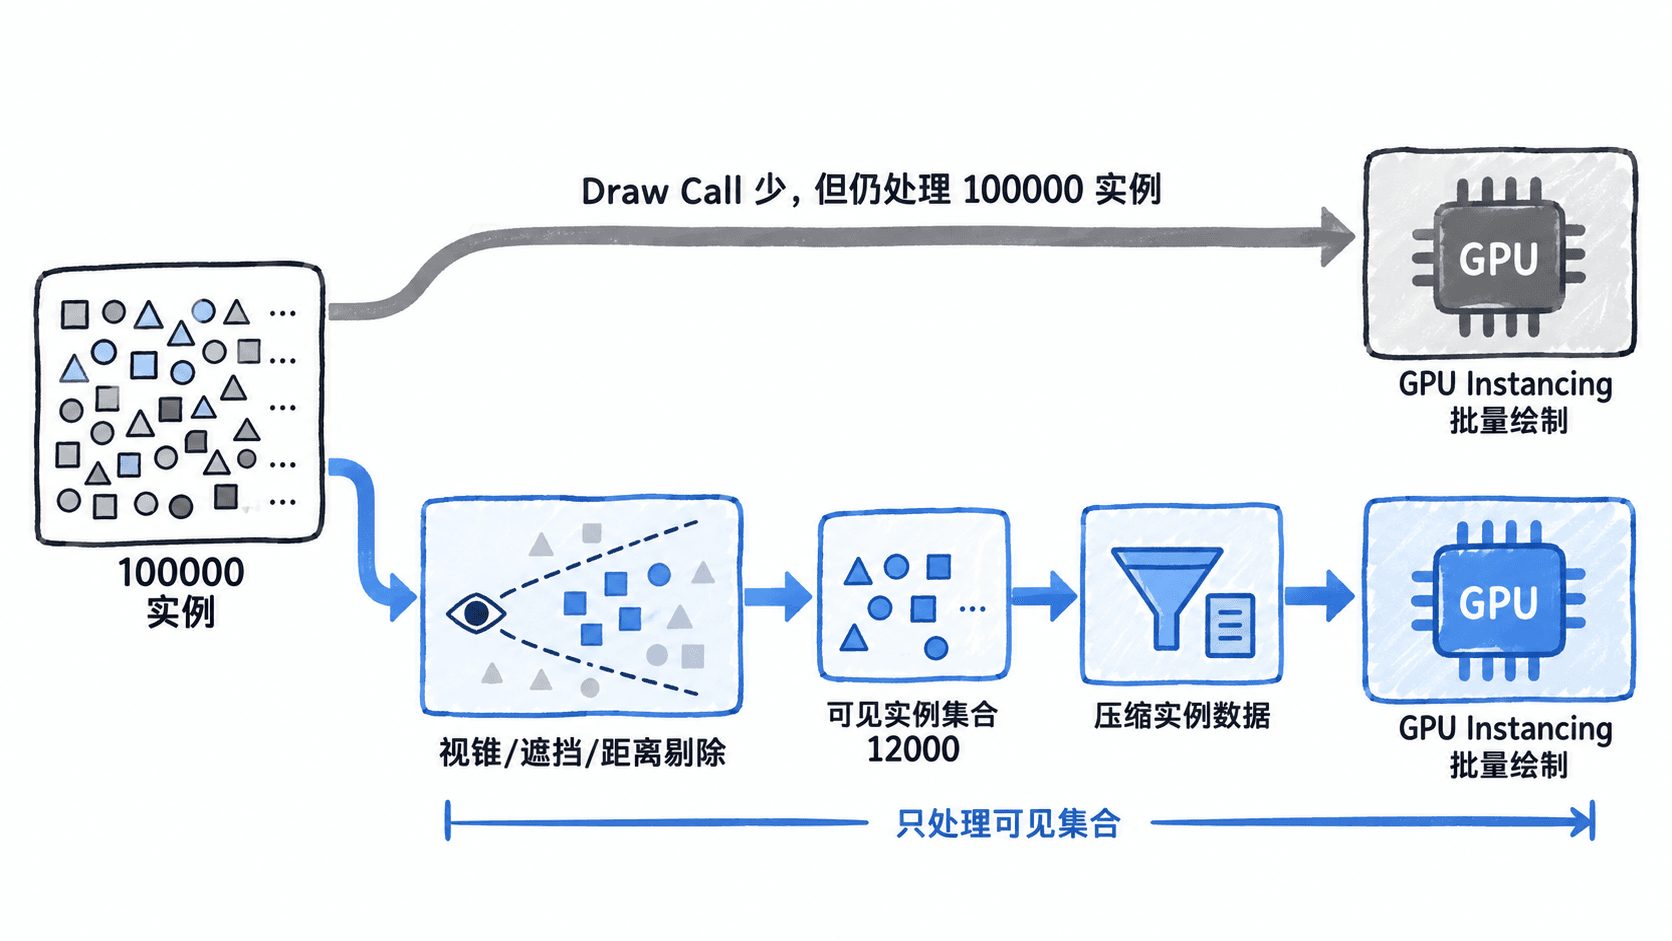
GPU Instancing 能减少 Draw Call,但它不会自动降低“被提交实例”的数量。真正影响大批量场景成本的是:先把视锥外、遮挡后或距离过远的实例排除,再只为可见集合准备实例数据并发起绘制。这样既减少顶点处理量,也减少实例缓冲区与命令参数的更新压力。
学习目标
- 理解实例总数、可见实例数与实际 GPU 工作量之间的关系
- 掌握“剔除 → 压缩可见集合 → 实例化绘制”的组合顺序
- 能判断批量绘制中性能瓶颈到底来自 Draw Call 还是无效实例
Instancing 解决的是提交次数,不是可见性
假设场景中有 100000 棵草。一次实例化调用可以把它们放进很少的绘制命令中,但如果 100000 个实例全部进入顶点阶段,GPU 仍然需要读取每个实例的变换数据并处理对应顶点。Draw Call 少了,不等于几何工作量也少了。
更准确地说,实例化优化的是“CPU 反复提交相同网格”的成本;剔除优化的是“后续真正参与渲染的实例数量”。两者解决的是不同层次的问题,因此最有效的组合通常是先求出可见集合,再对这个集合做 Instancing。
可见实例数如何影响成本
把实例总数记为 ,剔除后的可见实例数记为 。当网格复杂度近似固定时,实例化绘制阶段的顶点处理量通常更接近 而不是 。如果相机只能看到场景的一小部分,,那么剔除带来的收益会非常明显。
剔除本身也有成本,所以目标不是“任何实例都先做复杂剔除”,而是让剔除成本明显低于节省下来的渲染成本。包围球、AABB、距离阈值这类测试通常远比执行整套顶点着色和后续光栅化便宜,因此适合放在批量绘制之前。
先构建可见列表再提交
下面是一个简化的 CPU 侧片段,用包围球做视锥测试,只把可见实例写入待绘制列表。它不是完整项目入口,依赖引擎已经提供的相机视锥与批量绘制接口。
// 片段示例:先剔除,再把可见实例交给批量绘制。
visibleMatrices.Clear();

foreach (var instance in instances)
{
    var center = instance.BoundsCenter;
    var radius = instance.BoundsRadius;

    if (!cameraFrustum.IntersectsSphere(center, radius))
        continue;

    visibleMatrices.Add(instance.LocalToWorld);
}

instanceRenderer.DrawBatch(mesh, material, visibleMatrices);
生效行为是:视锥外实例不会进入 visibleMatrices,后续批量绘制只处理可见实例。验证时应同时记录总实例数与可见实例数;如果相机转向空旷区域,可见数量应显著下降,而绘制结果不应缺失视锥内对象。
为什么还要压缩可见集合
剔除后如果仍把一个固定大小的大数组整体上传,只在 Shader 中用标记跳过不可见实例,CPU 到 GPU 的数据传输与索引读取可能仍然很大。更理想的做法是把可见实例压缩成连续列表,让实例缓冲区、实例计数和最终绘制参数都围绕 构建。
当剔除发生在 GPU 上时,这一步通常表现为把通过测试的实例索引写入 Append Buffer,再根据实际计数生成间接绘制参数。这样 CPU 不需要读回可见数量,整个“剔除—计数—绘制”链路可以留在 GPU 内部。
什么时候收益最明显
大规模、空间分布稀疏、相机只能看到局部区域的场景最适合“先剔除再实例化”,例如草地、森林、碎石、城市重复构件和大量粒子化装饰物。如果绝大多数实例始终可见,或者单个实例只有极少顶点,复杂剔除反而可能得不偿失。
判断效果时不要只看 Draw Call。更应观察可见实例数、顶点着色调用量、实例数据上传量与 GPU 帧时间。Instancing 把提交次数压低,剔除把真正参与渲染的数量压低,两者结合才是扩大批量规模的关键。