
图形渲染与 Shader / 系统课时
实例数量为什么不是越多越好
实例数量为什么不是越多越好
把更多对象塞进一次实例化绘制可以减少 Draw Call,但批次越大并不一定越快。真正需要平衡的是提交开销、实例数据上传、可见性剔除和无效绘制。本节通过一个简单成本模型说明为什么超大批次可能适得其反。
学习目标
- 理解实例批次大小与 CPU、GPU 成本之间的关系
- 看懂超大批次在剔除和数据更新上的潜在代价
- 能根据场景可见性变化选择更合理的批次规模
大批次只优化了部分成本
GPU Instancing 最直接减少的是 CPU 侧绘制提交次数。例如 1000 个相同物体逐个绘制可能需要 1000 次提交,实例化后可能只需要少数几次。但一次批次中仍然要处理每个实例的变换、实例属性、顶点和像素工作,GPU 的实际负载不会因为 Draw Call 减少而消失。
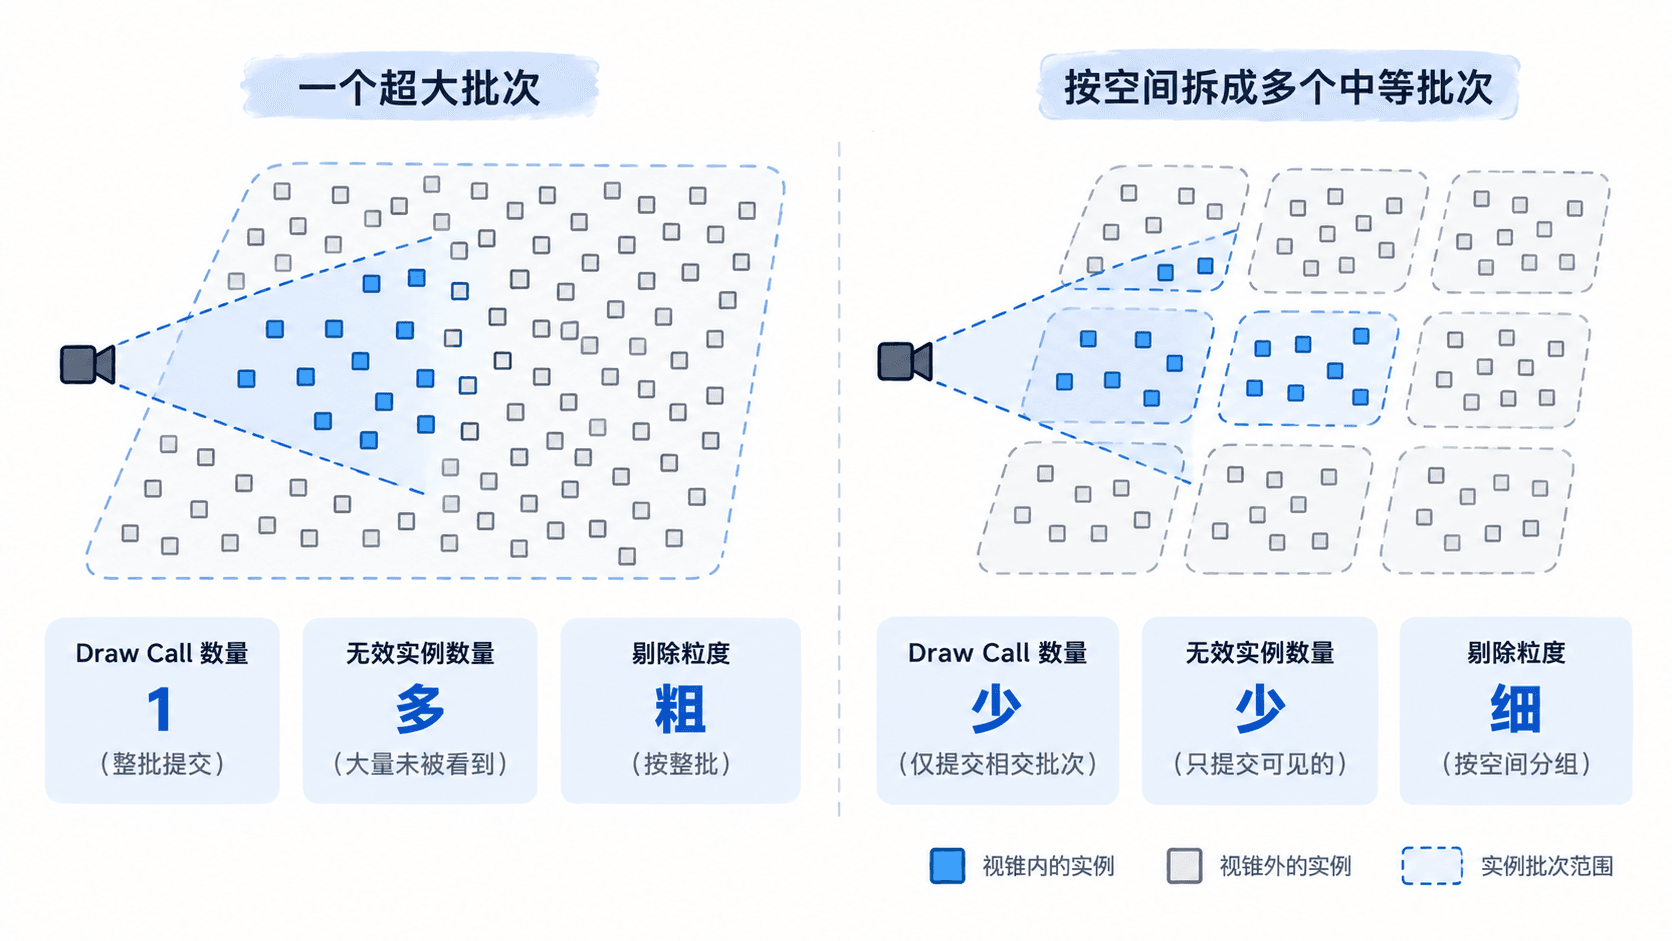
如果一个大批次里的对象分散在整张地图上,视锥体只看到其中一小部分,而渲染器只能以整个批次为单位决定“画或不画”,就可能把大量不可见实例也提交给 GPU。此时减少的 CPU 开销,可能被额外的 GPU 工作抵消。
用一个成本模型看批次大小
可以把一帧中与实例化相关的成本粗略拆成批次提交成本、实例数据处理成本和实际绘制成本。下面的 Python 程序不是 GPU 真实性能模型,而是用来观察“批次过小”和“批次过大”两种极端。
import math

TOTAL_INSTANCES = 10_000
VISIBLE_RATIO = 0.2
DRAW_CALL_COST = 8.0
INSTANCE_COST = 0.01

for batch_size in (50, 200, 1000, 5000):
    batches = math.ceil(TOTAL_INSTANCES / batch_size)
    visible_batches = math.ceil(batches * VISIBLE_RATIO)
    submitted_instances = min(
        TOTAL_INSTANCES,
        visible_batches * batch_size,
    )
    cost = visible_batches * DRAW_CALL_COST + submitted_instances * INSTANCE_COST
    print(
        f"batch={batch_size:4d}, calls={visible_batches:3d}, "
        f"submitted={submitted_instances:5d}, cost={cost:6.1f}"
    )
预期输出:
batch=  50, calls= 40, submitted= 2000, cost= 340.0
batch= 200, calls= 10, submitted= 2000, cost= 100.0
batch=1000, calls=  2, submitted= 2000, cost=  36.0
batch=5000, calls=  1, submitted= 5000, cost=  58.0
这个结果只说明一个趋势:批次变大时,Draw Call 会减少,但当批次粗到无法精确剔除时,被提交的不可见实例可能突然增加。真实引擎还会受到顶点数、像素覆盖、实例缓冲区更新方式和驱动实现影响,因此最终批次大小必须以实际 Profiling 为准。
批次过大还会增加更新代价
如果实例数据每帧都变化,例如大量单位移动、颜色改变或动画参数更新,渲染器需要频繁写入实例缓冲区。一个超大缓冲区如果总是整体重建,会产生更多 CPU 拷贝和 GPU 传输;而分成多个稳定区域后,可以只更新发生变化的批次。
此外,批次的包围盒通常由其中全部实例共同决定。实例分布越分散,包围盒越大,剔除越容易失去精度。按空间区域、材质状态和更新频率进行分组,往往比简单追求“每批实例数最大”更可靠。
用数据找到合适的批次规模
调优时先观察 CPU 侧 Draw Call 与渲染提交耗时,再观察 GPU 帧时间、可见实例比例和实例缓冲区上传量。如果 CPU 明显受提交次数限制,可以适当增大批次;如果 GPU 在处理大量不可见对象,或批次包围盒总是覆盖很大范围,就应该提高剔除粒度。
实际项目里,先按材质和网格满足实例化条件,再按空间与更新频率拆成中等批次,通常比把整个场景塞进一个巨型实例列表更容易获得稳定性能。