
图形渲染与 Shader / 系统课时
每个实例的数据放在哪里
每个实例的数据放在哪里
确定哪些物体能够进入同一批之后,还要解决另一个问题:位置、颜色和自定义参数怎样从 CPU 送到 GPU,并让着色器准确读取当前实例的数据。本篇建立从 CPU 实例记录、GPU 缓冲区到 Shader 输入的完整对应关系。
学习目标
- 理解每实例数据在 CPU 与 GPU 两侧分别存放在哪里
- 区分实例顶点属性、缓冲区和普通 Uniform 的适用场景
- 根据数据大小与更新频率设计实例数据布局
实例数据通常经历两层存储
游戏逻辑首先在 CPU 内存中维护实例记录,例如世界矩阵、颜色和自定义参数。提交绘制前,渲染器把这些记录写入 GPU 可访问的缓冲区;实例化 Draw Call 执行时,着色器再根据当前实例编号或实例属性读取对应记录。
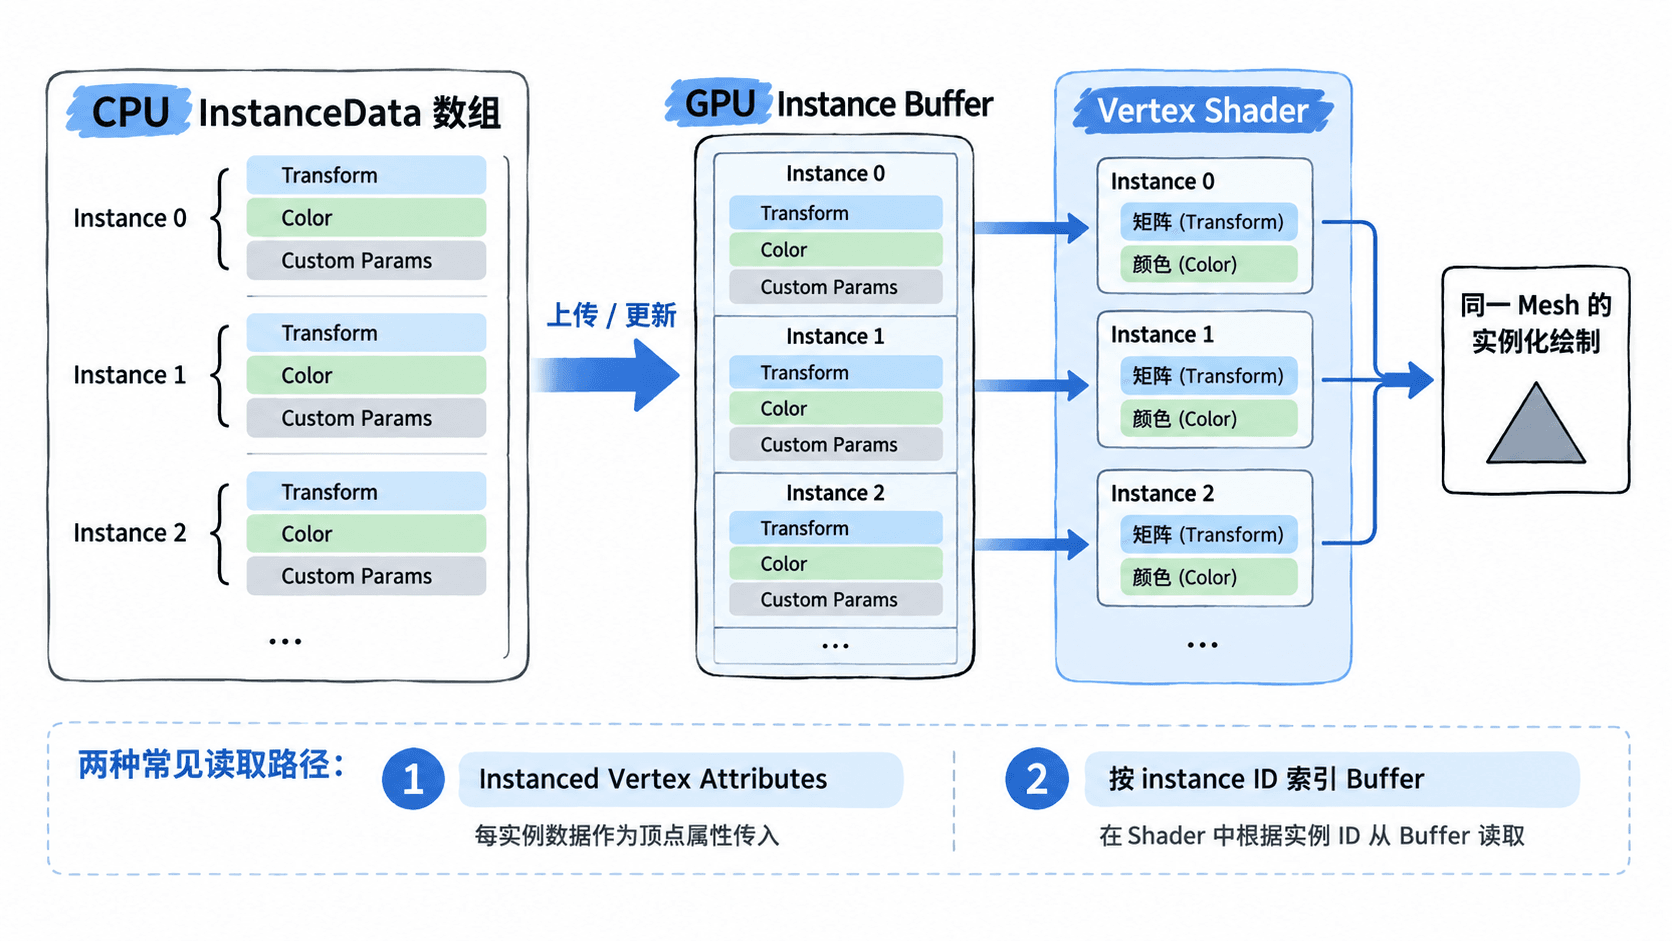
CPU 数组不是最终渲染数据本身,它更像渲染器的源数据。真正执行绘制时,GPU 需要从已经绑定的显存资源中读取,因此频繁修改实例属性时,上传策略和缓冲区布局会直接影响性能。
先设计一条实例记录
一种常见做法是把同一实例需要的数据放在连续结构中。下面的 C++ 示例定义一个包含模型矩阵、颜色和四个自定义浮点参数的记录,并计算单个实例占用的字节数。
#include <cstddef>
#include <iostream>

struct alignas(16) InstanceData {
    float model[16];   // 4x4 模型矩阵
    float color[4];    // RGBA
    float custom[4];   // 由当前着色器约定含义
};

int main() {
    static_assert(sizeof(float) == 4, "This example expects 32-bit float.");
    std::cout << "instance stride = " << sizeof(InstanceData) << " bytes\n";
    std::cout << "1000 instances = "
              << sizeof(InstanceData) * 1000
              << " bytes\n";
}
预期输出:
instance stride = 96 bytes
1000 instances = 96000 bytes
这意味着 1000 个实例仅上述字段就需要约 96 KB 数据。数量继续增加后,真正需要关注的往往不是容量本身,而是每帧是否把整块数据重复上传。
GPU 端可以怎样读取
对于 OpenGL 一类图形 API,小而固定的实例字段可以使用实例化顶点属性,并通过 glVertexAttribDivisor 让属性每个实例更新一次,而不是每个顶点更新一次。矩阵通常拆成四个 vec4 属性,因为一个 mat4 会占用四个连续属性位置。
下面是片段示例,需要放在已经创建 OpenGL 上下文、配置 VAO/VBO 并执行实例化绘制的工程中。它展示 Shader 侧如何接收矩阵与颜色,不是可独立运行程序。
#version 330 core

layout(location = 0) in vec3 aPosition;
layout(location = 4) in mat4 instanceModel;
layout(location = 8) in vec4 instanceColor;

uniform mat4 uViewProjection;
out vec4 vColor;

void main() {
    gl_Position = uViewProjection
                * instanceModel
                * vec4(aPosition, 1.0);
    vColor = instanceColor;
}实际配置顶点属性时,instanceModel 对应的四列都需要设置 divisor 为 1,颜色属性也同样设置。这样 GPU 在绘制一个实例的所有顶点期间保持同一份实例值,进入下一个实例后再推进到下一条记录。
数据更多时不要全塞进顶点属性
实例化顶点属性适合矩阵、颜色等数量固定且规模较小的数据,但顶点属性位置数量有限。若每个实例需要大量参数,现代渲染器通常会考虑结构化缓冲区、Shader Storage Buffer 等资源,再通过实例编号索引自己的记录。
普通 Uniform 更适合一次 Draw Call 中所有实例共享的数据,例如相机矩阵或全局光照参数。虽然 Uniform 数组也能保存少量实例数据,但容量和索引能力受图形 API 与硬件限制,不适合作为大批量实例数据的默认方案。
更新频率决定是否拆开缓冲区
如果模型矩阵每帧变化,而颜色几分钟才变化一次,把两者塞进同一个缓冲区会导致更新矩阵时连同静态颜色一起重写。数据规模较大时,可以按照更新频率拆成不同缓冲区,让动态部分高频更新,稳定部分长期保留。
还要避免把所有游戏逻辑字段直接复制到实例结构中。CPU 上的对象可能包含名称、状态机、碰撞数据和脚本引用,但 GPU 只需要真正参与着色计算的紧凑数据。实例记录越明确,上传带宽、显存占用和 Shader 接口就越容易控制。
最终可以用三个问题检查布局是否合理:Shader 是否真的需要这个字段、它多久改变一次、是否必须为每个实例保存独立值。回答清楚这三点,实例矩阵、颜色和自定义参数应该放在哪里通常也就确定了。