
图形渲染与 Shader / 系统课时
怎样设计可扩展的实例渲染系统
怎样设计可扩展的实例渲染系统
真正难维护的不是“把一次绘制变成实例化”,而是当模型、材质、剔除、LOD、平台能力和调试指标同时变化时,系统仍能稳定扩展。本课把这些职责拆成清晰边界,并用一个最小数据模型演示如何避免把业务逻辑塞进渲染提交代码。
学习目标
- 能把资源、实例数据、剔除、批次构建和绘制后端拆成独立职责
- 能为实例数据设计稳定的批次键,避免无意中破坏合批
- 能用平台能力开关和运行时指标控制降级与排查
先把系统边界拆开
实例渲染系统适合按“准备数据”和“提交绘制”分层。资源层只关心网格、材质和纹理引用;实例层保存每个对象的位置、旋转、缩放及自定义参数;剔除层决定哪些实例可见;批次层把兼容实例分组;绘制后端再根据平台能力选择普通实例化或间接绘制。
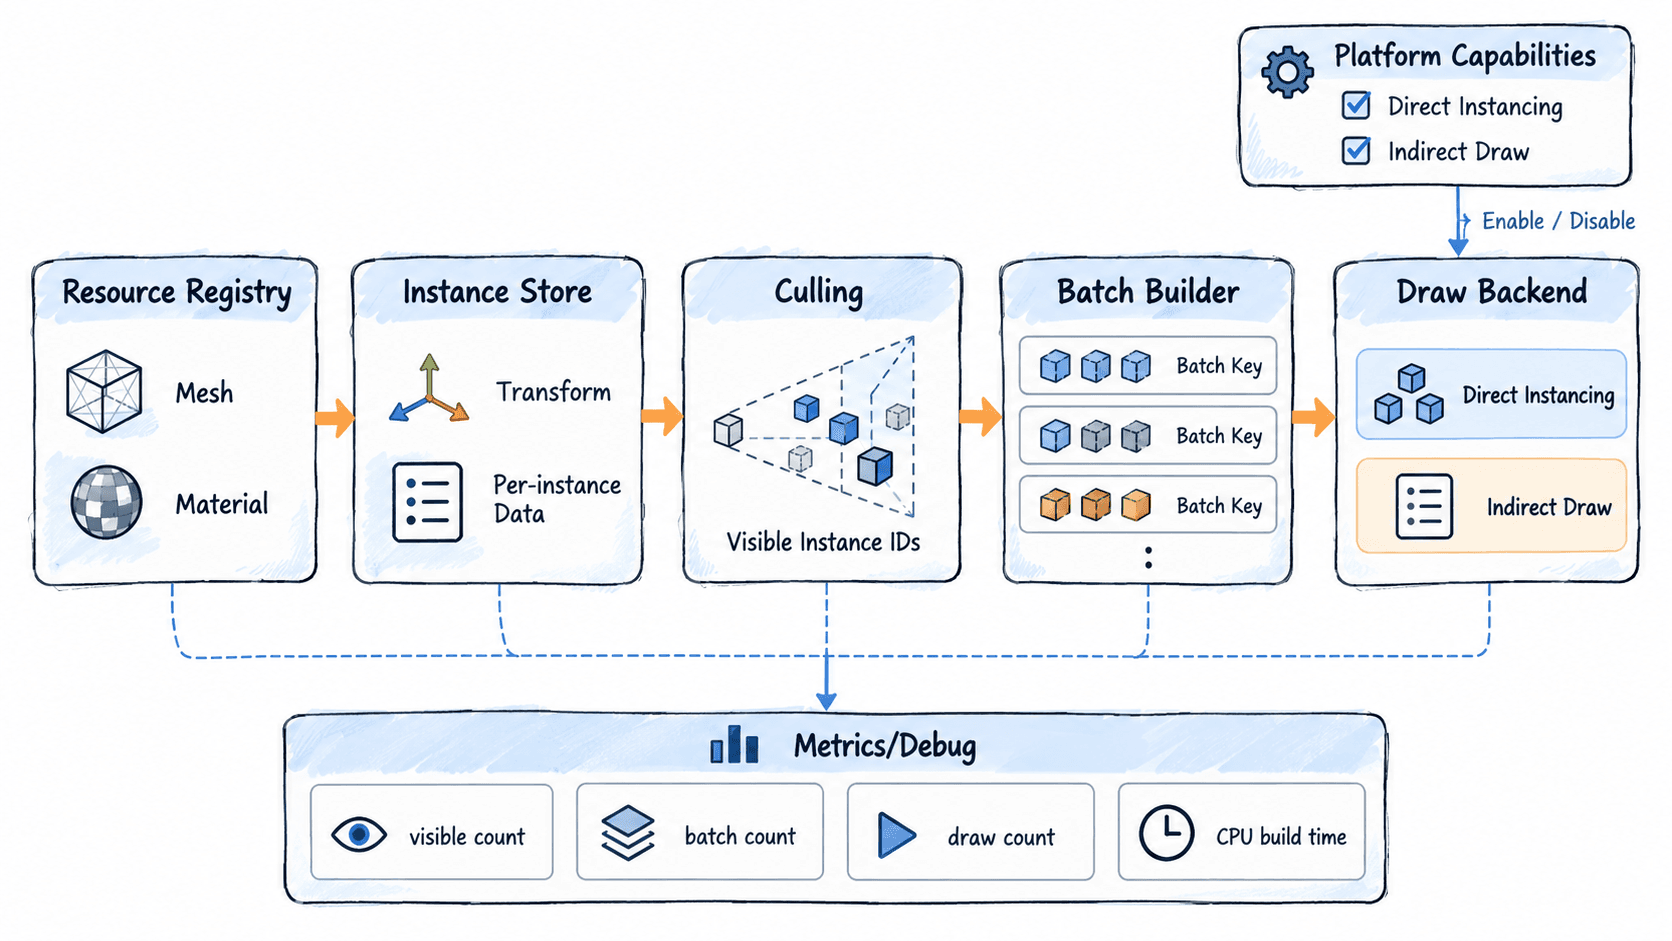
这样拆分后,新增一种剔除算法时不需要修改材质资源管理;新增平台降级策略时,也不需要改实例数据格式。边界的价值不是类越多越好,而是让“谁决定可见、谁决定能否合批、谁负责真正绘制”三个问题各有唯一答案。
用稳定的批次键组织实例
一个批次至少要保证网格、材质及渲染状态兼容。不要把世界坐标、对象 ID 这类每实例变化的数据放进批次键,否则每个对象都会形成独立批次。相反,它们应进入实例缓冲区,由同一个批次统一上传。
下面的 C# 控制台示例用 BatchKey 把实例按网格和材质分组,并模拟平台不支持实例化时的降级。代码可直接放进 .NET 6+ 控制台项目运行。
using System;
using System.Collections.Generic;
using System.Linq;

record BatchKey(string Mesh, string Material);
record Instance(int Id, BatchKey Key, bool Visible);

class Program
{
    static void Main()
    {
        bool supportsInstancing = true;

        var instances = new List<Instance>
        {
            new(1, new("TreeA", "LeafMat"), true),
            new(2, new("TreeA", "LeafMat"), true),
            new(3, new("TreeA", "LeafMat"), false),
            new(4, new("RockA", "RockMat"), true)
        };

        var visible = instances.Where(x => x.Visible).ToList();
        var batches = visible.GroupBy(x => x.Key).ToList();

        Console.WriteLine($"visible={visible.Count}");
        Console.WriteLine($"batches={batches.Count}");

        foreach (var batch in batches)
        {
            string mode = supportsInstancing && batch.Count() > 1
                ? "Instanced"
                : "Single";
            Console.WriteLine($"{batch.Key.Mesh}/{batch.Key.Material}: {batch.Count()} -> {mode}");
        }
    }
}
预期输出:
visible=3
batches=2
TreeA/LeafMat: 2 -> Instanced
RockA/RockMat: 1 -> Single这个例子故意把“是否可见”和“是否能合批”分成两个阶段。真实项目中,Visible 会由视锥、遮挡、距离或 LOD 系统产生,而 BatchKey 还可能包含 shader variant、render queue、lightmap 或阴影状态,但原则不变:只把会影响绘制兼容性的字段放进去。
把实例数据当成版本化接口
实例数据一旦进入 GPU 缓冲区,就相当于 CPU 与 shader 之间的接口。常见字段包括变换矩阵、颜色、动画帧、LOD 索引或自定义参数。新增字段时应明确布局、默认值和版本,避免旧内容与新 shader 对不上。
若某些字段只有少量对象需要,不要轻易为全部实例扩大结构体。可以先判断它是否真的属于“每实例数据”,还是更适合拆成另一类批次。实例结构越宽,上传带宽和缓存压力越大,调试时也更难确认究竟是哪一个字段导致批次失效。
剔除与批次构建要能单独观测
只看 FPS 很难判断实例化系统是否有效。至少应持续记录可见实例数、批次数、实际 draw 数、CPU 批次构建耗时和实例缓冲上传量。出现性能回退时,先确认是“可见对象变多”,还是“同样对象被拆成更多批次”。
如果 CPU 剔除很贵,可以继续演进为空间分区、多线程剔除或 GPU culling;如果批次构建很贵,可以复用稳定批次并只更新脏实例。优化应发生在指标明确暴露瓶颈之后,而不是一开始就把所有逻辑搬到 GPU。
平台开关必须集中管理
不同平台对实例数量、缓冲区类型、间接绘制和 shader 功能的支持并不完全相同。平台判断应集中在能力层,由绘制后端读取统一结果,而不是散落在每个场景脚本里。
推荐把能力开关设计成“支持什么”,而不是“当前是什么平台”。例如 supportsInstancing、supportsIndirectDraw、maxInstancesPerBatch 比 isMobile 更稳定。这样新增设备或图形 API 时,只需要更新能力探测和默认配置,业务层仍然按同一套接口运行。
可扩展的实例渲染系统最终应允许资源、剔除策略、批次规则和绘制后端独立替换,同时还能用统一指标解释每次性能变化。做到这一点,实例化才不只是一次局部优化,而会成为可长期维护的渲染基础设施。