
图形渲染与 Shader / 系统课时
每帧更新十万实例会怎样
每帧更新十万实例会怎样
十万个实例能一次批量绘制,并不代表十万个实例的数据也适合每帧全部重写。真正的压力会同时落在 CPU 状态计算、内存写入、CPU 到 GPU 的数据传输以及资源同步上。本课先量化一次全量更新的成本,再判断哪些优化真正值得做。
学习目标
- 估算大规模实例全量更新产生的每帧数据量和持续带宽
- 区分 CPU 计算、内存拷贝、GPU 上传与同步造成的不同瓶颈
- 使用脏数据、冷热拆分和环形缓冲等策略降低更新成本
先算清楚一帧到底搬多少数据
假设每个实例记录为 64 字节,十万个实例全量更新一次就是 6.4 MB。以 60 FPS 持续运行时,仅按一次线性写入计算,每秒就要处理 384 MB 实例数据;如果单实例扩大到 128 字节,数据量会直接翻倍。
下面的 Python 程序可以用来快速计算不同实例大小下的理论数据量。它只统计原始实例字节,不包含驱动内部复制、缓存失效或额外 staging 过程。
def print_cost(instance_count: int, bytes_per_instance: int, fps: int) -> None:
    bytes_per_frame = instance_count * bytes_per_instance
    mb_per_frame = bytes_per_frame / 1_000_000
    mb_per_second = mb_per_frame * fps
    print(f"{bytes_per_instance} B -> {mb_per_frame:.2f} MB/frame, {mb_per_second:.0f} MB/s")


def main() -> None:
    for size in (64, 128):
        print_cost(100_000, size, 60)


if __name__ == "__main__":
    main()
预期输出:
64 B -> 6.40 MB/frame, 384 MB/s
128 B -> 12.80 MB/frame, 768 MB/s
这些数字并不能直接等同于显存总线占用,因为具体图形 API、内存类型和驱动实现不同。但它们足以说明:当实例记录变大或更新次数增加时,全量更新的成本会以非常直接的方式增长。
一次更新实际经过的不只是 GPU 上传
游戏逻辑通常先在 CPU 上计算位置、动画状态或可见性,再把结果写入连续实例数组,随后交给图形 API 使用。某些实现还会经过映射内存、上传缓冲区或内部复制,GPU 最后才能消费这些数据。
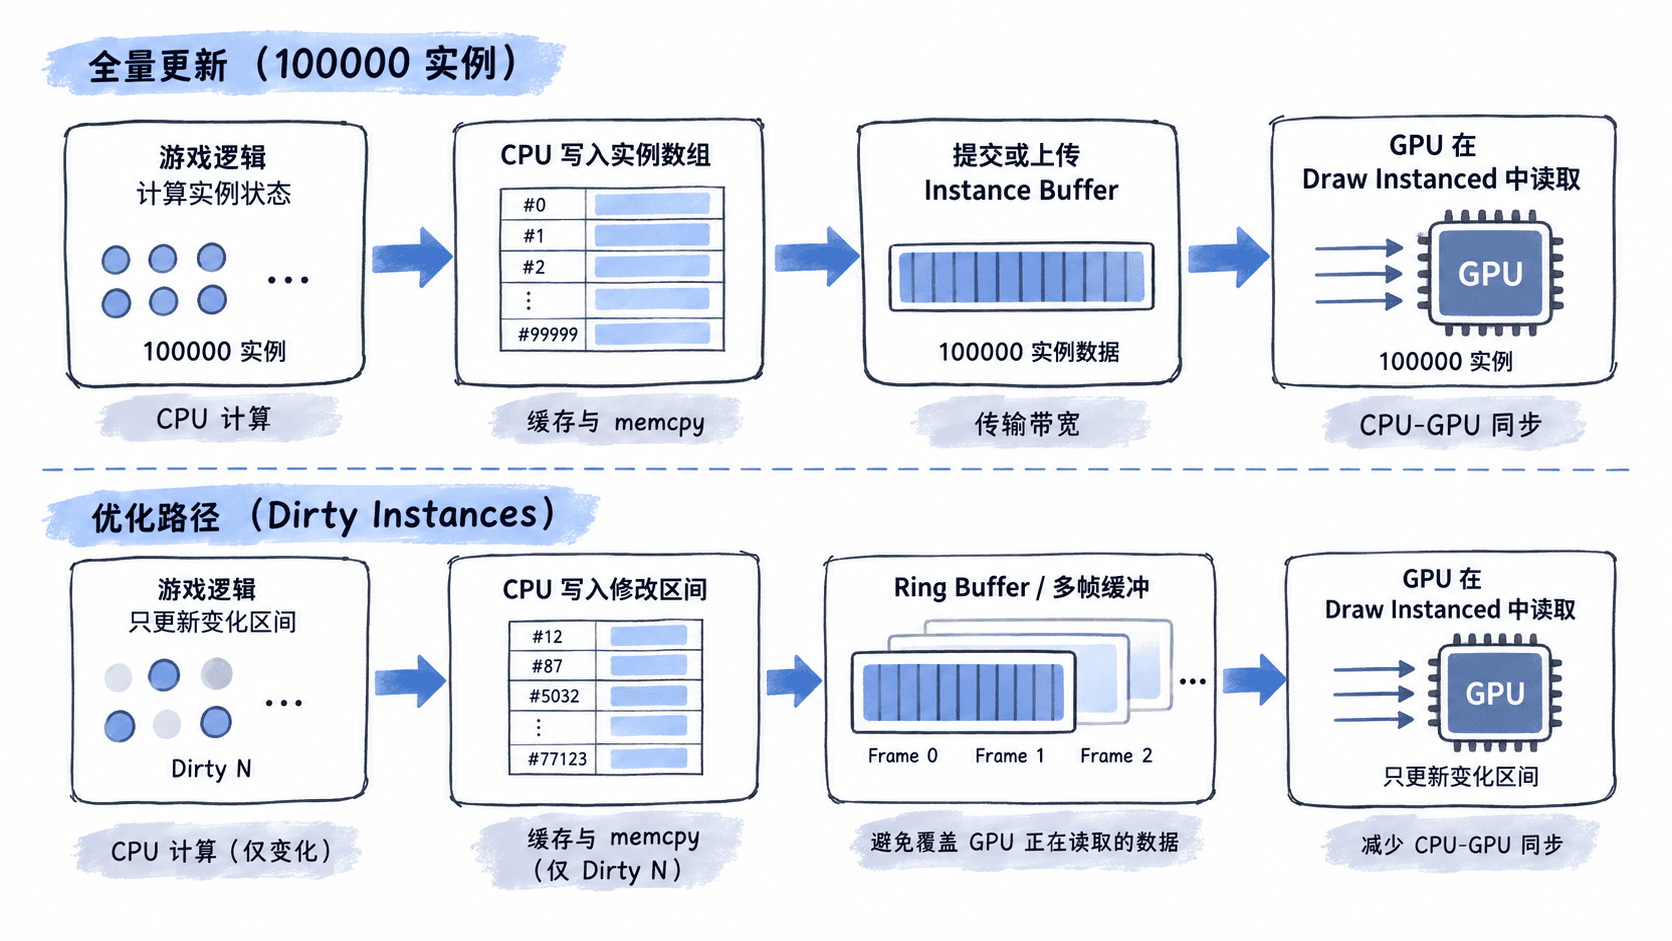
因此看到帧时间升高时,不能只说“GPU 上传太慢”。如果十万个对象的世界矩阵本身由复杂层级关系计算得到,瓶颈可能已经发生在生成实例数组之前;如果 CPU 等待 GPU 使用完旧缓冲区后才能覆盖数据,问题又会表现为同步停顿。
不变的实例就不要重复写
最直接的优化是记录脏实例。只有 Transform、颜色或其他 GPU 可见属性真的发生变化时,才把对应记录标记为 Dirty,然后更新变化区域。如果十万个实例中一帧只有五千个移动对象,理论更新数据量就可能从 6.4 MB 降到约 0.32 MB。
但脏更新也有边界。如果 Dirty 实例在缓冲区里非常分散,为几万个小区间分别发起更新可能比一次连续复制更贵。常见做法是先排序或合并相邻区间;当脏数据比例超过某个通过实测确定的阈值时,直接退回全量连续更新。
另一种有效方法是把数据按更新频率拆开。例如每帧只上传 48 字节 Transform,而静态颜色和材质索引留在另一块缓冲区。十万个实例每帧就能少搬一部分数据,而且逻辑层也不必重新组装从未变化的字段。
避免 CPU 和 GPU 抢同一块内存
CPU 正准备写下一帧实例数据时,GPU 可能还在读取上一帧。如果直接反复覆盖同一片资源,图形 API 或驱动可能需要等待、重命名资源,或者通过其他机制保证读写安全。
常见策略是准备按帧轮换的缓冲区域,例如环形缓冲或多帧缓冲:CPU 写当前可用区域,GPU 读取此前提交的区域。这样会增加一定内存占用,但能降低生产者和消费者争抢同一段数据的机会。
具体需要两份、三份还是更大的环形区域,不能脱离目标 API 和引擎统一规定。关键原则是不要在 GPU 尚未消费完成时无条件覆盖它正在使用的数据,并通过 fence、frame resource 或引擎提供的同步机制确认资源生命周期。
十万实例不一定都该由 CPU 驱动
当绝大部分实例每帧都会变化时,脏标记已经难以减少数据量。这时应该进一步检查更新逻辑能否移到 GPU,例如由 Compute Shader 根据速度、时间或动画参数直接更新实例状态,CPU 只提交少量全局参数。
这种 GPU 驱动方案能够减少 CPU 到 GPU 的大规模状态搬运,但会提高 Shader、同步、可见性剔除和调试复杂度。对于只偶尔变化的大量场景物体,CPU 局部更新通常更简单;对于持续运动、粒子式或模拟式实例,GPU 更新才更可能体现优势。
面对十万级实例,优化顺序通常应从 缩小单实例记录、减少实际更新数量、让写入连续、避免资源争用 开始,再考虑把计算迁移到 GPU。先量化每帧真正变化的字节数,往往比单纯继续减少 Draw Call 更容易找到下一处性能瓶颈。