
图形渲染与 Shader / 系统课时
怎样用 Profiler 验证优化结果
怎样用 Profiler 验证优化结果
GPU Instancing 是否有效,不能只看“场景更流畅了”。可靠做法是固定场景与采样条件,分别记录优化前后的 CPU、GPU、批次和绘制事件,再确认实例化没有用更高带宽或额外准备开销换来表面收益。
学习目标
- 建立可重复的优化前后采样条件,避免用偶然帧下结论。
- 会从 CPU、GPU、批次、实例数量和带宽五类指标判断收益来源。
- 能用自定义 Profiler 标记与 Frame Debugger 证明实例化确实生效。
先固定对比条件
优化前后必须使用同一场景、相机路径、分辨率、质量等级和目标设备。关闭会改变负载的临时调试功能,先运行一段时间让着色器、资源和对象池进入稳定状态,再截取相同长度的稳定区间。不要拿编辑器里的一帧去和真机上的另一帧比较。
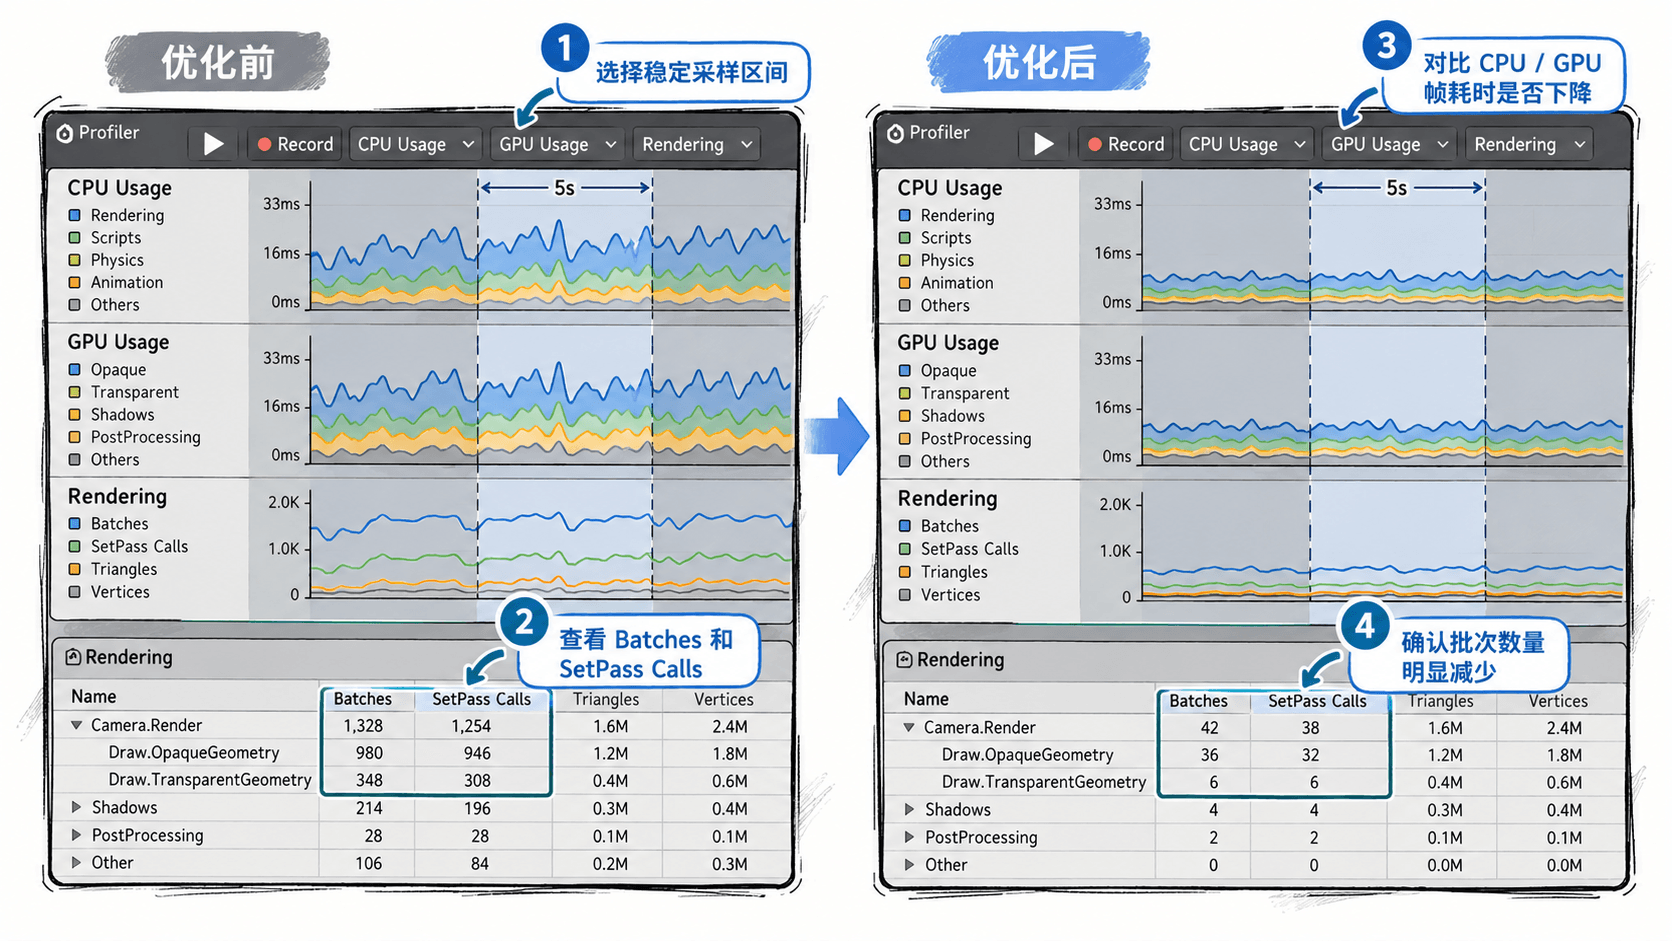
对比时优先记录帧时间而不是 FPS。FPS 是帧时间的倒数,数值越高越容易放大小幅波动;CPU Main Thread、Render Thread 与 GPU Frame Time 更适合判断瓶颈究竟落在哪一侧。
记录一张可复核的基线表
建议每轮采样都填写同一张表,至少保留稳定区间的典型值和异常峰值。指标名称在不同 Unity 版本、渲染管线或平台工具中可能略有不同,因此重点是保持两次采样口径一致。
| 指标 | 优化前 | 优化后 | 主要判断 |
|---|---|---|---|
| CPU Main Thread | <记录值> |
<记录值> |
脚本与提交渲染命令是否下降 |
| CPU Render Thread | <记录值> |
<记录值> |
绘制提交压力是否下降 |
| GPU Frame Time | <记录值> |
<记录值> |
GPU 是否真正变快 |
| Batches / Draw Events | <记录值> |
<记录值> |
绘制提交是否减少 |
| 每次实例化绘制的实例数 | <记录值> |
<记录值> |
是否把重复对象合并进实例化绘制 |
| GPU 带宽相关计数 | <记录值> |
<记录值> |
顶点、实例数据或纹理访问是否造成新瓶颈 |
用自定义标记隔离 CPU 准备成本
实例化减少 Draw Call,不代表 CPU 端完全没有代价。矩阵更新、可见性筛选和实例属性准备都可能消耗主线程时间。下面的组件用 ProfilerMarker 包住矩阵准备逻辑,便于在 CPU Profiler 中单独观察。
using Unity.Profiling;
using UnityEngine;

public class InstancingProfilerSample : MonoBehaviour
{
    private static readonly ProfilerMarker PrepareMatricesMarker =
        new ProfilerMarker("Instancing.PrepareMatrices");

    [SerializeField] private Transform[] targets;
    private Matrix4x4[] matrices;

    private void Awake()
    {
        matrices = new Matrix4x4[targets.Length];
    }

    private void Update()
    {
        // 单独测量实例矩阵准备,避免和其他 Update 逻辑混在一起。
        using (PrepareMatricesMarker.Auto())
        {
            for (int i = 0; i < targets.Length; i++)
            {
                matrices[i] = targets[i].localToWorldMatrix;
            }
        }
    }
}
预期结果
CPU Profiler 的 Timeline 或 Hierarchy 中出现:
Instancing.PrepareMatrices

其耗时会随实例数量、矩阵更新频率和目标设备变化。
这个标记只证明 CPU 准备阶段花了多少时间,不证明 GPU Instancing 已经发生。它的价值是防止“Draw Call 降了,但主线程准备成本反而升高”被平均帧率掩盖。
再确认实例化绘制真的发生
打开 Frame Debugger 或平台对应的帧捕获工具,定位重复物体的绘制事件。优化前通常能看到大量相似的独立绘制;实例化生效后,应出现更少的绘制事件,并能确认一次绘制携带多个实例。具体事件名称会随 Unity 版本和渲染管线变化,不要只依赖字符串标签判断。
如果 Batches 明显下降,但 GPU Frame Time 没下降,要继续看瓶颈是否已经转移到像素填充、顶点处理、阴影或带宽。如果 CPU 下降而 GPU 不变,说明优化主要减轻了提交开销;如果 CPU 与 GPU 都下降,才是更完整的收益。
用同一规则给出结论
最终结论应回答三个问题:瓶颈原来在哪里、哪个指标真正改善、是否出现新的代价。一次有效的 Instancing 优化,通常至少能在批次或渲染提交开销上看到一致变化,同时没有明显增加矩阵准备、实例属性上传或 GPU 带宽压力。
不要以“Draw Call 越少越好”作为唯一标准。真实项目里最有价值的结果,是在同一工作负载下缩短目标瓶颈对应的帧时间,并且这种变化在多次稳定采样中都能复现。