
容器与云原生 / 系统课时
模拟数据库连接故障
模拟数据库连接故障
数据库连接失败时,最容易浪费时间的是直接重启所有容器。本节用一个可重复的 Compose 实验主动写错数据库主机名,再按“状态 → 日志 → 生效配置 → 容器网络”的顺序定位,并在不重建数据库数据的前提下恢复应用连接。
学习目标
- 主动制造并识别数据库主机名配置错误。
- 使用 Compose 状态、日志和渲染后的配置缩小故障范围。
- 用服务名验证容器网络连通性,并通过重新创建应用容器完成修复。
准备一个可重复的故障场景
先建立空的独立实验目录,在其中保存下面的 compose.yaml。示例要求支持 up --wait 的 Compose 插件和可用的 Docker Engine;环境中的演示账号仅供本地实验。下面的配置使用 PostgreSQL 同时充当数据库和连接探针。app 服务每两秒执行一次 pg_isready,因此无需编写业务代码也能观察连接成功与失败。DB_HOST 默认指向 Compose 服务名 db;命令中的 DB_HOST 变量前缀 用双美元符号把变量展开留给容器内的 shell,而不是让 Compose 提前插值。
services:
  db:
    image: postgres:17
    environment:
      POSTGRES_USER: appuser
      POSTGRES_PASSWORD: apppass
      POSTGRES_DB: appdb
    healthcheck:
      test: ["CMD-SHELL", "pg_isready -U appuser -d appdb"]
      interval: 2s
      timeout: 2s
      retries: 10

  app:
    image: postgres:17
    environment:
      DB_HOST: ${DB_HOST:-db}
    command:
      - sh
      - -c
      - |
        while true; do
          pg_isready -h "$$DB_HOST" -p 5432 -U appuser
          sleep 2
        done
    depends_on:
      db:
        condition: service_healthy
两个服务未显式声明网络时会加入同一个 Compose 默认网络。容器之间应使用服务名 db 和容器端口 5432 通信,不需要把 PostgreSQL 端口发布到宿主机。验证方法是先让 app 连接 db,再只修改 DB_HOST 并重新创建 app。
制造故障并按证据定位
以下命令从健康状态开始,把主机名改成不存在的 missing-db。为了避免 docker compose up 的创建信息干扰观察,成功路径的启动输出被重定向,只保留诊断证据。
# 清除当前 Shell 的同名变量,避免它优先覆盖实验 .env。
unset DB_HOST
printf 'DB_HOST=db\n' > .env
docker compose up -d --wait >/dev/null
sleep 3
docker compose logs --no-log-prefix --tail=1 app

printf 'DB_HOST=missing-db\n' > .env
docker compose up -d --no-deps --force-recreate app >/dev/null
sleep 3

docker compose ps --status running --services | sort
docker compose logs --no-log-prefix --tail=1 app
docker compose config | grep 'DB_HOST:' | sed 's/^[[:space:]]*//'
docker compose exec app pg_isready -h db -p 5432 -U appuser

printf 'DB_HOST=db\n' > .env
docker compose up -d --no-deps --force-recreate app >/dev/null
sleep 3
docker compose logs --no-log-prefix --tail=1 app
预期输出
db:5432 - accepting connections
app
db
missing-db:5432 - no response
DB_HOST: missing-db
db:5432 - accepting connections
db:5432 - accepting connections这里最关键的证据不是“容器是否在运行”,而是几条信息能否互相印证:app 仍在运行,日志却持续指向 missing-db;渲染后的 Compose 配置也显示错误主机名;与此同时,从同一个 app 容器访问正确服务名 db 成功。这样就能把根因收敛到应用连接配置,而不是数据库进程或 Compose 网络本身。
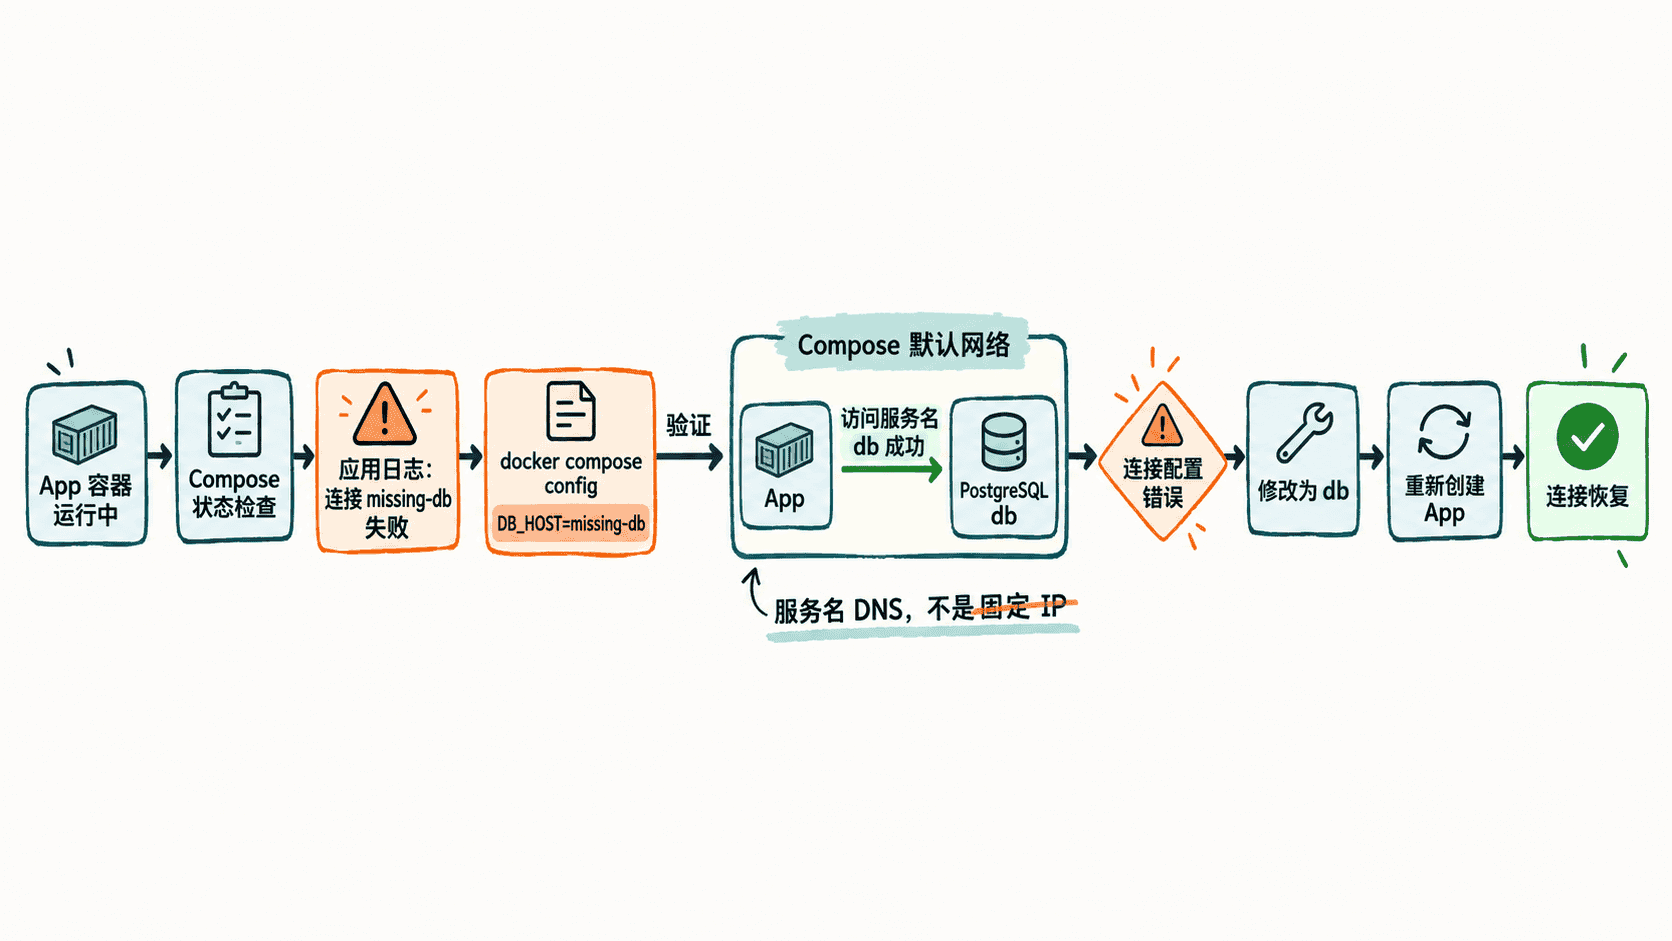
这里的 pg_isready 只说明服务器是否响应连接探测,不能证明密码正确、应用有查询权限或事务成功。示例把故障限定在主机名,因此正确主机探测成功足以缩小范围;实际应用还需使用自己的连接串完成一次最小查询。
depends_on 的健康条件控制启动阶段的先后,并不会持续修复运行中的应用连接。日志采样也可能因调度出现不同的重复行,应观察目标主机与 accepting/no response 这两个证据,不把固定 sleep 当成生产环境的就绪保证。
为什么重启通常不是修复
如果 .env 或 Compose 配置已经改错,docker compose restart app 只会重启现有容器,不会用新的服务配置重新创建它。配置修正后应执行 docker compose up -d --no-deps --force-recreate app,让容器重新获得正确环境变量。
排查数据库连接故障时,可以先问四个问题:应用进程是否存活、日志实际连接到哪里、Compose 最终渲染出的配置是什么、同网络内能否用数据库服务名访问。四个证据按顺序核对,通常比反复重启整套系统更快,也能避免误删数据库卷或把网络问题误判成数据库故障。
演练结束后,在同一实验目录执行 docker compose down 清理本次容器与网络。不要在真实项目目录运行这组故障命令,也不要为了修复主机名错误使用删除数据卷的参数;连接配置修复不需要重新初始化数据库。