
容器与云原生 / 系统课时
启动顺序异常应该怎么排查
启动顺序异常应该怎么排查
当多服务项目“有的容器启动了,但应用仍不可用”时,最有效的方法不是反复重启,而是先确认故障发生在哪一层:Compose 配置、容器生命周期、依赖服务初始化,还是应用连接。本篇给出一条可重复的定位顺序。
学习目标
- 用 Compose 状态和日志区分容器启动失败、服务未就绪与应用连接失败
- 按固定顺序收集证据,避免只根据一条报错猜原因
- 根据故障所在阶段选择对应修复方式并完成验证
先把故障定位到一个阶段
启动顺序问题通常落在三个阶段。第一阶段是容器根本没有稳定运行,例如进程立即退出或持续重启;第二阶段是容器在运行,但内部服务仍在初始化或健康检查失败;第三阶段是依赖已经可用,但应用使用了错误的主机名、端口、凭据或连接参数。
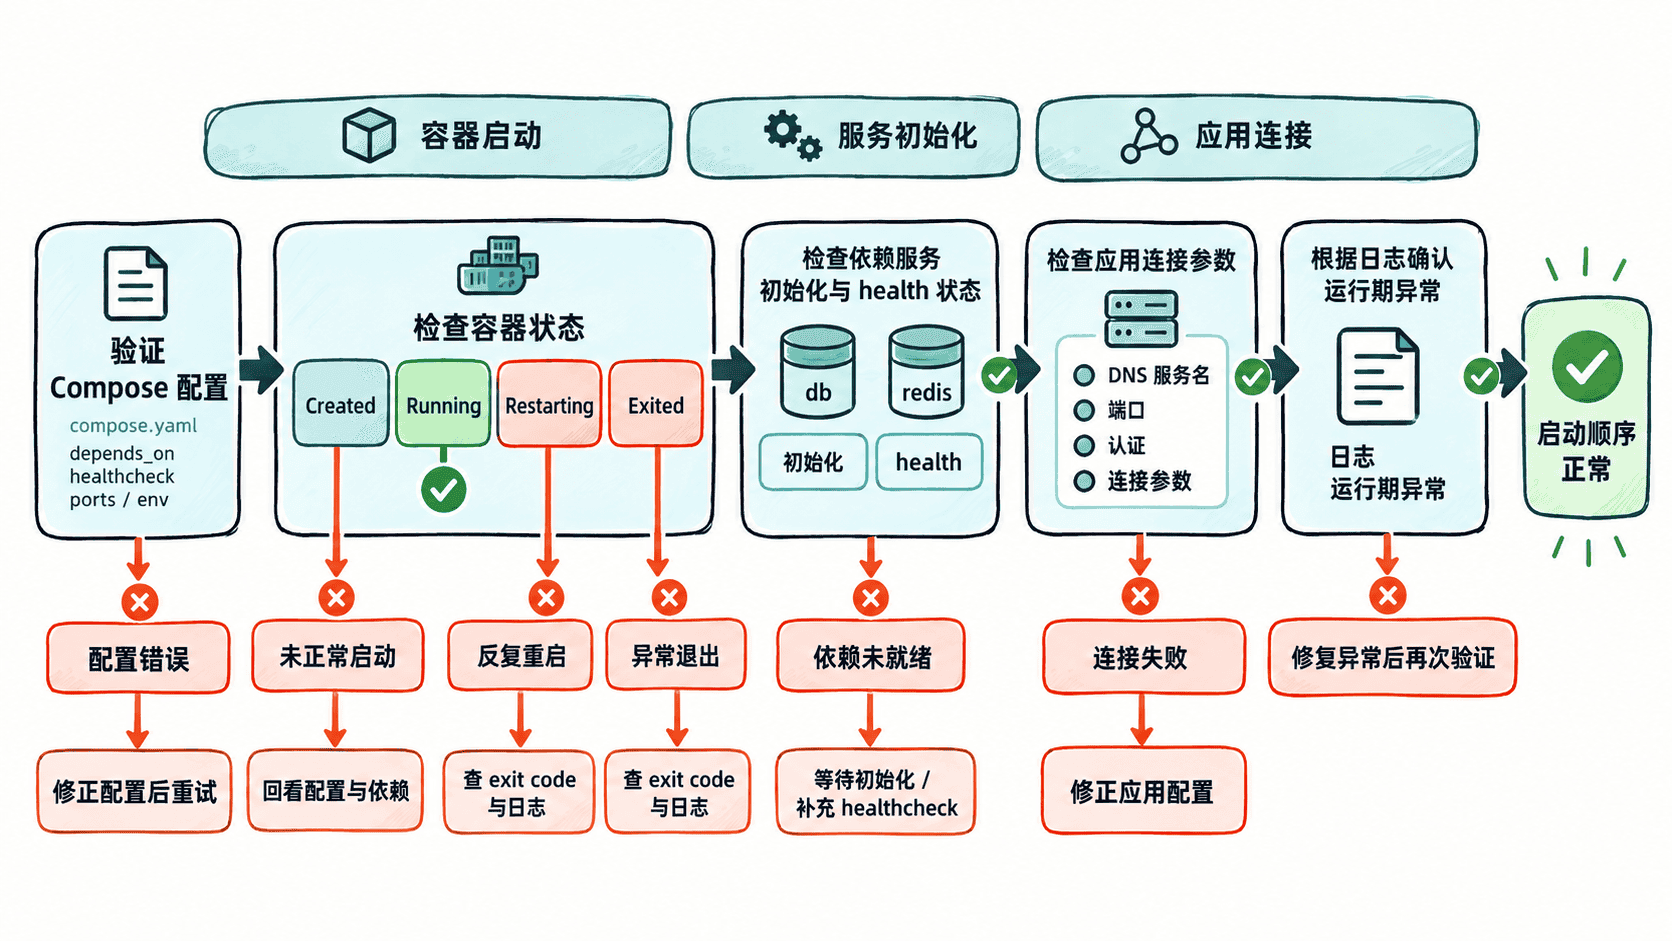
先验证配置和容器状态
从项目目录执行下面的检查。第一条只验证 Compose 配置;第二条列出包括已退出容器在内的状态;第三条读取最近日志,不主动重启任何服务,因此适合先取证再处理。
docker compose config --quiet && echo "compose-config=ok"
docker compose ps -a
docker compose logs --tail=80 --no-color
预期输出:
compose-config=ok
<docker compose ps -a 的服务状态列表>
<各服务最近 80 行日志,实际时间、容器名和日志内容因项目而异>
如果第一行没有出现 compose-config=ok,先修复 YAML、变量替换或 Compose 配置错误。配置通过后再看状态:Exited 或持续 Restarting 说明应先查容器进程为什么退出;容器保持 Running 但健康状态异常,则把注意力转向服务初始化与健康检查。
用日志判断是初始化慢还是应用连错
日志要按时间关系阅读,而不是只搜最后一条 error。先找依赖服务何时开始监听或报告 ready,再找应用第一次连接的时间。如果应用报连接拒绝发生在依赖 ready 之前,问题更像启动竞争;如果依赖已经 ready,应用仍持续失败,就继续检查服务名、端口、账号、数据库名或协议参数。
Compose 默认网络中,服务之间通常应该使用服务名通信,而不是写死某个容器 IP。容器 IP 可能随重建而变化;把 localhost 写进应用配置也很常见但容易出错,因为容器内的 localhost 指向应用容器自己,不是另一个服务。
根据阶段修复并再次验证
如果容器立即退出,优先修复入口命令、缺失文件、权限或必需环境变量;如果依赖初始化较慢,完善它的健康检查并让上游等待健康状态;如果应用连接参数错误,修正服务名、端口或凭据;如果只是短暂不可用,则让应用使用有上限的退避重试。
修复后重新启动服务并立即复查状态与日志:
docker compose up -d
docker compose ps -a
docker compose logs --tail=40 --no-color
预期输出:
<服务被创建或启动的 Compose 输出>
<服务状态列表,目标服务应保持运行且不持续重启>
<最近日志,依赖就绪后应用应不再持续重复连接失败>
不要只以“容器是 Running”作为验收标准;真正的完成条件是依赖健康、应用连接成功,并且日志中不再出现持续重启或重复连接失败。