
容器与云原生 / 系统课时
Healthcheck 怎样判断服务 Ready
Healthcheck 怎样判断服务 Ready
Healthcheck 的价值不是证明“进程还在”,而是把服务是否具备最低业务能力变成一个可重复执行的探针。数据库可以检查是否接受连接,HTTP 服务可以请求专用就绪端点;Compose 再把探针结果记录为 starting、healthy 或 unhealthy,供启动顺序和排障使用。
学习目标
- 为数据库和 HTTP 服务编写有业务意义的健康检查
- 理解
test、interval、timeout、retries与start_period - 观察服务从健康到不健康再恢复的状态变化
Healthcheck 判断的是命令退出状态
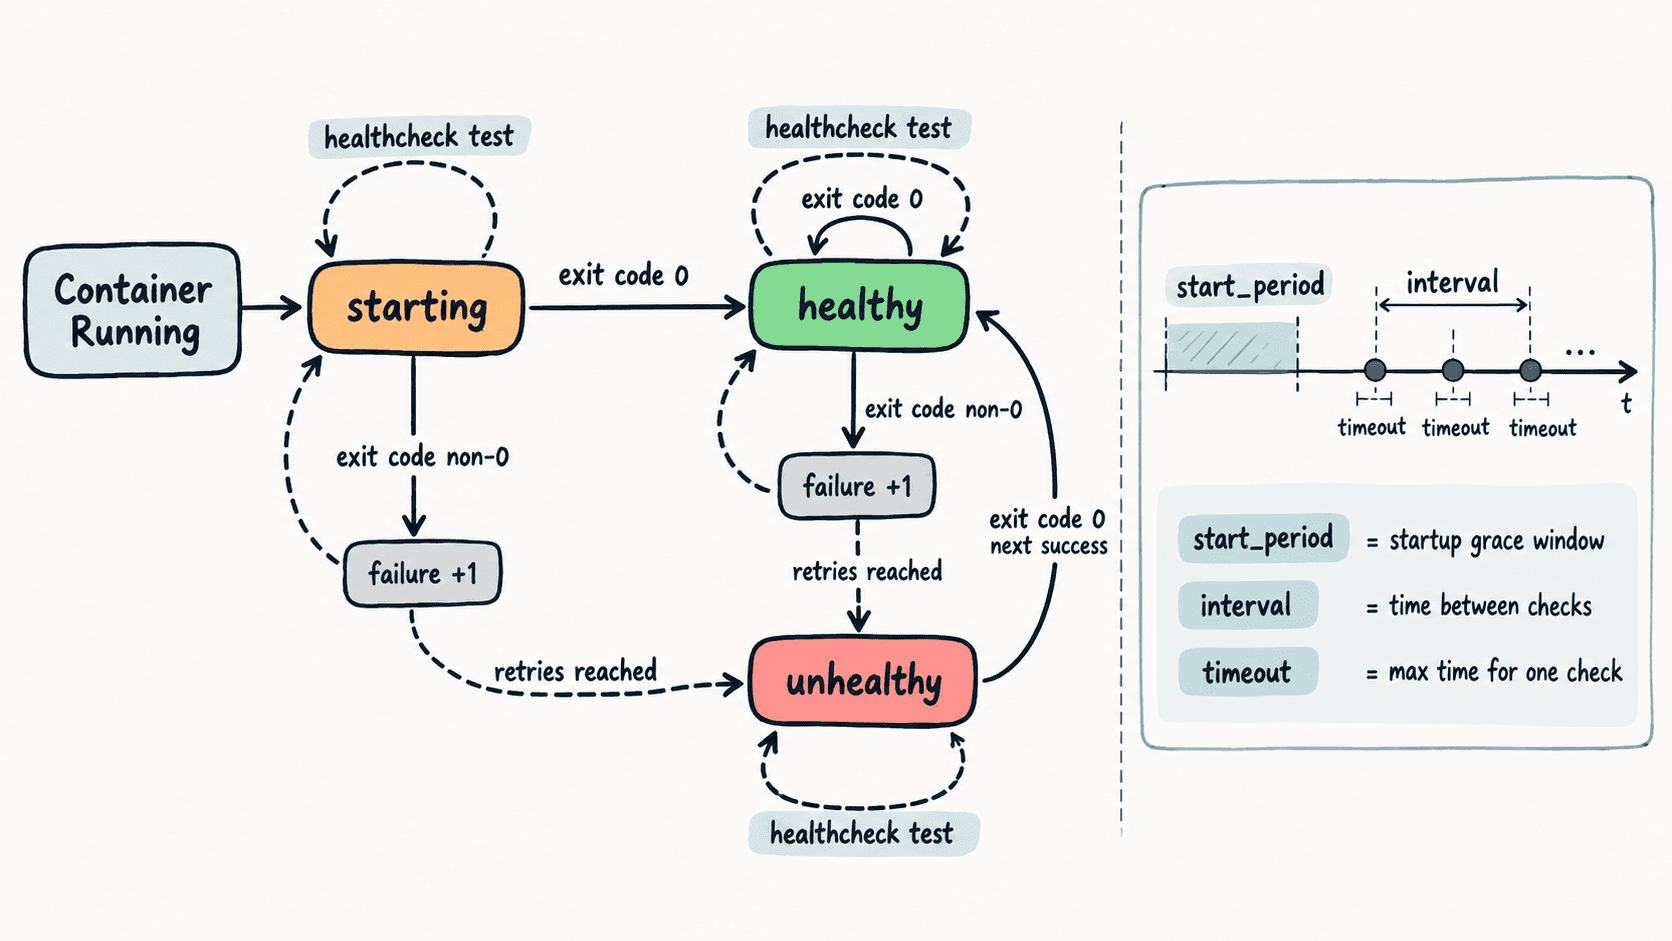
每次健康检查都会在容器环境中执行 test。检查命令返回 0 表示本次成功,非 0 表示失败;容器刚启动时通常处于 starting,成功后转为 healthy,连续失败达到阈值后变为 unhealthy。健康状态是容器状态的补充,不等同于容器是否仍在运行。
一个好的探针应直接验证服务承诺的最低能力。例如 PostgreSQL 用 pg_isready 检查接受连接,HTTP 应用请求 /ready 并要求返回成功状态。仅检查 PID、进程名或端口进程是否存在,通常不足以证明请求真的能被处理。
为数据库和 HTTP 服务定义检查
下面的 compose.yaml 同时定义 PostgreSQL 和一个最小 Nginx HTTP 服务。数据库探针检查连接能力,HTTP 探针请求专用 /ready 路径,避免用“进程存在”代替服务可用。
services:
  db:
    image: postgres:18
    environment:
      POSTGRES_DB: appdb
      POSTGRES_USER: app
      POSTGRES_PASSWORD: demo-pass
    healthcheck:
      test: ["CMD-SHELL", "pg_isready -U $${POSTGRES_USER} -d $${POSTGRES_DB}"]
      interval: 3s
      timeout: 2s
      retries: 5
      start_period: 10s

  web:
    image: nginx:alpine
    command:
      - /bin/sh
      - -c
      - echo ready > /usr/share/nginx/html/ready && exec nginx -g 'daemon off;'
    healthcheck:
      test: ["CMD-SHELL", "wget -q -O /dev/null http://127.0.0.1/ready"]
      interval: 3s
      timeout: 2s
      retries: 3
      start_period: 5s
test 定义真正执行的探针;interval 控制检查间隔;timeout 限制单次检查最长执行时间;retries 决定需要多少次连续失败才标记为不健康;start_period 给正常初始化留出宽限期,宽限期内的失败不会立即消耗正常重试预算。
启动并让 Compose 等到服务运行且健康:
docker compose up -d --wait --wait-timeout 60
docker inspect --format '{{.State.Health.Status}}' "$(docker compose ps -q db)"
docker inspect --format '{{.State.Health.Status}}' "$(docker compose ps -q web)"
预期输出:
healthy
healthy若首次拉取镜像耗时较长,实际总耗时会不同;--wait-timeout 60 中的 60 秒只限制等待服务进入运行或健康状态的阶段。
观察 unhealthy 与恢复
健康检查最有价值的地方之一,是服务进程没有退出时仍能暴露“已经不能正确响应”的状态。下面临时删除 Nginx 的 /ready 文件,让就绪端点返回失败;等待连续探测达到阈值后,再恢复文件。
docker compose exec web rm /usr/share/nginx/html/ready
sleep 10
docker inspect --format '{{.State.Health.Status}}' "$(docker compose ps -q web)"
docker compose exec web sh -c 'echo ready > /usr/share/nginx/html/ready'
sleep 4
docker inspect --format '{{.State.Health.Status}}' "$(docker compose ps -q web)"
预期输出:
unhealthy
healthy
这个实验说明 unhealthy 并不要求容器退出。Nginx 主进程始终可以继续运行,但就绪探针失败后,容器健康状态会独立变化;恢复就绪文件后,后续成功探测又会把状态改回 healthy。
参数应围绕真实故障窗口设置
健康检查参数没有通用的“最佳秒数”,应从服务启动时间和可接受的故障发现时间反推。
| 字段 | 主要问题 | 常见取舍 |
|---|---|---|
test |
什么才算 Ready | 应验证最低业务能力,且无副作用 |
interval |
多久检查一次 | 越短发现越快,但探针开销越高 |
timeout |
单次最多等多久 | 应短于正常请求超时,避免探针长期挂起 |
retries |
容忍几次连续失败 | 太小易抖动,太大则故障暴露变慢 |
start_period |
初始化要宽限多久 | 覆盖正常冷启动,不要用它掩盖永久失败 |
HTTP 服务最好提供专用的 /ready 或同等端点,只做快速、只读、可重复的必要检查。若这个端点同时串行访问很多下游系统,一次依赖抖动就可能把整条链路都标成不健康,反而降低诊断价值。
用 healthy 控制依赖启动
当另一个服务必须等待数据库 Ready 后才能启动,可以在依赖方使用长语法 depends_on。下面是片段示例,假设 db 已定义前面的健康检查。
services:
  app:
    image: your-app:<ID>
    depends_on:
      db:
        condition: service_healthy
生效后,Compose 会等待 db 进入 healthy,再创建并启动 app。不过,健康状态本身不会自动替应用设计运行期容错:服务启动后数据库仍可能发生重启、网络闪断或连接池失效,因此应用还需要合理的超时、重试和恢复策略。
Healthcheck 最适合回答一个具体问题:“如果现在把真实请求交给这个服务,它是否具备最低处理能力?”只要 test 围绕这个问题设计,healthy 才能成为启动顺序和排障中可信的 Ready 信号。